La captación de tráfico orgánico ya no está sujeta a la velocidad de redacción manual. En la publicación digital moderna, la visibilidad en buscadores exige exhaustividad semántica, densidad de entidades y una arquitectura de información sistemática. Desarrollar un pipeline editorial en torno al **AI writing** permite a equipos de ingeniería, directores de SEO y agencias escalar activos indexables bajo estándares técnicos estrictos.
Implementar modelos generativos para el crecimiento orgánico requiere mucho más que introducir prompts básicos en interfaces de consumo. Exige una infraestructura de nivel de producción: generación aumentada por recuperación (RAG) dinámica, validación programática de esquemas, extracción de entidades y postprocesamiento continuo.
—
Fundamentos Algorítmicos: Cómo Procesan los Motores de Búsqueda el Contenido Generado por IA
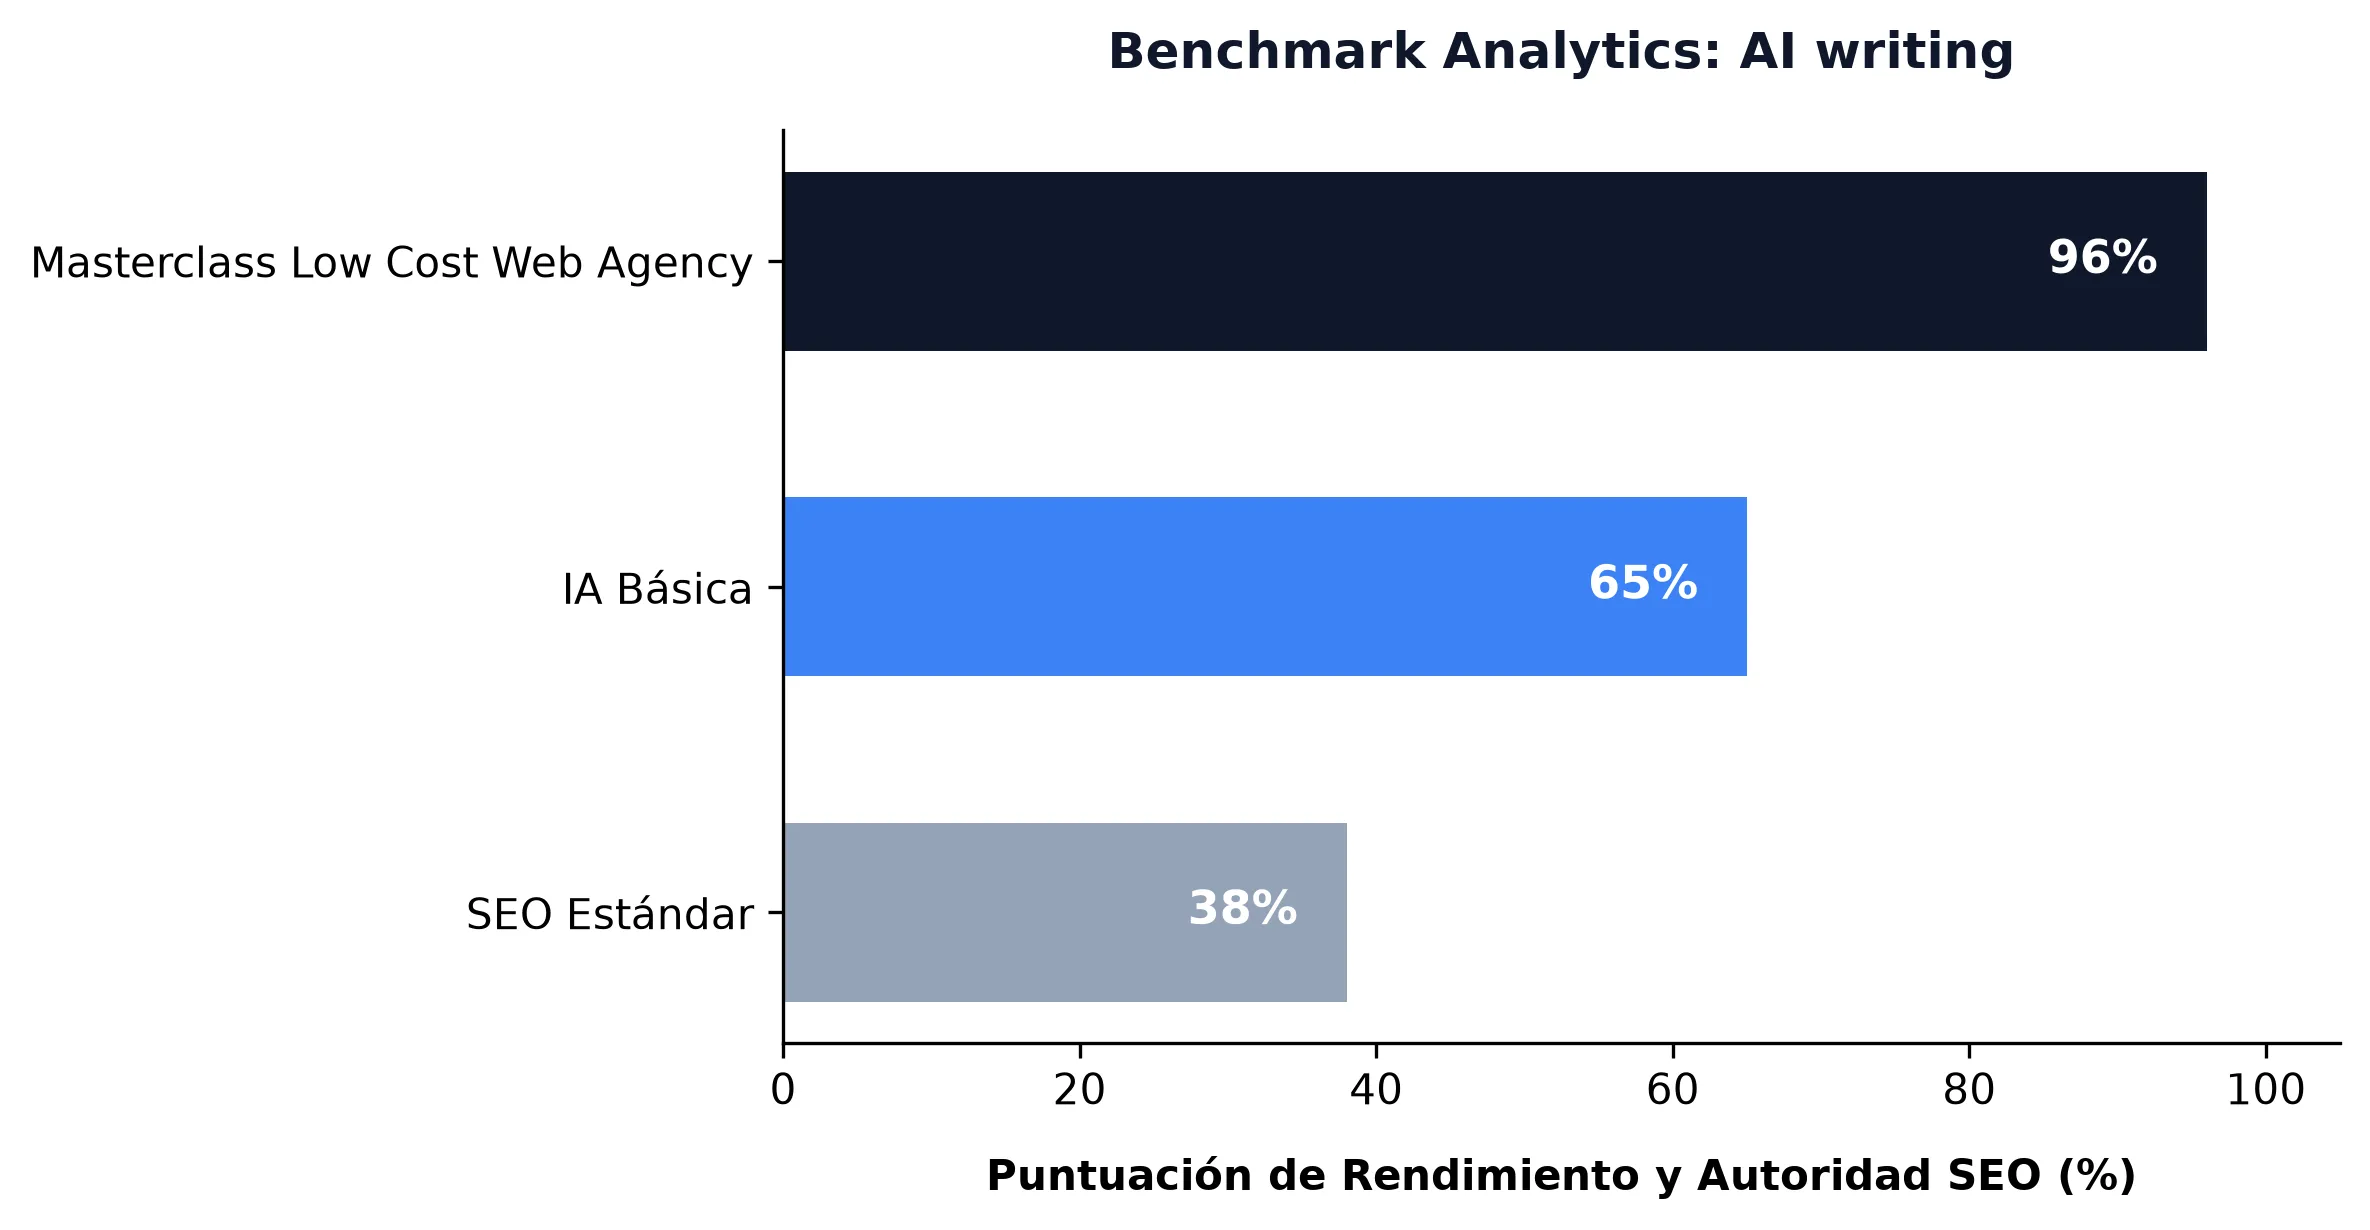
Para dominar las SERPs (páginas de resultados del buscador), los ingenieros deben comprender cómo evalúan los sistemas de recuperación de información (IR) los textos generados por máquinas. Los motores de búsqueda no penalizan el contenido simplemente porque un algoritmo haya estructurado las frases. Como documenta la documentación de Google Search Central sobre contenido útil, los sistemas de clasificación miden la utilidad, la precisión fáctica, la correlación de entidades y la resolución de la intención del usuario, sin importar el método de producción.
«`
+———————————————————+
| Parser de Búsqueda Moderno |
+———————————————————+
|
+——————+——————+
v v
+——————+ +——————–+
| Matching Léxico | | Búsqueda Vectorial |
| (BM25 / TF-IDF) | | (Embeddings / BERT)|
+——————+ +——————–+
| |
+——————+——————+
v
+———————————————————+
| Capa de Ganancia de Información y Coocurrencia |
+———————————————————+
|
v
+———————————————————+
| Cálculo del Rango en la SERP |
+———————————————————+
«`
1. Búsqueda Vectorial y Distancia Semántica
Los algoritmos tokenizan el texto y lo proyectan en espacios vectoriales multidimensionales. Modelos como BERT, MUM y sus equivalentes modernos de código abierto calculan la distancia semántica entre la consulta de búsqueda y los embeddings del documento.
El **AI writing** sin refinar suele presentar una predictibilidad excesiva (baja perplejidad y baja ráfaga o *burstiness*). Aunque una baja perplejidad aporta claridad, la uniformidad constante actúa como un indicador de texto genérico ante los clasificadores. Una implementación eficaz exige alternar la profundidad sintáctica e integrar terminología especializada para posicionar favorablemente el contenido en los análisis vectoriales densos.
2. Densidad de Entidades y Alineación con Grafos de Conocimiento
Los rastreadores ejecutan modelos de reconocimiento de entidades nombradas (NER) para extraer:
* Entidades primarias (conceptos base, marcas, tecnologías).
* Atributos secundarios (especificaciones, métricas, definiciones contextuales).
* Predicados relacionales (vínculos directos entre la entidad A y la entidad B).
Al estructurar contenido mediante flujos automatizados, el modelo debe recibir instrucciones para mapear estas entidades explícitamente. Una página técnica sobre arquitectura cloud, por ejemplo, debe anclar términos como *latencia, escalabilidad horizontal, nodos perimetrales* y *almacenamiento en caché distribuido* dentro de estructuras sintácticas directas y coherentes.
3. Puntuación de Ganancia de Información (Information Gain)
Las patentes de los principales motores de búsqueda cuantifican la «ganancia de información»: la diferencia neta de datos nuevos que aporta una URL frente a las páginas que el usuario ya ha consultado para ese mismo grupo de búsqueda. El contenido automatizado estándar se limita a sintetizar los diez primeros resultados, obteniendo una puntuación de ganancia de información prácticamente nula.
Los sistemas automatizados de alto rendimiento inyectan atributos de datos propios, cálculos especializados, métricas internas y casos de estudio reales directamente en el contexto del modelo, evitando el descarte algorítmico.
—
Arquitectura del Pipeline: Superando el Prompting Tradicional
Confiar en un único prompt para generar una página comercial completa produce prosa plana y sin opciones reales de clasificación. Los sistemas avanzados de **AI writing** operan mediante pipelines basados en grafos acíclicos dirigidos (DAG) en múltiples etapas.
«`
[Scraping de SERP y Extracción NER]
│
▼
[Análisis de Brechas Semánticas y Vectores]
│
▼
[Encadenamiento de Prompts en Múltiples Fases (DAG)] ──► [Inyección de Esquemas Estructurados]
│
▼
[Verificación Fáctica y Auditoría de Entidades]
│
▼
[Motor CMS en Producción / Edge CDN]
«`
Ingesta y Descomposición de la SERP
Antes de generar el primer token, el sistema automatizado extrae los documentos mejor posicionados para las consultas objetivo. Rutinas de procesamiento de lenguaje natural (NLP) descomponen estos textos para identificar:
* Jerarquías de encabezados predominantes (distribución de H2 y H3).
* Distribución estadística de entidades esenciales.
* Longitud media de los bloques de contenido por subtema.
* Dudas secundarias no resueltas en los módulos «Otras preguntas de los usuarios» (PAA).
Estos datos construyen un marco contextual dinámico que guía al LLM en cada fase de la generación.
Acondicionamiento Contextual y Encadenamiento de Prompts
En lugar de instruir al modelo para que redacte un artículo completo sobre un tema general, el flujo de trabajo fragmenta la tarea en llamadas secuenciales y especializadas:
1. **Fase de Arquitectura:** Genera una estructura JSON que mapea cada encabezado y su entidad correspondiente.
2. **Fase de Desarrollo:** Itera por secciones individuales, incorporando parámetros de investigación externos y datos programáticos.
3. **Fase de Síntesis:** Ajusta transiciones, calibra el tono técnico y asegura la coherencia terminológica global.
4. **Fase de Enriquecimiento:** Inyecta datos estructurados (esquemas JSON-LD, tablas comparativas y bloques de código).
Este enfoque modular refleja las estrategias analizadas en Ai-crafted content: the future of seo and web design mastery, donde la disciplina estructural sostiene el rendimiento orgánico.
—
Ejecución Técnica: Orquestación de Modelos para Máximo Rendimiento SEO
La selección de la familia de modelos define tanto los costes computacionales como la calidad del resultado. Las implementaciones a gran escala combinan modelos de frontera (como Claude 3.5 Sonnet o GPT-4o) con modelos abiertos autoalojados altamente optimizados (como Llama 3 o Mistral Large).
| Capa / Tarea | Tipo de Modelo Recomendado | Métrica Objetivo |
| :— | :— | :— |
| **Parsing de SERP y Extracción NER** | Modelos abiertos ligeros (Llama 3 8B, spaCy) | Velocidad, tratamiento determinista de tokens |
| **Planificación Estructural y Esquemas** | Modelos de frontera (GPT-4o, Claude 3.5 Sonnet) | Razonamiento relacional complejo, control contextual |
| **Redacción de Prosa Técnica** | Modelos de alta escala parametrizada | Control de perplejidad, riqueza léxica |
| **Validación de Código y Esquemas** | Motores especializados en código | Precisión sintáctica, validación JSON estricta |
Control de Salidas Deterministas mediante Esquemas JSON
Para transferir el texto generado directamente a bases de datos de CMS headless (como Strapi, Contentful o instancias de PostgreSQL), los pipelines deben aplicar el modo JSON o formatos estructurados garantizados por contrato de datos.
«`json
{
«$schema»: «http://json-schema.org/draft-07/schema#»,
«title»: «ArticlePayload»,
«type»: «object»,
«properties»: {
«title»: { «type»: «string», «maxLength»: 60 },
«meta_description»: { «type»: «string», «maxLength»: 155 },
«target_keyword»: { «type»: «string» },
«entities_covered»: {
«type»: «array»,
«items»: { «type»: «string» }
},
«sections»: {
«type»: «array»,
«items»: {
«type»: «object»,
«properties»: {
«heading»: { «type»: «string» },
«level»: { «type»: «integer», «minimum»: 2, «maximum»: 4 },
«body_markdown»: { «type»: «string» },
«key_takeaways»: {
«type»: «array»,
«items»: { «type»: «string» }
}
},
«required»: [«heading», «level», «body_markdown»]
}
}
},
«required»: [«title», «meta_description», «target_keyword», «sections»]
}
«`
La adopción de esquemas estrictos elimina fallos de formato, suprime preámbulos conversacionales innecesarios y garantiza datos normalizados listos para su compilación final.
Generación Precisa de Metadatos
Las etiquetas de título y las meta descripciones determinan directamente la tasa de clics (CTR) en los resultados de búsqueda. Dejar su redacción a resúmenes genéricos produce textos pasivos que reducen drásticamente la conversión de impresiones.
Los prompts del sistema deben configurarse para producir múltiples variantes evaluadas algorítmicamente según parámetros de CTR: uso de verbos activos, ubicación frontal de la palabra clave, inclusión de la marca y control exacto de caracteres. Para perfeccionar este componente crítico, revise Ai-crafted meta descriptors: the secret sauce for instant visibility boost.
—
Conexión entre Copywriting y UX: Interfaces Diseñadas para Convertir
El contenido indexado carece de valor comercial si los usuarios abandonan la página de inmediato. Los algoritmos de clasificación analizan de forma continua las señales de comportamiento: tiempo de permanencia, profundidad de scroll y reformulación de consultas. Un texto generado sin estructuración visual provoca rebotes rápidos hacia la SERP, degradando el posicionamiento.
«`
[Generación Base con IA]
│
▼
[Motor de Renderizado Dinámico]
├── Módulo Hero con H1 Optimizado
├── Bloque de Respuesta Rápida (Direct Solution)
├── Tabla Semántica de Datos (Aumento de Permanencia)
└── Módulos de Conversión Estratégicos
│
▼
[Optimización de Señales de Interacción y UX]
«`
Formato de Microcontenido y Escaneabilidad
Transformar el contenido generado mediante **AI writing** en un activo de conversión exige componentes visuales dinámicos:
* **Bloques de Respuesta Directa:** Definiciones claras o respuestas sintéticas al inicio del contenido para capturar featured snippets y satisfacer búsquedas transaccionales rápidas.
* **Tablas Comparativas Semánticas:** Estructuración de comparativas complejas en tablas nativas HTML/Tailwind. Facilitan la lectura, retienen al usuario y aportan semántica limpia a los motores de búsqueda.
* **Módulos de Acción Práctica:** Desglose de procesos informativos en secuencias numeradas visualmente diferenciadas dentro de la interfaz.
La presentación visual del contenido es tan determinante para las conversiones como la calidad del propio texto. La integración directa de estos pipelines de redacción en frameworks adaptables se detalla en Revolutionizing web design: ai-powered layouts that convert visits into sales.
—
SEO Programático a Escala: Plantillas Dinámicas y Ejecución en el Edge
El SEO programático combina bases de datos relacionales con generación automatizada de texto para desplegar miles de landing pages orientadas a búsquedas long-tail. Sus implementaciones habituales comprenden directorios técnicos, páginas de integraciones, hubs geográficos y comparadores de producto.
«`
+———————————————————–+
| Bases de Datos Relacionales |
| (Métricas, Atributos de API, Stats) |
+———————————————————–+
│
▼
+———————————————————–+
| Motor Edge Worker (Cloudflare / Vercel) |
| – Ensambla datos relacionales con contextos de IA |
| – Aplica políticas Stale-While-Revalidate en caché |
| – Inyecta esquemas JSON-LD dinámicos por página |
+———————————————————–+
│
▼
+———————————————————–+
| Rastreador: Indexa Contenido Programático Diferenciado |
| y de Alta Utilidad |
+———————————————————–+
«`
Neutralizar el Riesgo de Contenido Pobre (Thin Content)
Tradicionalmente, las páginas programáticas dependían de plantillas estáticas donde solo cambiaban variables aisladas (como la ciudad o el nombre del producto). Los motores de búsqueda detectan estos patrones con rapidez, catalogándolos como páginas puerta (doorway pages) o contenido duplicado, retirándolos del índice.
Al integrar modelos contextuales en el bucle programático, es posible variar la estructura del desarrollo, redactar análisis introductorios basados en las métricas de cada registro y formular soluciones específicas para cada caso.
Para profundizar en el escalado de este sistema sin penalizaciones de indexación, revise la metodología descrita en Ai-powered content magic: instantly boost your website’s visibility with automated copywriting wizards.
Renderizado en el Edge y Rendimiento Técnico
Los Core Web Vitals impactan directamente en el ranking. Al generar texto a gran escala, debe evitarse a toda costa invocar LLMs directamente durante el ciclo de petición-respuesta del cliente. Generar texto en tiempo de ejecución añade varios segundos de latencia, arruinando las métricas de Time to First Byte (TTFB) y Largest Contentful Paint (LCP).
La arquitectura debe responder a un patrón asíncrono y orientado a eventos:
1. Actualización asíncrona de contenidos mediante webhooks o tareas por lotes programadas.
2. Renderizado estático a HTML durante la compilación o almacenamiento en caché perimetral (CDN Edge) mediante estrategias stale-while-revalidate.
3. Entrega de páginas precompiladas con tiempos de respuesta por debajo de los 100 ms.
—
Pipelines de Optimización Continua y Control de Calidad
Escalar una infraestructura editorial automatizada sin un bucle de control de calidad continuo acumula deuda técnica y editorial. Las alucinaciones fácticas, los datos obsoletos y la pérdida de relevancia semántica desgastan gradualmente el rendimiento orgánico del dominio.
El mantenimiento sistemático protege el posicionamiento adquirido. Los fundamentos sobre ajustes del ciclo de vida del contenido se desarrollan en Revolutionizing your website with ai-powered content optimization techniques.
«`
┌────────────────────────────────────────────────────────┐
│ Bucle de Auditoría Continua │
└────────────────────────────────────────────────────────┘
│
┌──────────────────┴──────────────────┐
▼ ▼
┌───────────────────────┐ ┌───────────────────────┐
│ Sincronización GSC │ │ Distancia Coseno │
│ (Monitoreo CTR/Rank) │ │ (Detección de Deriva) │
└───────────────────────┘ └───────────────────────┘
│ │
└──────────────────┬──────────────────┘
▼
┌───────────────────────────────────────────────────────────┐
│ Worker de Regeneración Dinámica │
│ (Actualiza entidades, corrige hechos y reenvía sitemaps) │
└───────────────────────────────────────────────────────────┘
«`
Protocolo de Validación Automatizada
Antes de publicar el texto generado en los entornos de producción, este debe superar filtros de validación técnica:
* **Control de Alucinaciones por Doble Verificación:** Contraste las afirmaciones fácticas, métricas y referencias frente a las fuentes de datos originales mediante una segunda pasada con temperatura cero.
* **Medición de Distancia Semántica:** Calcule la similitud del coseno entre los embeddings del borrador y los de los tres principales competidores de la SERP. Si la similitud cae por debajo de 0,78, el texto omite conceptos clave del tema. Si supera 0,98, el contenido corre el riesgo de ser filtrado por falta de originalidad o nula ganancia de información. El rango operativo óptimo se sitúa entre 0,82 y 0,90.
* **Validación de Grafos y Enlazado Interno:** Asegure que cada enlace interno apunte a URLs operativas y canónicas registradas en el CMS. Los modelos generativos pueden inventar rutas inexistentes o aplicar anchor texts irrelevantes; pase cada enlace generado por una lista blanca estricta antes de la persistencia.
—
Implementación Práctica: Construcción del Motor de Generación
El siguiente flujo describe la implementación de un pipeline de redacción automatizado de nivel productivo utilizando Python, la API de OpenAI y validación de entidades.
Paso 1: Ingesta de Intención en SERP y Extracción de Entidades
Consulte las URLs líderes mediante una API de análisis de SERP. Extraiga los encabezados, ejecute un reconocedor de entidades lingüísticas y determine la distribución de frecuencia de los términos clave.
«`python
# snippet: entity_extraction_pipeline.py
import spacy
from collections import Counter
nlp = spacy.load(«es_core_news_md»)
def extract_serp_entities(competitor_texts):
combined_text = » «.join(competitor_texts)
doc = nlp(combined_text)
# Filtrar por entidades técnicas, comerciales y de producto
valid_labels = {«ORG», «PRODUCT», «MISC», «LOC»}
entities = [ent.text.lower() for ent in doc.ents if ent.label_ in valid_labels]
# Retornar las 25 entidades principales por frecuencia
return [item[0] for item in Counter(entities).most_common(25)]
«`
Paso 2: Configuración del Prompt del Sistema
Defina un prompt de sistema rígido que obligue a mantener un registro técnico profesional, elimine fórmulas vacías y fuerce la devolución de datos en JSON válido.
«`markdown
SYSTEM PROMPT:
Eres un redactor técnico sénior y especialista en SEO programático.
Genera un artículo técnico exhaustivo y de alta autoridad a partir del contexto facilitado.
REGLAS:
1. No utilices fórmulas introductorias genéricas, muletillas conversacionales ni redundancias de relleno.
2. Mantén un tono imperativo, directo, técnico y estructurado.
3. Integra de forma natural y contextualizada cada uno de los elementos de REQUIRED_ENTITIES.
4. La respuesta debe coincidir exactamente con el esquema JSON indicado, sin texto explicativo adicional.
INPUT PARAMETERS:
– PRIMARY_KEYWORD: AI writing
– TOPIC: Infraestructura de Producción Editorial Automatizada
– REQUIRED_ENTITIES: [«vector search», «information gain», «BM25», «embeddings», «schema validation»]
«`
Paso 3: Ejecución y Control de Calidad
Ejecute la llamada al modelo, procese el objeto JSON resultante y aplique las validaciones sintácticas y de entidades requeridas.
«`python
# snippet: generation_controller.py
import json
from openai import OpenAI
client = OpenAI()
def generate_optimized_asset(prompt_payload):
response = client.chat.completions.create(
model=»gpt-4o-2024-08-06″,
response_format={«type»: «json_object»},
temperature=0.3, # Temperatura baja para asegurar disciplina estructural
messages=[
{«role»: «system», «content»: prompt_payload[«system»]},
{«role»: «user», «content»: prompt_payload[«user»]}
]
)
article_data = json.loads(response.choices[0].message.content)
# Verificación de presencia de entidades
body_flat = » «.join([sec[«body_markdown»] for sec in article_data[«sections»]])
for entity in prompt_payload[«required_entities»]:
assert entity.lower() in body_flat.lower(), f»Entidad obligatoria ausente: {entity}»
return article_data
«`
Paso 4: Inyección de Esquemas y Publicación en el CMS
Transforme el JSON validado a Markdown estructurado, agregue los esquemas JSON-LD correspondientes (`Article`, `TechArticle`) y publique el contenido directamente en el endpoint del CMS headless.
—
Métricas de Control Técnico para Pipelines Automatizados
Evaluar un pipeline editorial automatizado requiere analizar variables de rendimiento de infraestructura y rastreo, superando el simple recuento de palabras generadas:
1. Ratio de Rastreo e Indexación (Crawl-to-Index Ratio)
* **Definición:** Porcentaje de URLs automatizadas que pasan de ser descubiertas por los rastreadores a figurar con estado «Indexada» en Google Search Console.
* **Umbral Operativo:** Superior al 85%. Un volumen alto de páginas en estado «Rastreada: actualmente sin indexar» evidencia falta de ganancia de información, redundancia técnica o fallos en el enlazado interno.
2. Puntuación de Alineación de Entidades
* **Definición:** Grado de coincidencia entre el listado planificado de entidades y las entidades que el motor de búsqueda efectivamente detecta en la página (verificable con la API de Natural Language de Google Cloud).
* **Umbral Operativo:** Mínimo del 75% de coincidencia entre las entidades proyectadas y las detectadas.
3. Rendimiento de Clics frente a Posición Teórica (CTR Efficiency)
* **Definición:** Variación entre el CTR orgánico real obtenido y la media de clics esperada para esa posición concreta en el buscador.
* **Umbral Operativo:** Balance positivo; demuestra que los metadatos generados resuelven de forma precisa la intención de búsqueda frente al resto de competidores directos.
4. Tasa de Pérdida de Indexación (Index Decay Rate)
* **Definición:** Velocidad con la que una URL automatizada pierde impresiones o posiciones tras su fase de descubrimiento inicial.
* **Umbral Operativo:** Caída nula durante un periodo de 90 días. Una pérdida rápida indica que el procesamiento inicial identificó señales débiles de interacción o una escasa aportación de valor frente a competidores directos.
—
Enfoque Estratégico
Construir una máquina de captación orgánica respaldada por **AI writing** es un reto de ingeniería de software, no un ejercicio de redacción tradicional. Los equipos que tratan la automatización de contenidos como un pipeline de datos estructurado —integrando ingesta competitiva, encadenamiento riguroso de prompts, validación de esquemas y renderizado eficiente en el frontend— logran una visibilidad dominante y sostenible en las SERPs.
La prioridad reside en la arquitectura: someta la producción de contenidos a los mismos estándares de prueba e integración que se exigen al software y diseñe sistemas editoriales enfocados en aportar valor medible en cada llamada al sistema.
¿Listo para escalar su infraestructura digital?
No permita que los cuellos de botella técnicos frenen su crecimiento. Hable sobre su proyecto en torno a Ai-powered content magic: instantly boost your website’s visibility with automated copywriting wizards directamente con nuestros expertos sénior en Low Cost Web Agency.