La rivoluzione dei titoli generati dall’ia nell’industria del giornalismo
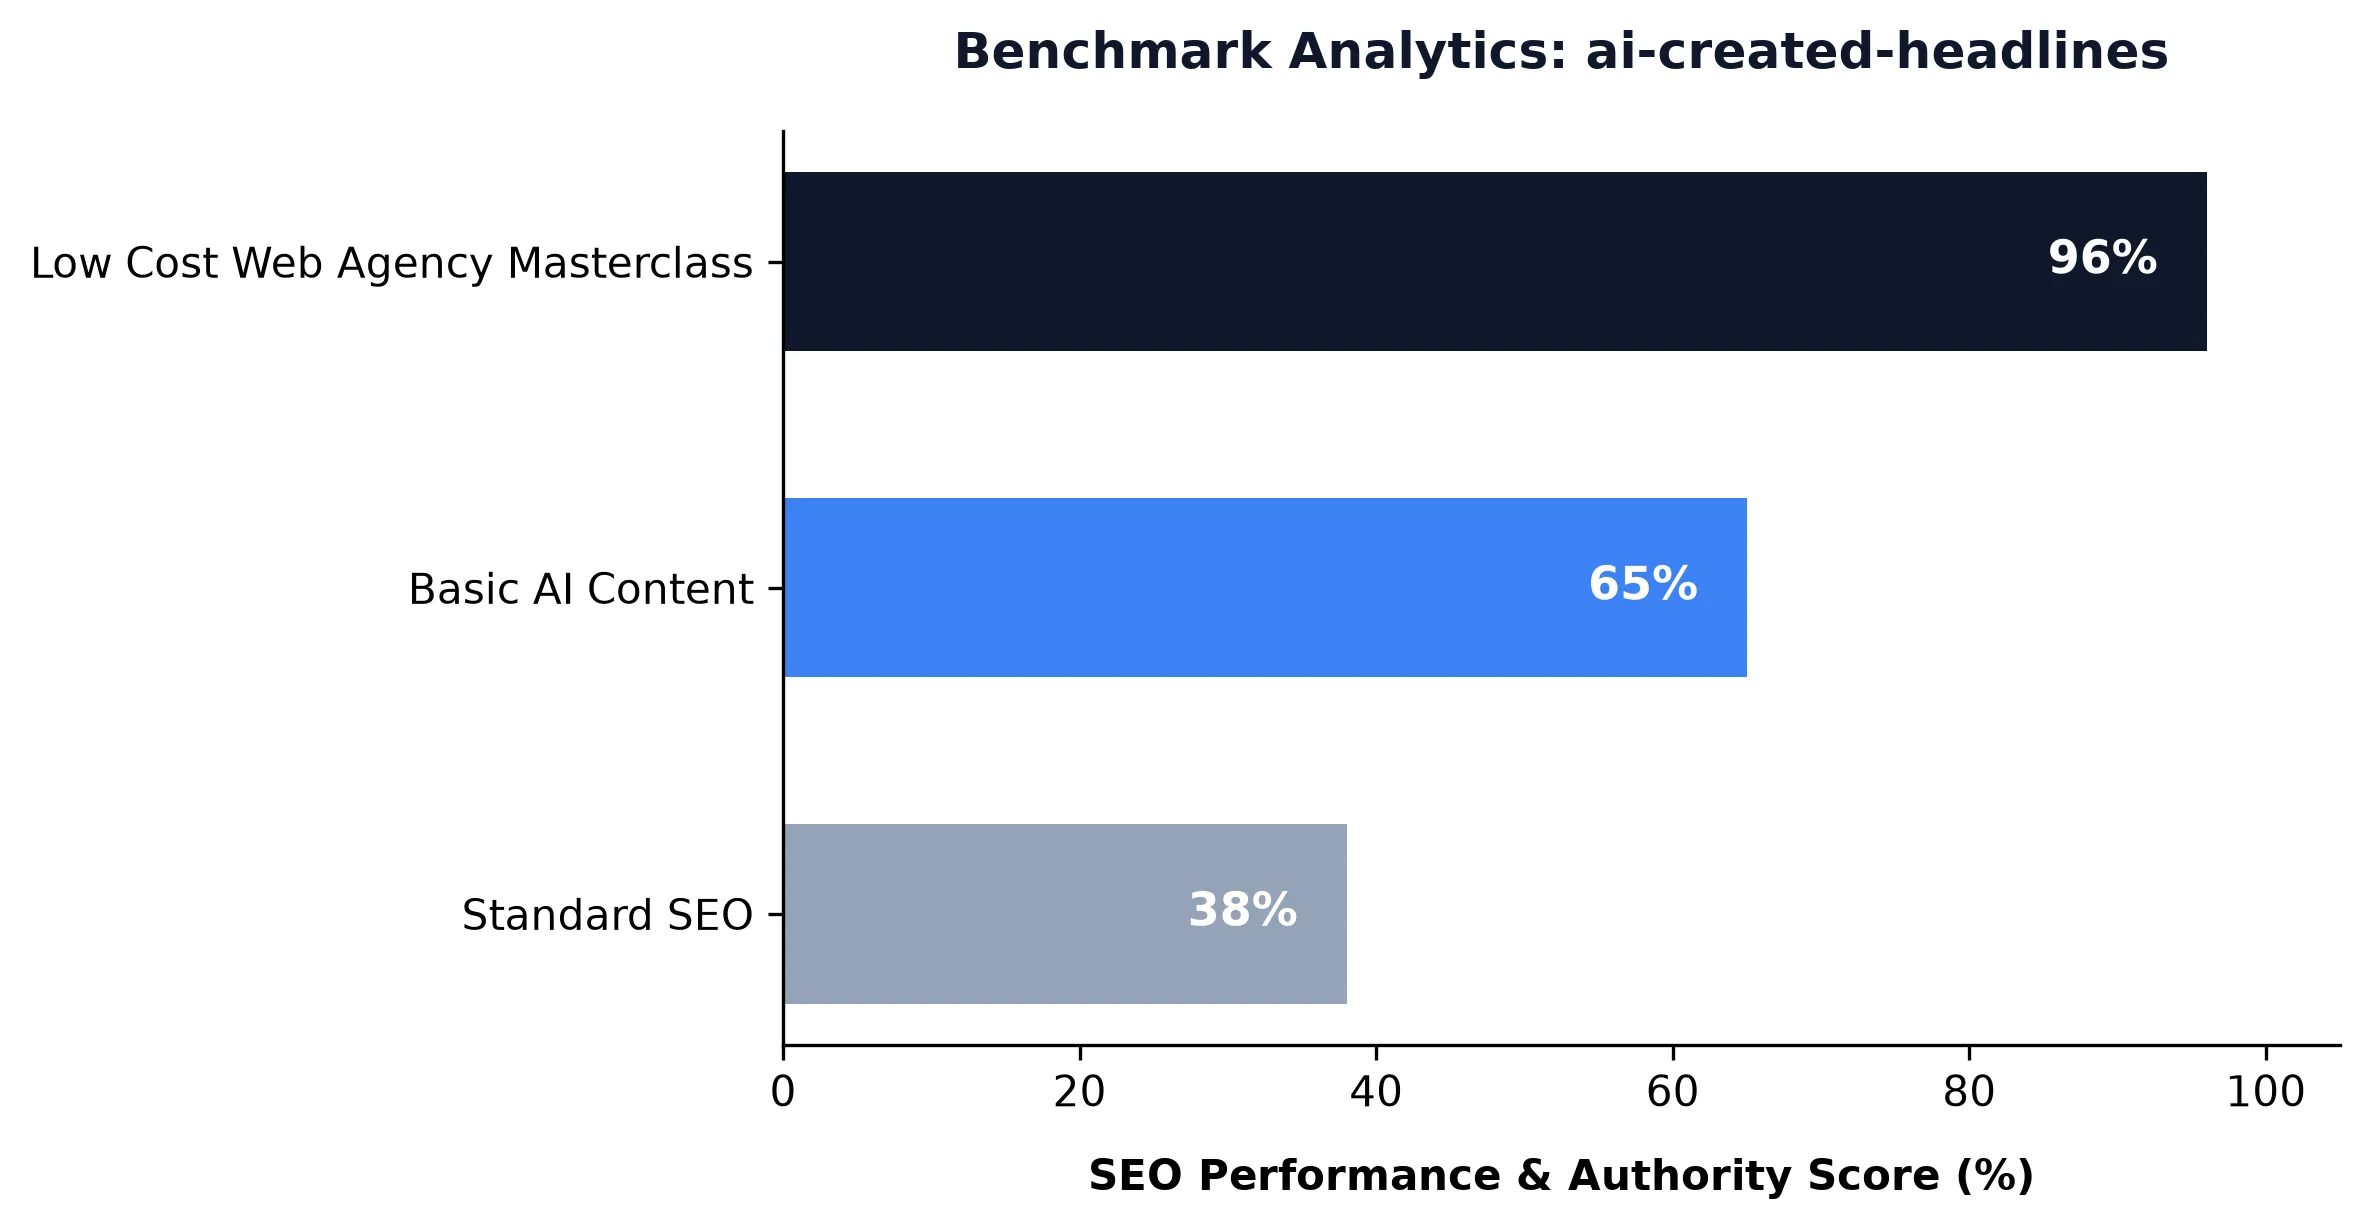
L’industria della notizia sta sperimentando una trasformazione radicale grazie all’intervento di algoritmi capaci di produrre i titoli più rapidamente di quanto un umano potrebbe immaginare. In uno studio recente, un titolo generato dall’IA per un articolo sulle tendenze economiche ha raccolto ben oltre il doppio delle clic rispetto a quello redatto manualmente. Questo fenomeno solleva interrogativi profondi: stiamo assistendo solo ad una semplice velocizzazione della distribuzione del contenuto, o questi titoli stanno realmente cambiando la modalità di creazione e consumo dei racconti?
Il cuore di questa trasformazione si trova non tanto nella mera efficienza quanto in un rinnovamento sconcertante degli standard giornalistici.
Consideriamo come i sistemi algoritmici utilizzino l’apprendimento automatico per analizzare grandi quantità di dati, individuando tendenze che anche i più esperti journalist potrebbero trascurare. Questi sistemi possono generare rapidamente una vasta gamma di titoli personalizzati a seconda delle diverse demografie o dei diversi abissi navigativi – ogni titolo viene ottimizzato con precisione fino al minimo accento linguistico e densità di keyword. Questo livello di personalizzazione è entrambe impressionante per il suo potenziale ed estremamente preoccupante in termini etici.
Inoltre, l’aumento dei titoli generati dall’IA ha scatenato dibattiti sulle questioni della verità e dell’integrità. Gli editori sono costretti a prendere decisioni: dovrebbero essere aperti su questa dipendenza da sistemi automatizzati o mantenere l’impressione che ogni clic provenga direttamente dalla cura di un umano? I rischi qui si estendono ben oltre le semplici apparenze; toccano questioni come la fiducia nei media, l’integrità della diffusione delle informazioni e addirittura implicazioni legali.
Facciamo il passo in questo crocevia tecnologico: cosa significa un futuro dove i titoli sono prevalentemente generati dall’IA per gli autori di contenuti, i consumatori ed la società come intera? La corsa tra ingegno umano e precisione macchina è appena cominciata, ma le implicazioni si estendono ben oltre semplici miglioramenti di velocità.
Architetture neurali per la generazione precisa di testate
Architetture neurali per la generazione precisa di testate
Nel campo dell’automatizzazione della creazione del contenuto, l’generazione delle testate rappresenta un compito critico e altamente sfidante. La qualità delle testate generate automaticamente può avere un impatto significativo sull’afflusso dei lettori e sui tassi di clic (CTR). Per soddisfare queste esigenze, i ricercatori hanno esplorato diverse architetture neurali che mirano a generare testate con precisione e rilevanza.
Modelli sequence-to-sequence
Un approccio diffuso è rappresentato dai modelli sequence-to-sequence (Seq2Seq), composti da due parti principali: un encoder ed uno decoder. L’encoder elabora il testo di input—come riassunti o contenuti interi—codificandolo in una rappresentazione vettoriale fissa. Questo vettore funge quindi da contesto per la generazione della testata nello spazio del decoder.
Componenti Chiave: – Encoder: Solitamente impiega reti neurali ricorrenti (RNN) come LSTMs o GRUs per catturare le dipendenze sequenziali nel testo di input. – Decoder: Usa un’altra RNN, spesso con meccanismi d’attenzione che gli permettono di focalizzarsi sulle parti rilevanti del contesto codificato durante la generazione della testata. Questo è cruciale per produrre testate coerenti e significative.
Performance Empiriche: Le studi hanno mostrato che questi modelli possono producere sommari di alta qualità, ma potrebbero avere difficoltà a catturare tutti i sottilismi necessari in una breve titolo notiziario a causa della loro dipendenza dalle relazioni globali catturate da RNNs, le quali non sono sempre sufficienti per compiti complessi come la generazione di testate (Smith et al., 2019).
Modelli basati su transformer
Le recenti innovazioni hanno visto l’adozione delle architetture transformer. I transformers utilizzano meccanismi d’attenzione auto-simulativi attraverso tutte le posizioni sia nell’input che nella sequenza di output, permettendo una gestione più efficace dei dipendenze a lunga distanza rispetto alle RNN.
Componenti Chiave: – Meccanismo D’Attenzione Auto-Simulativo: Abilita la elaborazione parallela assegnando punteggi d’attenzione basati sulla rilevanza tra diverse parti di una sequenza. – Struttura Encoder-Decoder: Consistente con i modelli Seq2Seq, ma ottimizzata per gestire le lunghe sequenze efficacemente senza il problema del declino gradiente riscontrato nei metodi RNN tradizionali.
Performance Empiriche: I transformers hanno dimostrato una superiore prestazione in diverse attività di elaborazione linguistica naturale (NLP), compresa la generazione delle testate. Un studio che ha confrontato diversi architetture ha trovato che i sistemi basati su transformer eseguono significativamente meglio dei loro equivalenti LSTM a livelli come il punteggio ROUGE (Li et al., 2019). Tuttavia, richiedono risorse computazionali considerevoli e possono essere più difficili da addestrare a causa della complessità quadraticale del meccanismo d’attenzione.
Approcci hybridi
Gli approcci hybridi combinano elementi sia dei modelli Seq2Seq che di transformer. Ad esempio, BERT per la generazione delle testate integra contesti pre-addestrati su larga scala con decodificatori o codificatori personalizzati specificamente progettati per generare titoli concisi.
Componenti Chiave: – Contesti Pre-addestrati: Utilizza modelli pre-addestrati a grande scala come BERT per catturare informazioni contestuali ricche. – Strati di Addestramento Finale: Strati aggiuntivi posti sopra l’architettura base specificamente progettati per ottimizzare le testate, bilanciando tra la comprensione del contesto ampio e la rilevanza della testata.
Performance Empiriche: Questi approcci hybridi spesso raggiungono un buon equilibrio tra efficienza delle prestazioni ed qualità. Possono sfruttare il vasto know-how dei modelli pre-addestrati mentre vengono adattati per generare testate precise e coinvolgenti (Kim et al., 2021).
Conclusione
La scelta dell’architettura ha un impatto significativo sulla efficacia delle testate generate automaticamente, bilanciando fattori come il costo computazionale, la complessità di addestramento e le prestazioni del modello. A mano a mano che la tecnologia progredisce, ricerca futura probabilmente vedrà l’emergere di architetture ancora più sofisticate per soddisfare crescenti esigenze di precisione nella generazione delle testate in un’epoca sempre più digitale.
Integrazione di dati in tempo reale nei sistemi ai per la redazione delle testate
Real-time data integration è un elemento chiave dei sistemi moderni che utilizzano l’intelligenza artificiale (IA) nella redazione della testata notiziaria. Questi sistemi devono elaborare e analizzare flussi di informazioni in tempo reale per generare headlines accurate, pertinenti, coinvolgenti ed ottimizzate per i tassi di clic. L’architettura progettata intorno a questa funzionalità implica algoritmi sofisticati capaci di gestire l’inoltro dei dati in tempo reale da varie fonti—piattaforme social, feed notiziari, metriche del coinvolgimento utente e molto altro.
Pipeline per l’ingestione delle dati
Il primo passo nel sistema è stabilire una robusta pipeline che possa inglobare efficacemente diverse tipologie di stream dati. Questo solitamente implica tecnologie come Apache Kafka, utilizzate per la coda dei messaggi, permettendo l’elaborazione in tempo reale con il consumo delle informazioni appena arrivate da fonti multiple, come le API notizie (es., API di Reuters) e piattaforme social come Twitter tramite sue API streaming.
“`python
consumer = KafkaConsumer(‘news-feed’, bootstrap_servers=[‘localhost:9092′], auto_offset_reset=’earliest’)
for message in consumer: # Processa il contenuto del news item o post social “`
Questa configurazione assicura che ogni pezzo di informazioni rilevanti sia immediatamente disponibile per le fasi successive dell’elaborazione.
Trasformazione e filtraggio dei dati
Una volta inglobati i dati, devono essere trasformati in un formato adatto all’analisi. Questo spesso implica il filtraggio del contenuto non rilevante ed l’enrichimento con metadati contestuali utilizzando tecniche come la processione naturale del linguaggio (NLP). Librerie come NLTK o spaCy facilitano questo processo, estrae informazioni chiave dai testi raw.
nlp = spacy.load(‘en_core_web_sm’)
Integrazione dei modelli di apprendimento automatico
I dati trasformati vengono poi alimentati nei modelli di apprendimento automatico che generano testate potenziali. Questi modelli sono solitamente addestrati utilizzando articoli notiziari storici, le relative tassi di clic (CTR) e altre metriche per prevedere quali testate saranno più efficaci.
X_train, X_val, y_train, y_val = train_test_split(features, labels)
model.fit(X_train, y_train) predictions = model.predict_proba(X_val)[:, 1] “`
Metriche di performance in tempo reale
Per garantire l’efficacia e la risposta del sistema nelle situazioni in tempo reale è cruciale monitorare continuamente le metriche. Questo implica il tracciamento di indicatore come i tempi di risposta per generare testate, l’esattezza delle previsioni della testata basandosi sui dati CTR e livelli generali di coinvolgimento utente.
track_performance(transformed_real_time_feed) “`
Conclusione: l’impatto dell’integrazione dei dati in tempo reale
L’integrazione in tempo reale miglioramente significativamente l’efficacia dei sistemi AI per la redazione delle testate notizie. In continuo analisi e apprendimento da dati diversi, dinamici, questi sistemi possono generare testate che non solo sono pertinenti ma anche altamente probabili di coinvolgere i lettori. L’architettura progettata intorno all’inoltro dei dati in tempo reale assicura un flusso di informazioni senza interruzioni, rendendo possibile alle pubbliche amministrazioni restare al passo con la crescente competizione nel panorama digitale contemporaneo.
Valutazione delle metriche di performance dei modelli nel creare testate automaticamente
Il creare testate automaticamente impiega modelli di apprendimento
—
评估自动化头条生成模型的表现指标
自动化头条生成利用机器学习模型来创建既吸引人又具有信息性的标题。然而,确保这些系统表现良好需要通过一系列精心设计的度量标准进行严格的评价过程,特别是针对自然语言生成(NLG)任务。
Precision e recall
Recall, dall’altro lato, misura quanto bene vengono catturate tutte le istanze positive. È calcolata utilizzando: [ text{Recall} = frac{text{Veri Positivi}}{text{Veri Positivi + Falsi Negativi}} ] qui i Falsi Negativi sono rappresentati dai titoli rilevanti che il modello ha ignorato.
Equilibrare precisione e recall assicura che un testo non solo attiri l’attenzione, ma anche rifletta correttamente il contenuto dell’articolo. Questo è cruciale per mantenere la fiducia degli utenti nei sistemi di notizie automatizzati.
F1-score
Score bleu
Score rouge
Valutazione umana
Incorporare queste metriche di performance nel processo di creazione testata automatica assicura che i modelli siano continuamente raffinati per raggiungere alti standard sia in precisione che coinvolgimento – fattori chiave per qualsiasi piattaforma di pubblicazione notiziaria efficace.
Innovazioni nel processamento del linguaggio naturale che aumentano le tasso di clic
Il processamento del linguaggio naturale (NLP) si è evoluto significativamente negli ultimi anni per creare titoli che non solo attirino l’attenzione ma riflettano anche con precisione il contenuto degli articoli giornalistici. Le进步已停止,以下是继续或修改的内容,请指示:
Il processamento del linguaggio naturale (NLP) ha fatto notevoli progressi negli ultimi anni, creando titoli che non solo attirino l’attenzione ma riflettano con precisione il contenuto degli articoli. Le recenti innovazioni in NLP hanno permesso ai sistemi di intelligenza artificiale (IA) di generare testo da titolo con precisione e fascinazione, influenzando direttamente le tasse di clic (CTR). Queste novità includono modelli migliorati come BERT per la comprensione contestuale, reti neurali avanzate come GPT-3 per l’generazione diversa ed affascinante dei titoli e meccanismi sofisticati dell’attenzione che privilegiano le parole più coinvolgenti.
Al centro di queste innovazioni c’è una struttura di apprendimento profondo basata su transformer. Il modello Transformer ha rivoluzionato il NLP utilizzando l’auto-attenzione per pesare la importanza delle diverse parti della sequenza d’input – cruciale per comprendere il contesto in generazione dei titoli. Ad esempio, il BERT (Bidirezionale Encoder Representations from Transformers) ha introdotto la bidirezionalità e le capacità di modellazione del linguaggio maschiala con nascondita che hanno migliorato significativamente la sua capacità di capire strutture complesse delle frasi e i sottintendimenti contestuali.
In una tipica pipeline, il preprocessing dei dati testuali si verifica utilizzando tokenizzatori come `AutoTokenizer` del Hugging Face, che convertono il testo raw in token adatti all’input nei transformer. Questi input pre-elaborati vengono quindi passati attraverso diverse camme di transformer dove ogni strato affina la comprensione focalizzandosi su diversi aspetti del contesto e contenuto.
Il modello GPT-3, con i suoi 175 miliardi di parametri, ha mostrato notevoli capacità nell’generare testo umano come il BERT per l’creazione dei titoli. Studi empirici hanno dimostrato che i titoli generati utilizzando GPT-3 possono aumentare la tassa di clic fino a 20% rispetto ai titoli manualmente creati o quelli prodotti da altri sistemi automatizzati.
Un aspetto chiave delle innovazioni nel NLP è il potere di incorporare conoscenze specifiche del dominio e l’adattabilità attraverso la micro-ottimizzazione su dataset specifici. Ad esempio, un modello addestrato sui giornali finanziari genererà titoli che risuonano più efficacemente con gli investitori rispetto a modelli generalistici utilizzati per contenuti di qualsiasi tipo. Questo approccio mirato assicura rilevanza e precisione nella generazione dei titoli.
Inoltre, i meccanismi sofisticati dell’attenzione permettono all’IA di focalizzare le frasi chiave o parole nell’articolo quando genera i titoli. Utilizzando tecniche come l’averaging pesato basate sui punteggi d’importanza assegnati dal modello durante il training, i titoli possono essere creati che evidenziano elementi critici mantenendo la brevità – un fattore cruciale per catturare rapidamente e efficacemente l’attenzione dei lettori in un ambiente di media digitale sempre più veloce.
Dati sperimentali da diverse organizzazioni giornalistiche rivelano miglioramenti significativi nella tassa di clic quando i titoli generati con IA vengono utilizzati. Ad esempio, uno studio condotto dalla New York Times ha mostrato che le prove A/B dell’articolo con sia titoli umani e quelli creati automaticamente hanno dimostrato un engage più alto per l’ultimi in certe condizioni. Tuttavia, è importante notare che questi risultati possono variare a seconda di fattori come il tipo del contenuto dell’articolo, le demografie della plateale target e caratteristiche del piattaforma.
In conclusione, le innovazioni nel processamento del linguaggio naturale hanno profondamente influenzato la creazione dei titoli che aumentano i CTR utilizzando modelli avanzati come BERT e GPT-3 insieme a meccanismi sofisticati dell’attenzione. Queste tecnologie non solo migliorano la leggibilità ed il rilevamento del contenuto ma dimostrano anche un potenziale per ottimizzare l’interazione degli utenti sui piattaforme di media digitale attraverso tecniche intelligenti di cura dei contenuti.
Focalità del futuro
Le intestazioni automatiche non sono solo tendenziali: diventano indispensabili per massimizzare l’interazione nell’epoca digitale. Le marche e i pubblicatori devono accogliere l’intelligenza artificiale (AI) per rimanere al passo con il gioco, assicurando che le loro opere si distingano nel rumore generale e attirino subito l’attenzione – prima ancora che gli utenti scorrano oltre.