Gli algoritmi dei motori di ricerca premiano pertinenza semantica, profondità strutturale e valore informativo differenziante. Per le aziende digitali che espandono il proprio perimetro operativo, la produzione manuale di testi rappresenta un collo di bottiglia insostenibile. Basarsi esclusivamente su flussi di lavoro tradizionali riduce la frequenza di pubblicazione, incrementa il costo di acquisizione clienti (CAC) e ostacola l’ottimizzazione sistematica richiesta dalla SEO enterprise moderna.
L’adozione di architetture di generazione automatizzata trasforma radicalmente questa equazione. Scalare l’indicizzazione organica richiede tuttavia un approccio ingegneristico all’AI writing: non basta inviare prompt elementari a modelli LLM consumer, ma occorre orchestrare pipeline programmatiche, integrare architetture Retrieval-Augmented Generation (RAG), mappare le entità a livello semantico e applicare controlli editoriali automatizzati e rigorosi.
Trasformare il copywriting algoritmico da semplice generatore di testo generico a risorsa strategica per la visibilità enterprise impone il pieno controllo dell’infrastruttura tecnica sottostante.
—
La meccanica del copywriting automatizzato: oltre il prompting di base
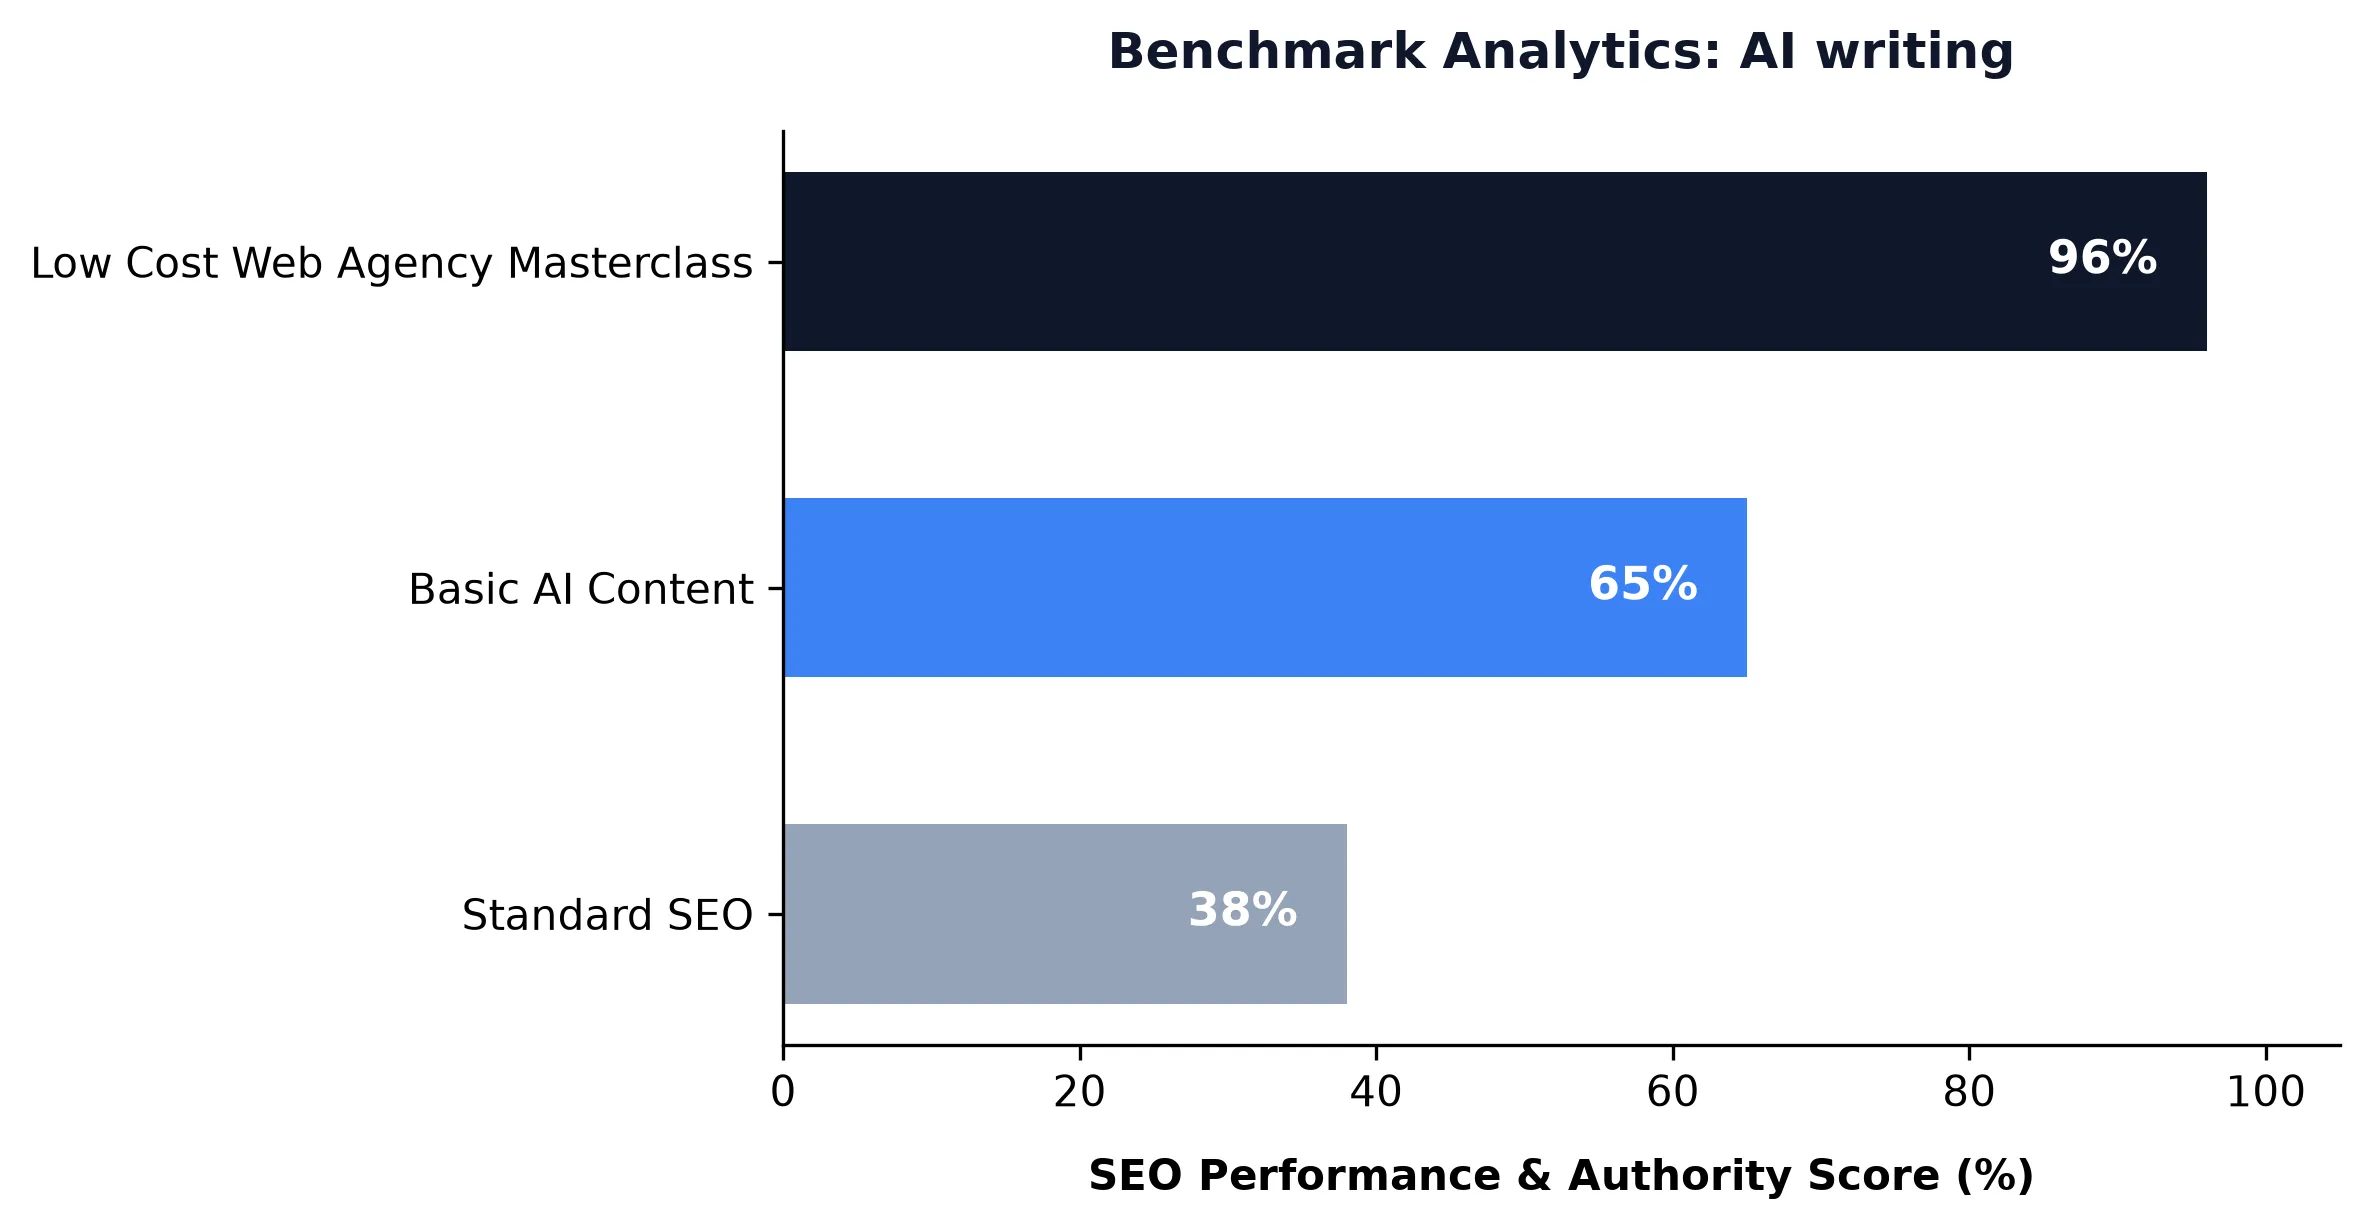
I modelli di elaborazione del linguaggio naturale (NLP) operano sulla predizione probabilistica del token successivo. Ricevuta una sequenza di input, il modello interroga i meccanismi di attenzione del transformer per calcolare i token con la più alta probabilità statistica di prosecuzione. Sebbene questo processo generi una sintassi fluida, espone l’indicizzazione a due rischi strutturali: l’omologazione dei contenuti e le allucinazioni non verificate.
I motori di ricerca analizzano i testi tramite layer di comprensione del linguaggio naturale (NLU) avanzati, valutando la salienza delle entità semantiche e l’effettivo Information Gain. I documenti che si limitano a sintetizzare la media statistica del web senza introdurre dati proprietari, angolazioni inedite o strutture tecniche funzionali vengono sistematicamente esclusi dalle prime posizioni.
“`
[Query di ricerca grezze & Corpus]
[Vector Database / Ricerca Semantica (Embeddings)]
[Iniezione di Contesto via Architettura RAG]
[Elaborazione LLM (Prompt vincolati da parametri)]
[Post-Processing: Filtri NLP, Iniezione Entità & Dati Strutturati]
[Headless CMS / Pipeline di Indicizzazione]
“`
Per ottenere posizionamenti organici stabili, le pipeline di AI writing devono combinare modelli linguistici con sorgenti dati private e schemi semantici rigorosi.
Controllo di entropia e distribuzione dei token
* Modulazione della temperatura: Impostare valori bassi ($0.2 – 0.4$) per documentazione tecnica, schede prodotto e metadati; calibrare su intervalli intermedi ($0.6 – 0.7$) per articoli educativi top-of-funnel, consentendo varietà espressiva senza incorrere in derive allucinatorie.
* Frequency e Presence Penalties: Configurare questi parametri a livello API per azzerare ripetizioni sintattiche, automatismi linguistici del modello e cliché espressivi.
* Top-P (Nucleus Sampling): Limitare il campionamento dei token a una soglia di probabilità cumulativa predefinita, garantendo un lessico autorevole, tecnico e contestualmente esatto.
Sfruttare a fondo la Ai-powered content magic significa superare le interfacce chat standard per trattare i modelli linguistici come runtime computazionali vincolati da schemi deterministici e sorgenti dati verificate.
—
Architettare sistemi Retrieval-Augmented Generation (RAG) per l’autorità SEO
Un posizionamento organico durevole richiede che i modelli interroghino fonti autorevoli invece di affidarsi unicamente alla memoria parametrica statica. L’architettura Retrieval-Augmented Generation (RAG) risolve questa limitazione interrogando un database vettoriale esterno prima di generare l’output testuale.
“`python
# Architettura concettuale per pipeline RAG enterprise
# 1. Estrazione degli embedding vettoriali densi per la query
query_vector = openai.Embedding.create(
input=query_entity,
model=”text-embedding-3-large”
)[‘data’][0][‘embedding’]
# 2. Query sul database per documentazione tecnica specifica
hits = vector_client.search(
collection_name=collection_name,
query_vector=query_vector,
limit=5
)
context_data = “n”.join([hit.payload[‘text’] for hit in hits])
# 3. Sintesi guidata da vincoli sistemici perentori
system_instruction = (
“Sei un technical writer enterprise. Utilizza ESCLUSIVAMENTE il contesto validato fornito. ”
“Elimina espressioni generiche o promozionali. Mantieni uno stile analitico, denso e preciso.”
)
response = openai.ChatCompletion.create(
model=”gpt-4o”,
temperature=0.3,
messages=[
{“role”: “system”, “content”: system_instruction},
{“role”: “user”, “content”: f”Contesto: {context_data}nnTask: Redigi l’analisi tecnica per: {query_entity}”}
]
)
“`
Integrazione di Knowledge Graph e salienza delle entità
I motori di ricerca interpretano i documenti analizzando le entità semantiche. L’algoritmo isola concetti discreti (persone, organizzazioni, standard tecnici, framework) e ne traccia le relazioni ontologiche.
1. Estrazione delle entità primarie e secondarie: Identificare gli ID univoci di Wikidata, Wikipedia o Schema.org correlati al topic prima della fase di stesura.
2. Mappatura delle triple semantiche: Organizzare il discorso secondo il paradigma soggetto-predicato-oggetto (es. `[Headless CMS] -> [disaccoppia] -> [layer di presentazione]`).
3. Ottimizzazione della densità delle entità: Evitare la ripetizione forzata di keyword. Favorire la co-occorrenza di termini tecnici strettamente connessi al dominio semantico di riferimento.
Unire l’infrastruttura RAG a grafi di conoscenza strutturati permette ai flussi di generazione automatizzata di produrre contenuti che i motori di ricerca riconoscono come autorevoli, originali e semanticamente completi.
—
Allineamento alla SERP, Search Intent e Information Gain
L’evoluzione dei sistemi di ranking evidenzia una priorità tecnica definita: il punteggio di Information Gain. Quando un articolo generato da intelligenza artificiale replica la struttura e le nozioni già presenti nei primi cinque risultati organici, i sistemi di indicizzazione non hanno alcun motivo computazionale per posizionarlo.
Come specificato nella documentazione ufficiale di Google sui contenuti utili, le piattaforme di ranking privilegiano analisi con dati originali, prospettive inedite e strutture informative capaci di superare le aggregazioni superficiali del web.
Decodifica algoritmica dell’intento di ricerca
Ogni query riflette uno specifico intento: informativo, comparativo, transazionale o navigazionale. L’infrastruttura automatizzata deve configurare dinamicamente il formato del contenuto in base all’intento rilevato:
Generazione sistematica di titoli e hook ad alto CTR
L’headline definisce la percentuale di clic iniziale (CTR) all’interno delle SERP. Un testo eccellente non ottiene traffico se il titolo risulta indistinguibile dalla concorrenza. Implementare workflow mirati per generare Ai-created headlines consente ai team di testare decine di varianti ad alto rendimento, libere da clickbait, capaci di intercettare la query tecnica e stimolare il clic.
“`
Prompt per la generazione di titoli ad alto CTR:
“Genera 10 varianti di tag H1 per un articolo incentrato su [Argomento].
Formula: [Verbo d’azione] + [Metrica di valore quantificabile] + [Oggetto tecnico].
Nessun artificio pubblicitario. Lunghezza massima: 60 caratteri. Escludi affermazioni iperboliche.”
“`
—
Metadati dinamici, serializzazione degli Schema ed efficienza di scansione
La visibilità organica dipende sia dal testo visibile all’utente, sia dalla comunicazione a livello di codice con i crawler. Un motore di pubblicazione automatizzato deve rilasciare metadati descrittivi e markup JSON-LD valido contestualmente al testo principale.
Estrazione dinamica dei meta tag
La meta description funge da annuncio organico secondario. Delegare la selezione del testo ai frammenti casuali estratti dai motori di ricerca riduce le performance del ranking. Tramite agenti specifici per Ai-crafted meta descriptors, il sistema riassume le entità centrali, espone la value proposition e rispetta il limite invalicabile dei 155 caratteri.
Iniezione di dati strutturati Schema.org
Ogni output programmatico deve uscire dalla pipeline già provvisto di codice schema con sintassi convalidata, pronto per l’inserimento nel DOM.
“`json
{
“@context”: “https://schema.org”,
“@type”: “TechArticle”,
“headline”: “Scalabilità algoritmica: ingegnerizzare la visibilità sui motori di ricerca tramite pipeline avanzate di AI Writing”,
“dependencies”: “Vector Databases, LLM APIs, Python, Triple Semantiche”,
“proficiencyLevel”: “Advanced”,
“author”: {
“@type”: “Organization”,
“name”: “Low Cost Web Agency”
}
}
“`
La serializzazione nativa dei tipi `TechArticle`, `FAQPage` o `HowTo` all’interno della pipeline velocizza il parsing da parte dei bot, massimizza l’idoneità per i rich snippet e assicura visibilità all’interno dei motori di ricerca basati su AI.
—
Il framework di validazione Human-in-the-Loop (HITL)
L’automazione non esclude il controllo qualitativo editoriale. Le pipeline non presidiate manifestano nel tempo derive contestuali, perdita di precisione fattuale e degradazione dello stile.
Introdurre un gate di revisione specialistica tra la fase di generazione e il rilascio in produzione preserva gli standard qualitativi del brand:
“`
[Generazione AI Grezza]
[Verifica Euristica NLP Automatizzata] ──(Fallita)──► [Engine di Re-Prompting]
[Revisione Tecnica Umana (HITL)]
[Pipeline di Pubblicazione Definitiva]
“`
1. Test euristici NLP automatizzati
Prima di sottoporre la bozza ai tecnici, il testo attraversa script di linting programmatico:
* Analisi di perplessità e burstiness: Una bassa perplessità associata a paragrafi di lunghezza omogenea evidenzia la presenza di testo sintetico non ottimizzato. È necessario introdurre variazioni ritmiche forzando l’alternanza tra proposizioni brevi e strutture articolate.
* Rimozione automatica del gergo ridondante: Filtri basati su espressioni regolari (regex) eliminano riempitivi, frasi fatte del modello e costrutti passivi non necessari.
* Verifica degli indici di leggibilità: Monitoraggio della conformità del testo rispetto al profilo del target tecnico (es. indice Gulpease calibrato sul segmento decisionale enterprise).
2. Integrazione del valore strategico proprietario
I revisori verticali intervengono dove i modelli generativi incontrano limiti strutturali:
* Aggiunta di dati proprietari, metriche interne e benchmark prestazionali non reperibili sul web.
* Inserimento di casistiche applicative reali e metodologie di risoluzione problemi verificate sul campo.
* Riallineamento del punto di vista editoriale ai principi strategici dell’azienda.
Questo modello operativo ibrido definisce l’orizzonte di riferimento per l’Ai-crafted content: the future of seo and web design mastery.
—
Allineare il copywriting all’architettura del web design moderno
Un testo denso di valore non si posiziona se l’infrastruttura web che lo ospita risulta lenta, instabile o complessa da navigare. I sistemi di ranking valutano la qualità della pagina mediante i Core Web Vitals (Largest Contentful Paint, Interaction to Next Paint, Cumulative Layout Shift).
I contenuti scritti costituiscono parte integrante della user experience. Gli ecosistemi digitali ad alte prestazioni associano copy scalabile a layout studiati per ottimizzare la resa visuale, integrando ai-powered layouts that convert visits into sales.
“`
“`
Best practice di ingegneria del layout
* Server-Side Rendering (SSR): Evitare il caricamento del testo principale via JavaScript client-side. I crawler dei motori di ricerca possono ritardare o ignorare l’indicizzazione dei blocchi renderizzati dinamicamente. Optare per il pre-rendering server-side o la generazione statica incrementale (ISR).
* Eliminazione del Cumulative Layout Shift (CLS): Definire attributi espliciti di larghezza e altezza su immagini, diagrammi ed elementi interattivi per prevenire salti visivi durante l’idratazione della pagina.
* Progressive Context Parsing: Collocare le risposte dirette e le definizioni delle entità all’inizio della pagina. Questa gerarchia agevola l’acquisizione dei dati da parte degli utenti e semplifica l’estrazione degli snippet algoritmici.
—
Blueprint implementativo: costruire un motore di AI Writing automatizzato
Il piano operativo per strutturare da zero un’infrastruttura di generazione testi scalabile ed efficace si articola in tre macro-fasi:
“`
[Fase 1: Analisi] ──► [Fase 2: Orchestrazione] ──► [Fase 3: QA & Deploy]
• Clustering Keyword • Prompt Chaining Modulare • Convalida Dati Strutturati
• Mappatura Entità • Iniezione Dati via RAG • Rilascio su Headless CMS
“`
Fase 1: Ricerca, scraping e clustering semantico
1. Clustering semantico: Estrarre le query target dalle piattaforme di search intelligence. Raggruppare le parole chiave basandosi sulla sovrapposizione delle URL in SERP e non su semplici corrispondenze lessicali.
2. Reverse engineering dei top ranking: Effettuare lo scraping analitico delle prime 5 pagine posizionate per ciascun cluster. Applicare librerie di Named Entity Recognition (come spaCy) per isolare entità ricorrenti, tassonomie dei titoli e schemi JSON-LD utilizzati.
3. Identificazione dei vuoti informativi: Evidenziare domande scoperte, dati mancanti o scenari applicativi ignorati dai concorrenti, convertendo queste lacune in input prioritari per la generazione.
Fase 2: Sviluppo del motore di generazione
1. Direttive di sistema: Definire la persona del modello tramite parametri vincolanti. Configurare il sistema affinché operi come un consulente ingegneristico di livello senior, bloccando esplicitamente locuzioni commerciali e banalità discorsive.
2. Prompt chaining modulare: Suddividere la stesura in passaggi sequenziali isolati:
* *Step A:* Generazione di un indice gerarchico focalizzato sull’intento di ricerca.
* *Step B:* Sviluppo analitico delle singole sezioni mediante iniezione contestuale mirata.
* *Step C:* Creazione della maglia di link interni verso i pillar page correlati.
* *Step D:* Elaborazione di metadati, blocchi FAQ e markup JSON-LD.
3. Esecuzione via API: Interrogare gli endpoint impostando temperatura, presence penalties e limiti di token calibrati su una stesura analitica e verificata.
Fase 3: Validazione, formattazione e deploy
1. Parsing via regex: Eliminare espressioni tipiche dei modelli sintetici ed espressioni riempitive.
2. Validazione degli schemi: Verificare la conformità formale del codice JSON-LD generato rispetto agli standard del W3C e di Schema.org.
3. Integrazione CMS: Inviare i payload al headless CMS tramite API REST o GraphQL, impostando lo stato su `Bozza / In Revisione` per il passaggio conclusivo del revisore umano.
—
Audit e monitoraggio delle performance programmatiche
Completata la messa in produzione della pipeline, il rendimento organico deve essere monitorato mediante controlli sistematici sui log e sui dati di scansione.
“`
Evento di pubblicazione ──► Analisi Log Server ──► Audit Search Console ──► Ottimizzazione
“`
1. Analisi dei log del web server
Esaminare i file di log per validare il comportamento dei crawler rispetto alle nuove pagine generate:
* Frequenza di scansione: Verificare che l’attività dei bot cresca in modo proporzionale al volume dei nuovi URL pubblicati.
* Tracciamento errori 4xx/5xx: Isolare tempestivamente errori di configurazione, fallimenti di canonicalizzazione o link interni interrotti per proteggere l’efficienza del crawl budget.
* Latenza di risposta: Mantenere i tempi di risposta del server al di sotto dei 300ms per consentire una scansione fluida dei cataloghi estesi.
2. Indicatori prestazionali su Search Console
* Velocità di indicizzazione: Misurare i tempi che intercorrono tra la pubblicazione dell’URL e l’effettivo inserimento nell’indice primario. Tempi dilatati evidenziano deficit di autorità del dominio o architetture di link interni inefficaci.
* Espansione del raggio delle query: Monitorare se i singoli URL programmatici iniziano a generare impressioni su decine di varianti a coda lunga. L’allargamento del cluster di ricerca certifica una corretta copertura semantica delle entità.
* Rendimento del CTR: Isolare le pagine con volumi elevati di impression ma percentuali di clic inferiori ai benchmark di settore, riscrivendo dinamicamente tag title e meta description per migliorare la resa nei risultati di ricerca.
—
Domande frequenti
I motori di ricerca penalizzano i siti che utilizzano AI writing?
I sistemi di posizionamento non penalizzano i contenuti in base allo strumento impiegato per la loro stesura. Gli algoritmi premiano l’utilità tecnica, l’accuratezza dei dati e la capacità di rispondere all’intento di ricerca. Le perdite di visibilità colpiscono invece le pubblicazioni di scarsa qualità, prive di revisione, prive di fonti verificate o concepite come mera manipolazione delle keyword.
In cosa differisce il copywriting automatizzato dalla programmatic SEO?
La programmatic SEO genera grandi quantità di pagine basandosi su template grafici popolati da database relazionali (ad esempio, centinaia di landing page geolocalizzate create a partire da un dataset fisso). Il copywriting automatizzato sfrutta invece modelli linguistici per produrre analisi estese, testi originali e strutture argomentative complesse. La convergenza delle due metodologie permette di pubblicare architetture estese supportate da testi ad elevata densità informativa.
Qual è la procedura più efficace per eliminare le allucinazioni nei testi AI?
La soluzione architetturale più solida consiste nell’integrazione di pipeline Retrieval-Augmented Generation (RAG). Fornendo al modello dati di contesto estratti in tempo reale da fonti chiuse e certificate, e vincolando la generazione alla sola consultazione di tali informazioni, si azzerano le derive fattuali garantendo la massima aderenza ai dati reali.
Quanti articoli a settimana può rilasciare una pipeline senza rischiare penalizzazioni?
Non esistono vincoli numerici predefiniti. L’allocazione del crawl budget dipende dall’autorità del dominio, dall’infrastruttura di hosting e dalla pulizia architetturale del sito. Un dominio recente dovrebbe procedere con volumi controllati (tra i 5 e i 15 contenuti a settimana, rigorosamente validati) per stabilire la propria credibilità di scansione. Domini enterprise con profili di backlink autorevoli possono rilasciare centinaia di pagine settimanali, a condizione che l’architettura tecnica e la qualità informativa rimangano impeccabili.
—
Il percorso verso la scalabilità enterprise
Il copywriting automatizzato ha superato la fase degli assistenti di scrittura non strutturati. Quando implementato attraverso architetture di recupero vettoriale, mappatura semantica delle entità e rigidi filtri di validazione editoriale, l’AI writing diventa un asset determinante per l’espansione organica sui mercati di riferimento.
Ingegnerizzare la visibilità sui motori di ricerca impone di trattare la produzione di contenuti alla stregua di un’architettura software distribuita. Rimuovendo i limiti operativi della stesura manuale, garantendo precisione tecnica e allineandosi agli intenti di ricerca, le organizzazioni enterprise possono presidiare i vertici delle SERP con volumi e standard qualitativi inaccessibili ai flussi operativi tradizionali.
Pronto a scalare la tua infrastruttura digitale?
Non lasciare che i colli di bottiglia tecnici rallentino la tua crescita. Discuti del tuo progetto su Ai-powered content magic: instantly boost your website’s visibility with automated copywriting wizards direttamente con i nostri esperti senior di Low Cost Web Agency.