

La preservación del patrimonio cinematográfico ha estado históricamente limitada por la degradación física del nitrato de celulosa y del acetato, así como por la pérdida destructiva de fidelidad inherente a las pistas ópticas de densidad variable. Durante décadas, la ingeniería de restauración se limitó al posprocesamiento sustractivo: filtros notch para eliminar el zumbido de red, reducción espectral del siseo (*de-hissing*) y desparasitado manual (*decrackling*) mediante algoritmos de interpolación. Estas herramientas atenúan el ruido, pero son incapaces de sintetizar información acústica perdida. Cuando el desgaste óptico o el deterioro mecánico barren los sobretonos armónicos, la inteligibilidad cae en picado, dejando diálogos históricos apagados, huecos o severamente saturados por recorte de señal.
La acústica sintética moderna y el procesamiento neuronal de voz, impulsados por entornos de **Tech AI** de nivel empresarial, han transformado esta disciplina: el paradigma ha dejado de ser una restauración mecánica para convertirse en una reconstrucción generativa predictiva. Vocoders neuronales profundos, arquitecturas de difusión multilingües y el mapeo vocal en espacios latentes permiten ahora aislar, modelar y resintetizar las interpretaciones vocales de figuras clave del cine de mediados del siglo XX. Al tratar el audio deteriorado del celuloide como matrices de datos incompletas en lugar de formas de onda fijas, los equipos de ingeniería pueden regenerar pistas de diálogo con ancho de banda completo y fidelidad emocional intacta, listas para integrarse en formatos inmersivos como Dolby Atmos y configuraciones envolventes 7.1.
—
1. Física y degradación de señal en sistemas de audio analógico histórico
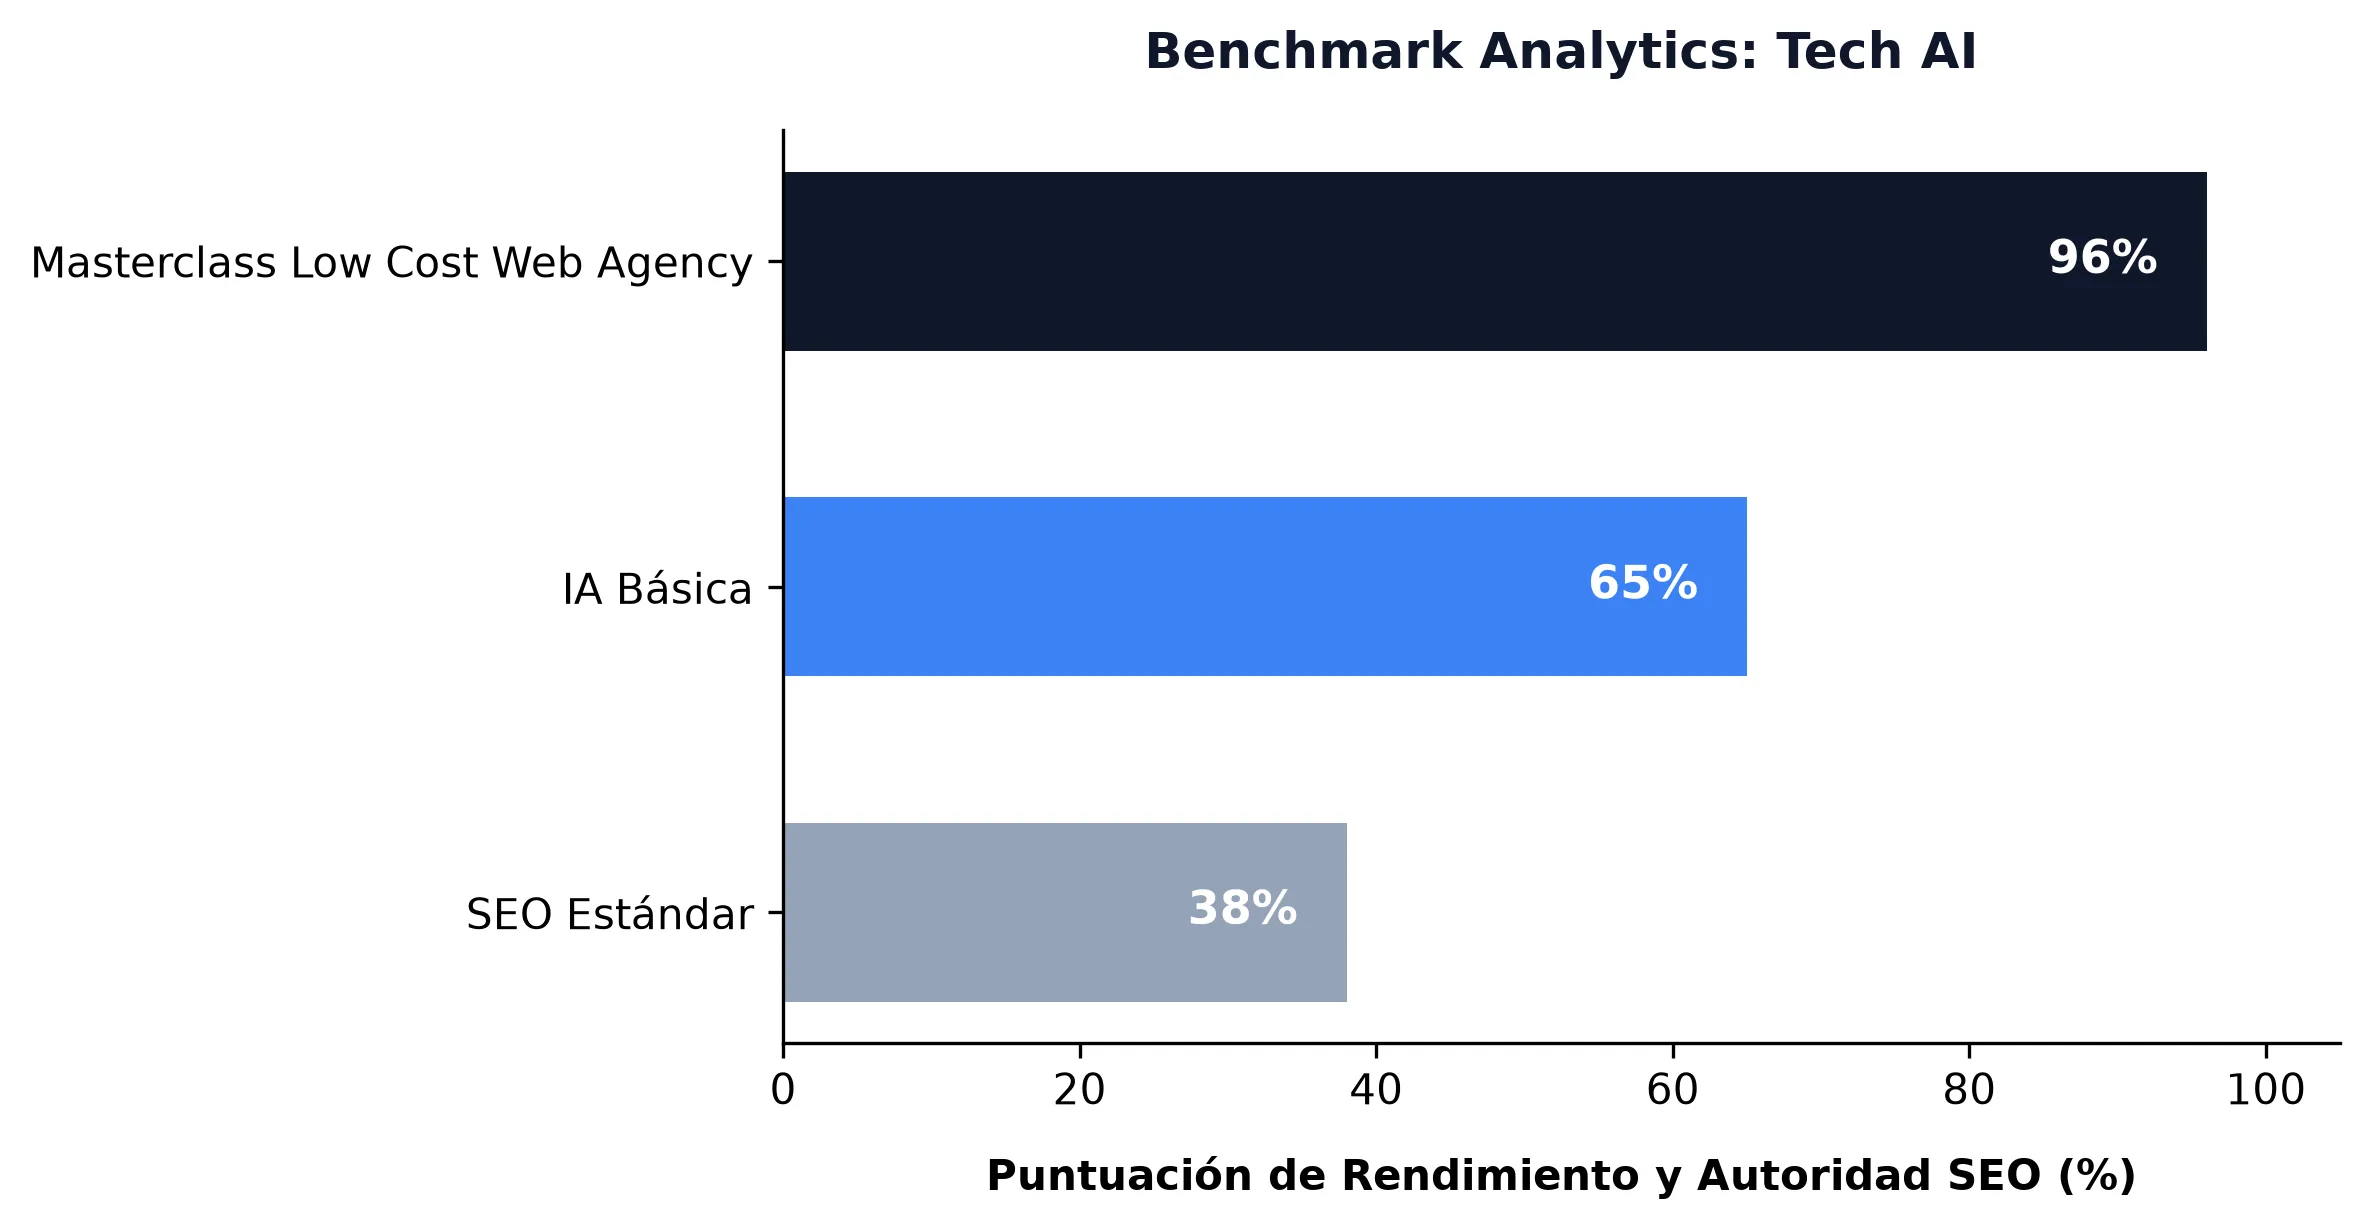
Para comprender cómo los modelos de vocodificación sintética reconstruyen interpretaciones históricas, es necesario analizar la patología acústica de los sistemas de registro óptico. Desde finales de los años veinte hasta bien entrada la década de 1950, los diálogos en rodaje se captaban mediante micrófonos de cinta o dinámicos con curvas de respuesta en frecuencia sumamente específicas, canalizados a través de preamplificadores a válvulas y expuestos directamente en el margen de la película mediante pistas ópticas de área o densidad variable.
«`
+—————————————————————+
| Cadena de degradación del sonido óptico cinematográfico |
+—————————————————————+
| Micrófono de cinta/carbón –> Saturación armónica no lineal (válvulas)
| |
| Exposición de densidad variable –> Agrupamiento de grano óptico y rayas
| |
| Célula fotoeléctrica de lectura –> Baja relación S/R y caída abrupta a 8 kHz
+—————————————————————+
«`
Estas etapas físicas introducían cuellos de botella acústicos sistemáticos:
1. **Restricción de ancho de banda**: El registro óptico primitivo rara vez superaba el umbral de los 7,5 kHz a 8 kHz. Las consonantes fricativas (/s/, /z/, /f/, /θ/), cuya inteligibilidad depende del aire turbulento entre los dientes y el paladar en la banda de 4 kHz a 12 kHz, sufren un severo emborronamiento de fase y compresión dinámica.
2. **Distorsión armónica y no lineal**: La amplificación a válvulas saturaba los tramos dinámicos superiores. Los pasajes vocales de alta energía (gritos, exclamaciones o inflexiones dramáticas repentinas) llevaban el medio físico al recorte (*clipping*), inyectando armónicos pares e impares que contaminaban las frecuencias formantes del actor.
3. **Inestabilidades mecánicas (*lloro y trémolo / wow and flutter*)**: Las fluctuaciones en la velocidad de arrastre de los motores, tanto en registro como en proyección, provocaban microdesviaciones tonales continuas. Esto introduce *jitter* variante en el tiempo sobre el contorno de frecuencia fundamental ($F_0$), arruinando la estabilidad tonal.
4. **Perfiles de ruido**: La fricción de transporte en el proyector, sumada a la descomposición química del soporte, genera chasquidos de alta amplitud, zumbidos parásitos de baja frecuencia (50/60 Hz) y un siseo estocástico continuo propio de la emulsión.
Los métodos clásicos de procesamiento digital de señales (DSP), como las puertas de ruido basadas en la Transformada Rápida de Fourier (FFT), silencian los contenedores espectrales por debajo de un umbral arbitrario de decibelios. Sin embargo, esta técnica engendra «ruido musical»: artefactos de fase flotantes que vacían la resonancia tímbrica del intérprete. La restauración generativa mediante arquitecturas de **Tech AI** elimina esta limitación. En lugar de limitarse a filtrar la señal dañada, decodifica los parámetros lingüísticos y acústicos subyacentes para reconstruir la voz desde sus propiedades matemáticas fundamentales.
—
2. Arquitecturas neuronales para inpainting y síntesis de voz
La reconstrucción sintética de voz desacopla el procesamiento en dos capas computacionales bien diferenciadas: el **modelado de características acústicas** (que traduce secuencias lingüísticas y vectores de condicionamiento en representaciones intermedias como mel-espectrogramas) y la **vocodificación neuronal** (que sintetiza directamente muestras de audio en el dominio temporal a partir de dichos espectrogramas).
«`
[Audio degradado original]
│
▼
[Separación de pistas vía Spleeter / Demucs] ───> [Pista vocal aislada]
│
▼
[Alineación fonética Whisper ASR]
│
▼
[Extractor acústico (F0, timbre)]
│
▼
[Difusión latente / Flow Matching]
│
▼
[Vocoder HiFi-GAN / BigVGAN]
│
▼
[Máster PCM limpio a 48 kHz / 24 bits]
«`
Modelado acústico: de la autorregresión a la difusión latente
Los primeros sistemas de síntesis vocal utilizaban esquemas autorregresivos (como Tacotron 2), que inferían mel-espectrogramas cuadro a cuadro. Pese a su naturalidad, estos modelos acusan una latencia elevada e incurren en acumulación de errores en bucle, provocando repetición de fonemas o elipsis involuntarias de sílabas, fallos incompatibles con el ajuste labial en metraje cinematográfico clásico.
Los flujos de restauración actuales implementan generadores acústicos no autorregresivos basados en **flow-matching** y **modelos probabilísticos de difusión para eliminación de ruido (DDPM)**, operando directamente sobre espacios latentes continuos:
* **Alineación texto-espectrograma**: Empleando modelos como FastSpeech 2 o VITS (*Variational Inference with adversarial learning for end-to-end Text-to-Speech*), las transcripciones obtenidas mediante reconocimiento automático del habla (ASR) se indexan en el dominio temporal a través de algoritmos de Alineación Monotónica (MAS).
* **Aprendizaje de distribuciones previas**: El sistema transforma los fonemas de entrada, combinados con las trayectorias de pitch ($F_0$) y energía, en una variable latente $z$. Mediante difusión inversa se remueve progresivamente el ruido gaussiano, proceso guiado por vectores de condicionamiento extraídos de fragmentos limpios supervivientes del propio intérprete.
* **Extensión de ancho de banda (Super-Resolution)**: Cuando la pista histórica carece de información por encima de los 8 kHz, las redes de difusión abordan el problema como una tarea de *inpainting* de imagen aplicada al espectrograma lineal o mel. La red predice los sobretonos armónicos ausentes analizando los fundamentales preservados, devolviendo el brillo y la presencia transitoria original a la voz.
Vocodificación neuronal: del espectrograma a formas de onda a 48 kHz / 96 kHz
Una vez generado el mel-espectrograma de rango completo, el vocoder neuronal sintetiza la forma de onda cruda unidimensional en modulación por impulsos codificados (PCM).
En esta etapa predominan arquitecturas como **HiFi-GAN**, **BigVGAN** y **Vocos**:
* **Discriminadores multiescala (MSD)**: Evalúan la señal en diferentes escalas temporales, obligando al generador a mantener una coherencia de fase homogénea tanto a lo largo de pasajes sostenidos (impidiendo vibratos metálicos) como en ráfagas transitorias (definiendo consonantes oclusivas secas como /p/, /t/ y /k/).
* **Discriminadores multiperiodo (MPD)**: Aplican convoluciones 2D sobre la señal 1D reestructurada en matrices de intervalos periódicos. Esto garantiza que la estructura armónica dependiente del pitch fundamental conserve un comportamiento acústico realista, exento de resonancias parásitas (*ringing*).
La integración de difusión latente no autorregresiva con vocoders adversarios multiperiodo permite escalar pistas ópticas truncadas a masters con resolución de 24 bits a 48 kHz o 96 kHz, plenamente compatibles con el estándar de producción contemporáneo.
—
3. Desacoplamiento y condicionamiento en espacios latentes de timbre
Reconstruir una voz histórica implica replicar la morfología acústica exacta de un individuo específico en un momento concreto de su vida. El timbre responde a variables biomecánicas no reproducibles de forma genérica: la masa de las cuerdas vocales, la longitud del tracto laríngeo y la estructura ósea maxilofacial determinan formantes únicos.
El modelado vocal corporativo desacopla la señal de entrada en cuatro vectores latentes ortogonales:
$$mathbf{X} = f(mathbf{c}_{text{contenido}}, mathbf{s}_{text{hablante}}, mathbf{p}_{text{tono}}, mathbf{e}_{text{emoción}})$$
Donde:
* $mathbf{c}_{text{contenido}}$ codifica la información fonética subyacente (fonemas, pausas y duraciones relativas).
* $mathbf{s}_{text{hablante}}$ representa la identidad invariante en el tiempo del locutor (timbre, dimensiones del tracto laríngeo, cavidades de resonancia).
* $mathbf{p}_{text{tono}}$ traza la trayectoria de la frecuencia fundamental ($F_0$) a lo largo del tiempo.
* $mathbf{e}_{text{emoción}}$ sintetiza las variaciones de energía dinámica, inclinación espectral y estabilidad glótica.
«`
[Muestra vocal histórica]
│
┌────────────┼────────────┐
▼ ▼ ▼
[Contenido] [Hablante] [Emoción/Prosodia]
Vector (c) Vector (s) Vector (e)
│ │ │
└────────────┬────────────┘
▼
[Motor de fusión desacoplada]
│
▼
[Voz resintetizada y limpia]
«`
Extracción de embeddings tímbricos mediante clonación zero-shot
Al entrenar un modelo sobre un actor ya fallecido, el corpus disponible suele ser reducido. Si un intérprete completó una docena de largometrajes, el material útil a menudo no supera unas pocas horas tras descartar pasajes con solapamiento orquestal, efectos sala y diálogos secundarios.
Para extraer el vector de identidad se emplean codificadores de características profundas como **x-vectors** o redes **ECAPA-TDNN** (*Emphasized Channel Attention, Propagation and Aggregation Time Delay Neural Network*). Estas redes proyectan ventanas de audio discretas en un espacio métrico hiperesférico:
1. Operaciones de similitud de coseno calculan la distancia entre las muestras limpias del actor y la señal generada.
2. El sistema minimiza una pérdida de margen angular (*Additive Angular Margin Softmax*, AAM-Softmax), compactando los agrupamientos vectoriales del mismo hablante y maximizando la separación respecto a identidades ajenas.
3. Este clúster aísla los rasgos físicos intrínsecos de la anatomía vocal, evitando que la reverberación del plató histórico o la respuesta del micrófono analógico contaminen la identidad modelada.
Dialectos de época y estilometría transatlántica
El cine clásico anglosajón hacía un uso intensivo del acento transatlántico (*Mid-Atlantic accent*), un patrón articulatorio artificial entre la pronunciación británica culta (*Received Pronunciation*) y el estándar norteamericano. Se caracterizaba por su no-roticidad sistemática (elisión de la /r/ final en vocablos como *water* o *car*), la apertura de vocales intermedias (/æ/ mutando a /ɑː/) y una oclusión dental acentuada en consonantes directas.
Si un modelo multilocutor moderno procesa directamente los guiones transcritos, tiende a corregir estos fonemas hacia las normas de distribución actuales. Para neutralizar este sesgo, los ingenieros configuran diccionarios de reemplazo fonético personalizados que sustituyen los tokens estándar del Alfabeto Fonético Internacional (AFI) por representaciones específicas de época. La capa de transcripción fonética queda fijada, blindando la fidelidad dialectal mientras el vocoder neuronal regenera la dinámica y el espectro acústico.
Para plataformas audiovisuales que combinan restauración y edición a gran escala, la integración de síntesis avanzada con motores semánticos controlados resulta indispensable; este enfoque converge con los principios detallados en Ai-crafted content: the future of seo and web design mastery, donde la gobernanza técnica de la estructura mantiene la identidad de marca original sin derivas no deseadas.
—
4. Flujo de restauración integral: implementación técnica paso a paso
Ejecutar una canalización de restauración vocal de extremo a extremo exige un protocolo estricto. Llevar un máster óptico analógico a través de una cadena generativa requiere fases desacopladas pero dependientes, preservando la sincronía temporal absoluta con la imagen proyectada.
«`
+—————————————————————————————+
| Pipeline generativo de restauración archivística |
+—————————————————————————————+
| Fase 1: Ingesta y análisis espectral (Captura óptica PCM a 96 kHz/24 bits) |
| │ |
| Fase 2: Separación ciega de fuentes (Aislamiento vocal profundo vía Demucs v4) |
| │ |
| Fase 3: Alineación fonética forzada (Segmentación temporal con precisión sub-ms) |
| │ |
| Fase 4: Síntesis latente e inpainting espectral (Reconstrucción armónica > 8 kHz) |
| │ |
| Fase 5: Remasterización multicanal y alineación de fase (Render espacial) |
+—————————————————————————————+
«`
Fase 1: Ingesta de alta resolución y acondicionamiento inicial
La pista de sonido original se escanea directamente del soporte físico mediante digitalizadores ópticos de lectura continua o cabezales magnéticos calibrados. El estándar de volcado no admite compresión: audio PCM lineal a 24 bits / 96 kHz.
Se aplican algoritmos iniciales de desparasitado temporal y alineación de azimut para mitigar desviaciones de fase por desalineación mecánica. En este punto no se aplica ningún filtrado espectral destructivo.
Fase 2: Separación ciega de fuentes vocales
Las películas anteriores a la cinta multipista no contaban con elementos sonoros independientes: diálogos, música orquestal y efectos sala se consolidaban en una única pista mono. Para reconstruir la voz, primero hay que extraerla.
Se implementan redes neuronales para separación de fuentes como **Demucs v4** (modelo híbrido en dominio temporal y espectral) o **Conv-TasNet** (*Time-domain Audio Separation Network*):
* La red discrimina transitorios de diálogo en pasajes orquestales complejos mediante máscaras tiempo-frecuencia aprendidas.
* El modelado con espectrogramas de valores complejos retiene la fase original, eliminando los artefactos de cancelación y desfase característicos de las matrices analógicas de canal central.
* La salida genera una pista vocal aislada (con sus daños físicos presentes) y una pista separada de música y efectos (M&E).
Fase 3: Decodificación ASR y alineación fonética forzada
La pista vocal aislada se procesa con un transcriptor automático robusto (como OpenAI Whisper o modelos Wav2Vec 2.0 optimizados). En lugar de procesar a ciegas, el sistema se acopla a las transcripciones del guion original como restricción bayesiana previa:
* **Clasificación Temporal Conexionista (CTC)**: Calcula los límites temporales exactos de cada fonema articulado con precisión de milisegundos.
* **Referencia visual labial**: Las marcas de tiempo deben casar con la cinemática labial del metraje fotograma a fotograma (generalmente a 24 fps, es decir, 41,67 milisegundos por frame). Cualquier desviación temporal genera un efecto de valle inquietante inmediato.
Esta parametrización guiada por metadatos textuales conecta de forma directa con los principios de ajuste sistemático expuestos en Ai-crafted meta descriptors: the secret sauce for instant visibility boost, donde la precisión algorítmica garantiza la correlación exacta con variables predefinidas.
Fase 4: Inpainting acústico y resíntesis
Con la secuencia fonética acoplada a marcas temporales fijas, se ejecuta la síntesis:
1. Las frecuencias fundamentales bajas ($F_0$ hasta aproximadamente 2,5 kHz) del audio de origen se mantienen para transferir la prosodia y la intención dramática directa del actor.
2. Los registros medios y altos degradados (formantes $F_3$ a $F_5$, de 3 kHz a 16 kHz) son inferidos mediante un vocoder generativo basado en difusión condicionado por el perfil tímbrico limpio del intérprete.
3. El vocoder sintetiza los sobretonos superiores corrigiendo microdesviaciones tonales inestables y limpiando la señal del grano óptico, conservando a la vez respiraciones, chasquidos labiales y el efecto de fritura vocal (*vocal fry*).
Fase 5: Mezcla espacial e integración final
La pista vocal sintética limpia se mezcla con la banda de música y efectos previamente restaurada. Se aplican reverberaciones por convolución dinámica mediante respuestas al impulso (RIR) calculadas para emular las dimensiones volumétricas del decorado visualizado en pantalla.
El diálogo se distribuye en disposiciones multicanal, construyendo un campo sonoro coherente con las exigencias de reproducción actuales sin desvirtuar la dinámica interpretativa histórica.
—
5. Complejidad técnica: doblaje multilingüe con paridad visual
Una derivación directa de la síntesis vocal avanzada es la localización multilingüe no destructiva. Tradicionalmente, el doblaje rompía la continuidad artística: actores de voz externos con características morfológicas y timbres diferentes sustituían la pista original, con evidentes desajustes entre la duración de las sílabas traducidas y la boca del actor en pantalla.
«`
[Audio original en inglés] ──> [ASR neuronal + Traducción técnica] ──> [Guion ajustado en español]
│ │
[Vector de timbre (hablante)] [Mapeo fonético temporal]
│ │
└───────────────────────────────┬─────────────────────────────────────┘
▼
[Pista resintetizada en español con el timbre original]
│
▼
[Alineación temporal con cinemática labial]
«`
La clonación vocal multilingüe actual resuelve esta fractura mediante la **conservación de identidad del locutor**:
* Un vector de embedding tímbrico ($mathbf{s}_{text{hablante}}$) obtenido del registro en inglés condiciona un modelo acústico secundario configurado para un idioma de destino (como español, francés o alemán).
* Apoyándose en el alfabeto fonético universal, la arquitectura genera los fonemas en el idioma de destino manteniendo inalteradas las cavidades de resonancia, la escala formántica y la envolvente dinámica del actor original.
* La transferencia del contorno tonal mapea con precisión la inflexión dramática: susurros, ironías o gritos se trasladan a la pista doblada con idéntica modulación de frecuencia.
«`python
# Pipeline conceptual para síntesis de voz interlingüística
import torch
import torchaudio
from speech_engine import SpeakerEncoder, PhoneticAligner, LatentDiffusionVocoder
def process_cross_lingual_restoration(source_audio_path, target_script_text, target_language_code):
# Carga de la pista original degradada
waveform, sample_rate = torchaudio.load(source_audio_path)
# Extracción del embedding tímbrico del actor
encoder = SpeakerEncoder.from_pretrained(«speech-timbre-v3»)
timbre_vector = encoder.extract_embedding(waveform, sample_rate)
# Procesamiento del texto traducido a estructuras fonéticas alineadas
aligner = PhoneticAligner(language=target_language_code)
target_phonemes = aligner.text_to_phonemes(target_script_text)
# Síntesis de la interpretación foránea alineada en tiempo
vocoder = LatentDiffusionVocoder.from_pretrained(«vocos-crosslingual-v1»)
restored_audio = vocoder.synthesize(
phonemes=target_phonemes,
speaker_embedding=timbre_vector,
target_sample_rate=48000
)
return restored_audio
«`
Para las plataformas mediáticas globales que automatizan la generación de contenidos a escala, esta estandarización es equiparable a los modelos de redacción programática; un paralelismo análogo al abordado en Ai-created headlines: boost your clicks with automated news titles, donde el procesamiento algorítmico mantiene el registro tonal a través de múltiples canales de difusión.
—
6. Ingeniería de señal: separación vocal y coherencia de fase
Para comprender la complejidad matemática del proceso es imperativo analizar cómo los modelos neuronales resuelven la coherencia de fase. El desgaste físico del celuloide no solo atenúa amplitudes en bandas específicas: corrompe de forma crítica la estructura de fase. La Transformada de Fourier de Tiempo Reducido (STFT) convencional suele descartar la fase para conservar únicamente la magnitud:
$$X(t, omega) = |X(t, omega)| e^{j phi(t, omega)}$$
Reconstruir la componente de fase $phi(t, omega)$ a posteriori ha sido uno de los problemas clásicos más complejos en DSP. Métodos iterativos como Griffin-Lim intentan aproximarla alternando proyecciones STFT directas e inversas, pero producen inevitablemente un sonido metálico y transitorios difusos.
Los vocoders neuronales de última generación sortean este problema evitando la conversión manual a espectrogramas o minimizando pérdidas explícitas de STFT multirresolución:
$$mathcal{L}_{text{STFT}}(G) = mathbb{E}_{x, hat{x}} left[ mathcal{L}_{text{mag}}(x, hat{x}) + mathcal{L}_{text{sc}}(x, hat{x}) right]$$
Donde la pérdida de convergencia espectral $mathcal{L}_{text{sc}}$ y la pérdida logarítmica de magnitud $mathcal{L}_{text{mag}}$ se calculan sobre múltiples ventanas de análisis:
$$mathcal{L}_{text{sc}}(x, hat{x}) = frac{| | text{STFT}(x) | – | text{STFT}(hat{x}) | |_F}{| | text{STFT}(x) | |_F}$$
$$mathcal{L}_{text{mag}}(x, hat{x}) = frac{1}{N} | log | text{STFT}(x) | – log | text{STFT}(hat{x}) | |_1$$
Al penalizar tanto las discrepancias logarítmicas como la desviación espectral a través de múltiples resoluciones temporales simultáneas, el generador aprende a sintetizar ondas crudas cuyas relaciones de fase restablecen la presencia física real de la voz humana.
Este nivel de rigor computacional converge con las arquitecturas analíticas aplicadas al desarrollo de interfaces modernas, un equilibrio examinado en Revolutionizing web design: ai-powered layouts that convert visits into sales, donde la optimización matemática de variables gobierna la experiencia operativa final.
—
7. Criterios éticos, legales y trazabilidad forense en preservación
La reconstrucción sintética de voces —particularmente de personas fallecidas— plantea implicaciones éticas y jurídicas determinantes. La frontera técnica entre la restauración documental y la alteración no autorizada exige protocolos de contención estandarizados.
«`
+——————————————————————————-+
| Marco de gobernanza y cadena de custodia forense |
+——————————————————————————-+
| 1. Verificación de titularidad (Cesión de derechos, contratos y dominio público)|
| 2. Marcado forense de agua (Manifiestos C2PA, esteganografía espectral) |
| 3. Cumplimiento de estándares abiertos (Especificaciones de audio del W3C) |
| 4. Integridad del contexto (Protección dialectal frente a sesgos modernos) |
+——————————————————————————-+
«`
Derechos de imagen digital y administración de herencias
Tras las revisiones normativas impulsadas por sindicatos de actores como SAG-AFTRA y normativas estatales sobre el derecho de propia imagen (como la ley AB 2602 de California), la reconstrucción de voz requiere encuadramiento contractual explícito:
* **Cláusulas de réplica digital**: Los acuerdos deben delimitar taxativamente la *restauración correctiva* (reparación técnica de una interpretación efectivamente realizada) frente a la *generación sintética no registrada* (hacer pronunciar al modelo líneas nunca dictadas por el actor).
* **Autorizaciones testamentarias**: Cualquier modelo de inferencia entrenado sobre el material de un actor histórico requiere el consentimiento formal de sus derechohabientes para la explotación del perfil biométrico vocal.
Marcas de agua forenses y trazabilidad de origen
Para evitar la circulación descontrolada de pistas sintéticas descontextualizadas, los ingenieros integran mecanismos de firma criptográfica en el renderizado final.
El estándar hegemónico es el desarrollado por la **Coalition for Content Provenance and Authenticity (C2PA)**. Las pistas resultantes quedan firmadas en el contenedor:
* **Metadatos del activo**: El archivo incorpora un manifiesto criptográfico que certifica el uso de redes neuronales, especificando qué frecuencias fueron reconstruidas y qué registros de origen alimentaron el modelo.
* **Marcas de agua inaudibles**: Algoritmos como AudioSeal incrustan patrones pseudoaleatorios de muy alta frecuencia de manera imperceptible dentro de la señal. Estas marcas resisten recodificaciones con pérdidas (MP3, AAC), permitiendo que analizadores forenses detecten de inmediato el contenido sintetizado.
Asimismo, la interoperabilidad con estándares web y de accesibilidad resulta ineludible. Estudios y laboratorios implementan los estándares fijados por el World Wide Web Consortium (W3C), asegurando que las especificaciones de síntesis y metadatos espaciales sean compatibles con cualquier entorno de despliegue digital.
Esta precisión en la gestión de flujos automatizados resulta igualmente crítica en infraestructuras de marketing dinámico, tal como se detalla en Ai-powered content magic: instantly boost your website’s visibility with automated copywriting wizards.
—
8. Líneas emergentes: vocodificación espacial y foley neuronal
La restauración sintética supera hoy la reconstrucción aislada del diálogo para abarcar la recreación del entorno acústico tridimensional. Una voz reconstruida con fidelidad cristalina en el canal central pierde verosimilitud si el espacio sonoro circundante carece de dimensionalidad física. La I+D actual avanza en dos frentes combinados:
Binauralización neuronal y audio volumétrico 3D
Las películas de la primera mitad del siglo XX contaban con pistas monofónicas concebidas para un único altavoz tras la pantalla. Las salas actuales operan con sistemas de audio espacial basados en objetos (como Dolby Atmos).
«`
[Voz mono restaurada]
│
▼
[Simulador geométrico de sala]
(Calcula el volumen 3D a partir del vídeo)
│
┌──────────────┼──────────────┐
▼ ▼ ▼
[Objeto Izq.] [Objeto Centro] [Objeto Dcho.]
(Lechos multicanal y espacializados)
«`
1. **Estimación volumétrica del set**: Redes neuronales convolucionales analizan los fotogramas de imagen para deducir una malla 3D aproximada del espacio físico de rodaje (una estación de tren, un salón de techos altos o el habitáculo de un vehículo).
2. **Predicción de respuesta al impulso (RIR)**: El sistema calcula la respuesta acústica simulando la absorción y dispersión de los materiales inferidos (madera, mármol, textiles, vidrio) y el volumen volumétrico total.
3. **Vocodificación espacial**: La voz sintética se convoluciona dinámicamente con esta RIR variable, adaptando la espacialidad de la pista conforme la cámara corta o se desplaza en el plano.
Foley neuronal y resíntesis de efectos
El cine clásico sufría una severa degradación en sus capas de sonido foley: pasos, roces de ropa y ruidos ambientales quedaban sepultados bajo el ruido de fondo óptico. Una vez aislado y regenerado el diálogo, sistemas complementarios detectan las colisiones e interacciones físicas en la imagen para generar efectos sala limpios mediante redes generativas adversarias (GAN).
Esta metodología redefine la restauración: los equipos de sonido han dejado de limitarse a limpiar registros defectuosos para dedicarse a computar entornos acústicos matemáticamente congruentes con la visión cinematográfica original.
—
Matriz técnica comparativa
| Dimensión / Métrica | Restauración DSP tradicional | Reconstrucción generativa con IA |
| :— | :— | :— |
| **Límite de frecuencia superior** | Acotado por el medio físico ($le 8text{ kHz}$) | Extensión armónica sintética sin techo ($48text{ kHz} – 96text{ kHz}$) |
| **Mitigación de ruido de fondo** | Compuertas y sustracción espectral (artefactos de fase) | Separación profunda de pistas (mantiene transitorios limpios) |
| **Fidelidad dialectal histórica** | Arrastra el ruido pegado a los formantes | Mapeo fonético rígido que blinda fonemas de época |
| **Integración multicanal** | Upmixing estático o distribución mono duplicada | Espacialización de objetos mediante predicción de RIR volumétricas |
| **Capacidad multilingüe** | Exige redoblaje externo (pérdida del timbre original) | Transferencia interlingüe zero-shot conservando el timbre real |
Mediante la integración de separación de fuentes, vocoders de difusión latente y protocolos de auditoría forense, los entornos de **Tech AI** han cerrado la brecha entre las interpretaciones de la era dorada del celuloide y las exigencias acústicas contemporáneas. Este andamiaje garantiza que el patrimonio cinematográfico mantenga su potencia expresiva y su valor histórico con total rigor técnico.
¿Listo para escalar su infraestructura digital?
No permita que los cuellos de botella técnicos frenen su crecimiento. Hable sobre su proyecto en torno a Ai-powered Voice Actors Bring Classic Films to Life directamente con nuestros expertos sénior en Low Cost Web Agency.




