L’acquisizione organica non dipende più dalla velocità di stesura manuale dei testi. Nel publishing digitale moderno, la visibilità sui motori di ricerca richiede completezza semantica, densità delle entità e un’architettura strutturata dei contenuti. Progettare una pipeline editoriale basata su sistemi avanzati di **AI writing** permette a team di ingegneria, SEO director e agenzie digitali di scalare asset indicizzabili mantenendo standard qualitativi rigorosi.
Implementare modelli generativi per la crescita organica va ben oltre l’invio di prompt grezzi tramite interfacce consumer. Richiede un’infrastruttura di livello enterprise: retrieval-augmented generation (RAG) dinamica, validazione programmatica degli schemi dati, estrazione di entità e post-processing continuo.
—
Fondamenti Algoritmici: Come i Motori di Ricerca Elaborano i Testi Generati da AI
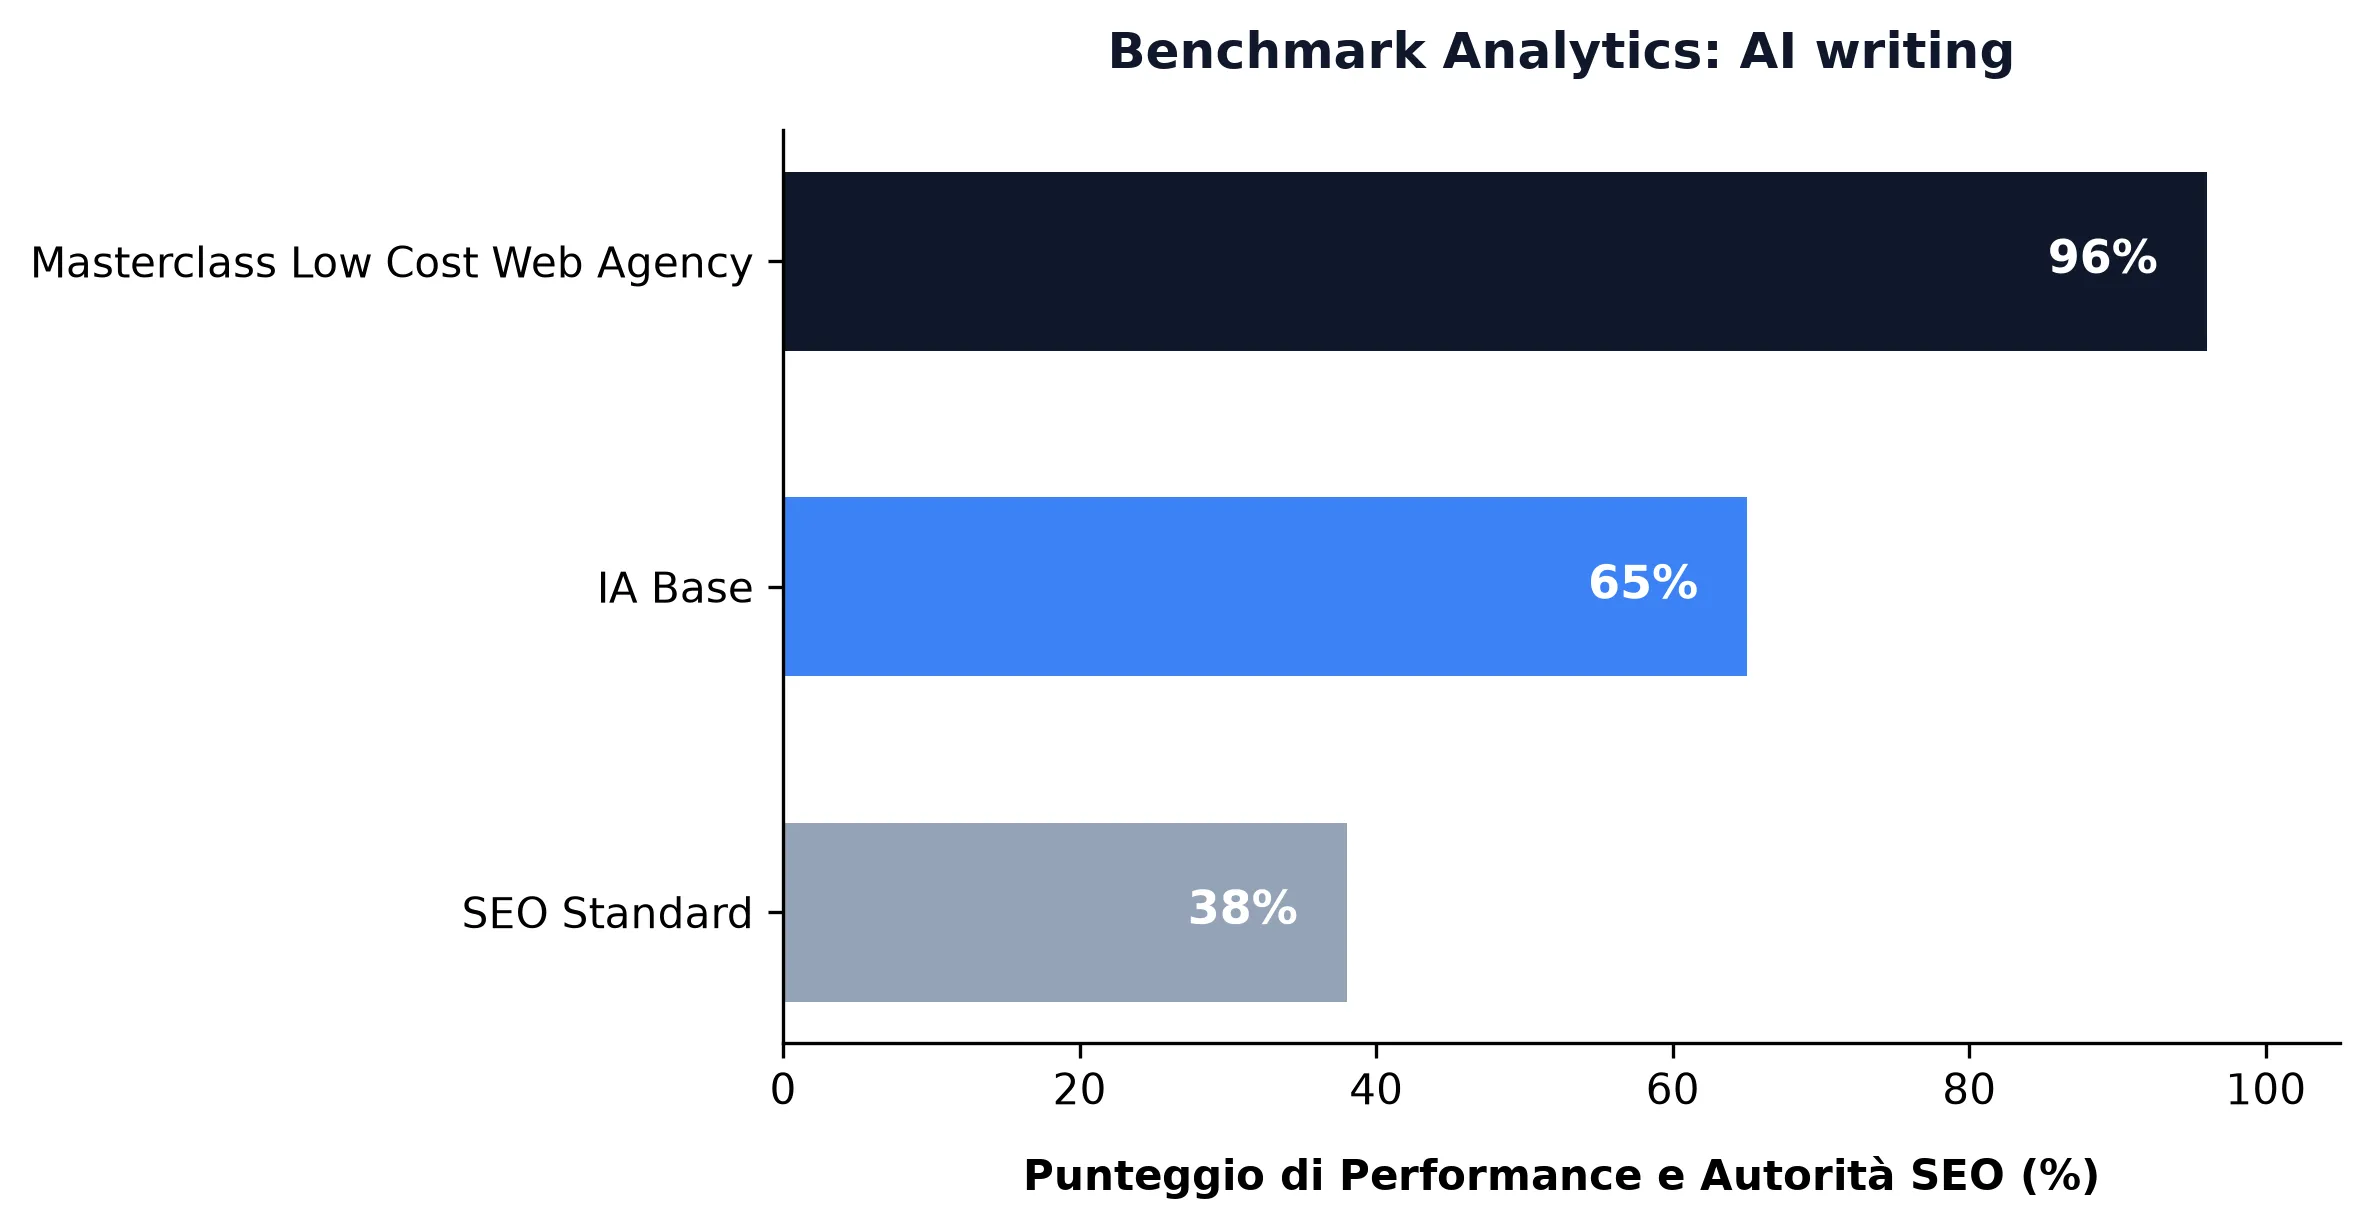
Per dominare le SERP (Search Engine Results Pages), occorre comprendere i meccanismi con cui i sistemi di Information Retrieval (IR) valutano il copy sintetico. I motori di ricerca non penalizzano un contenuto semplicemente perché le frasi sono state assemblate da un algoritmo. Come indicato chiaramente nelle linee guida di Google Search Central sui contenuti utili, i sistemi di ranking analizzano utilità, accuratezza fattuale, correlazione tra entità e reale soddisfacimento dell’intento di ricerca—indipendentemente dal metodo produttivo adottato.
“`
+———————————————————+
| Modern Search Parser |
+———————————————————+
|
+——————+——————+
v v
+——————+ +——————–+
| Lexical Matching | | Dense Vector Search|
| (BM25/TF-IDF) | | (Embeddings/BERT) |
+——————+ +——————–+
| |
+——————+——————+
v
+———————————————————+
| Information Gain & Entity Co-Occurrence Layer |
+———————————————————+
|
v
+———————————————————+
| SERP Rank Calculation |
+———————————————————+
“`
1. Ricerca Vettoriale e Distanza Semantica
Gli algoritmi di ricerca tokenizzano il testo mappandolo all’interno di spazi vettoriali ad alta dimensionalità. Modelli come BERT, MUM e i loro equivalenti open source quantificano la distanza semantica tra la query di ricerca e gli embedding del documento target.
I flussi non ottimizzati di **AI writing** presentano spesso un’elevata prevedibilità statistica (bassa perplexity e bassa burstiness). Se da un lato una bassa perplexity garantisce chiarezza, dall’altro un’uniformità eccessiva segnala ai classificatori l’origine sintetica del pattern. Un’implementazione efficace richiede un’articolazione sintattica variabile e un lessico mirato, capaci di ottenere punteggi elevati durante le scansioni vettoriali dense.
2. Densità delle Entità e Allineamento con il Knowledge Graph
I web crawler integrano modelli di Named Entity Recognition (NER) per estrarre sistematicamente:
* Entità primarie (concetti chiave, brand, tecnologie).
* Attributi secondari (specifiche tecniche, dimensioni, definizioni contestuali).
* Predicati di relazione (interconnessioni logiche tra l’entità A e l’entità B).
Nei flussi automatizzati, i modelli linguistici devono ricevere precise istruzioni per mappare queste entità esplicite. Un documento focalizzato sull’architettura cloud, ad esempio, deve ancorare con precisione nodi terminologici quali *latenza, scalabilità orizzontale, edge node* e *caching distribuito* all’interno di strutture sintattiche solide.
3. Punteggi di Information Gain
I brevetti registrati dai principali motori di ricerca quantificano l'”Information Gain”, ovvero il delta di informazioni inedite apportate da un URL rispetto alle pagine già consultate dall’utente all’interno dello stesso cluster di query. I contenuti automatizzati generici si limitano a sintetizzare i primi dieci risultati organici, registrando un Information Gain pressoché nullo.
I sistemi ad alta visibilità superano questo limite iniettando attributi di dati proprietari, calcoli dedicati, statistiche originali e casi studio direttamente nel contesto operativo del modello, prevenendo qualsiasi declassamento algoritmico.
—
Architettura della Pipeline: Oltre il Prompt Engineering di Base
Affidare la generazione di un’intera pagina commerciale a un singolo prompt produce testi generici e privi di mordente. I sistemi di **AI writing** orientati alle performance adottano pipeline multi-stadio basate su grafi aciclici diretti (DAG).
“`
[Scraping SERP & Estrazione NER]
│
▼
[Analisi Vettoriale & Gap Semantico]
│
▼
[Prompt Chaining Multi-Fase (DAG)] ────► [Iniezione Schema Dati]
│
▼
[Fact-Checking & Audit delle Entità]
│
▼
[CMS di Produzione / Edge CDN]
“`
Acquisizione Dati e Decomposizione della SERP
Prima di generare un singolo token, il sistema esegue lo scraping dei documenti con il miglior posizionamento per il target di query prestabilito. Routine di Natural Language Processing (NLP) scompongono i testi per estrarre:
* Gerarchia di intestazione (distribuzione dei tag H2, H3).
* Distribuzione statistica delle entità primarie.
* Lunghezza media dei passaggi per ciascun sotto-argomento.
* Domande correlate e intenti latenti (estrapolati dai box “Le persone hanno chiesto anche”).
Questo set di dati alimenta una finestra di contesto dinamica che guida il Large Language Model (LLM) durante l’intera fase di generazione.
Condizionamento del Contesto e Prompt Chaining
Invece di richiedere al modello di “scrivere un articolo sul tema X”, la pipeline segmenta il task in chiamate sequenziali specializzate:
1. **Fase di Architettura:** Generazione di una struttura JSON che mappa entità e gerarchia di intestazioni.
2. **Fase di Espansione:** Iterazione analitica sulle singole sezioni, con ingestione di parametri di ricerca esterni e record programmatici.
3. **Fase di Sintesi:** Rifinitura delle transizioni logiche, uniformazione del registro linguistico e verifica della coerenza terminologica.
4. **Fase di Arricchimento:** Inserimento di dati strutturati (markup JSON-LD, tabelle comparative, blocchi di codice).
Questo approccio granulare riflette i criteri operativi delineati in Ai-crafted content: the future of seo and web design mastery, dove il rigore strutturale costituisce la base per il rendimento nei motori di ricerca.
—
Implementazione Tecnica: Orchestrazione dei Modelli per le Performance di Ricerca
La selezione della famiglia di modelli incide sia sui costi computazionali che sulla qualità del dato finale. Le architetture su larga scala combinano modelli frontier (come Claude 3.5 Sonnet o GPT-4o) con modelli open-weights self-hosted altamente efficienti (come Llama 3 o Mistral Large).
| Livello / Task | Classe di Modello Consigliata | Metrica Target |
| :— | :— | :— |
| **Parsing SERP & Estrazione Entità** | Open source compatto (es. Llama 3 8B, spaCy) | Velocità, gestione deterministica dei token |
| **Pianificazione Strutturale & Outline** | Frontier Model (GPT-4o, Claude 3.5 Sonnet) | Ragionamento logico, comprensione del contesto |
| **Stesura del Testo Principale** | Modelli instruction-tuned ad alto parametro | Bilanciamento della perplexity, ampiezza lessicale |
| **Validazione Codice / Schemi Dati** | Motori specializzati in codice | Accuratezza sintattica assoluta, parsing JSON valido |
Output Deterministico Tramite Schemi JSON
Per inviare i contenuti direttamente ai database di CMS headless (quali Strapi, Contentful o istanze PostgreSQL dedicate), le pipeline devono imporre la modalità JSON o vincoli strutturati rigorosi.
“`json
{
“$schema”: “http://json-schema.org/draft-07/schema#”,
“title”: “ArticlePayload”,
“type”: “object”,
“properties”: {
“title”: { “type”: “string”, “maxLength”: 60 },
“meta_description”: { “type”: “string”, “maxLength”: 155 },
“target_keyword”: { “type”: “string” },
“entities_covered”: {
“type”: “array”,
“items”: { “type”: “string” }
},
“sections”: {
“type”: “array”,
“items”: {
“type”: “object”,
“properties”: {
“heading”: { “type”: “string” },
“level”: { “type”: “integer”, “minimum”: 2, “maximum”: 4 },
“body_markdown”: { “type”: “string” },
“key_takeaways”: {
“type”: “array”,
“items”: { “type”: “string” }
}
},
“required”: [“heading”, “level”, “body_markdown”]
}
}
},
“required”: [“title”, “meta_description”, “target_keyword”, “sections”]
}
“`
L’applicazione di schemi rigidi azzera gli errori di formattazione, elimina preamboli conversazionali indesiderati e garantisce che la pipeline downstream riceva dati puliti, pronti alla compilazione.
Generazione Chirurgica dei Metadati
I tag title e le meta description rimangono leve primarie per determinare la percentuale di clic (CTR) nei risultati di ricerca. Delegare questi elementi a riassunti sommari genera testi passivi, poco efficaci ai fini della conversione.
I system prompt devono essere configurati per generare molteplici varianti di metadati, valutate programmaticamente in base a parametri precisi: presenza di verbi d’azione, posizionamento della keyword principale, ancore di brand e rispetto rigoroso dei limiti di caratteri. Per approfondire la configurazione specifica di questo modulo, si rimanda a Ai-crafted meta descriptors: the secret sauce for instant visibility boost.
—
Integrazione tra Copywriting e UI/UX: Layout Progettati per Convertire
Un contenuto indicizzato non genera valore commerciale se l’utente abbandona la pagina all’istante. Gli algoritmi di posizionamento analizzano attentamente i segnali di interazione: tempo di permanenza (dwell time), profondità di scorrimento e frequenza di rimbalzo. Quando un testo generato si presenta come un blocco visivamente piatto, gli utenti tornano subito alla SERP, trasmettendo segnali negativi ai motori di ricerca.
“`
[Output AI Grezzo]
│
▼
[Engine di Layout Dinamico]
├── Hero Component con H1 Specifico
├── Box di Sintesi Interattivo (Risposta Diretta)
├── Tabella di Confronto Strutturata (Alto Dwell Time)
└── Card d’Azione Modulari (Trigger di Conversione)
│
▼
[Segnali di Engagement & UX Ottimizzata]
“`
Formattazione del Micro-Content e Scansionabilità Visiva
Trasformare un testo prodotto con strumenti di **AI writing** in una risorsa ad alto tasso di conversione richiede componenti front-end specifici:
* **Blocchi di Risposta Diretta:** Inserimento di definizioni immediate in testa alla pagina per intercettare le ricerche rapide e massimizzare le probabilità di posizionamento come featured snippet.
* **Tabelle Comparative Semantiche:** Conversione di argomentazioni complesse in tabelle HTML/Tailwind strutturate. Questo pattern incrementa la permanenza sulla pagina e agevola il parsing dei crawler.
* **Moduli di Approfondimento Pratico:** Scomposizione dei passaggi informativi in sequenze numerate evidenziate a livello di interfaccia.
La resa visiva incide direttamente sulle conversioni tanto quanto la bontà della scrittura. Le modalità di integrazione di queste pipeline all’interno di architetture front-end orientate alla conversione sono documentate in Revolutionizing web design: ai-powered layouts that convert visits into sales.
—
Programmatic SEO su Larga Scala: Template Dinamici ed Edge Computing
La Programmatic SEO unisce dataset strutturati e generazione algoritmica del testo per distribuire migliaia di landing page focalizzate su query a coda lunga. Le applicazioni più comuni includono directory specializzate, cataloghi di integrazioni software, hub geolocalizzati e portali di comparazione prodotti.
“`
+———————————————————–+
| Database Relazionali / Data Warehouse |
| (es. Statistiche Locali, Metriche Prodotto, API) |
+———————————————————–+
│
▼
+———————————————————–+
| Edge Worker Engine (Cloudflare / Vercel) |
| – Compila metriche DB con layer di contesto AI dinamici |
| – Gestisce la cache edge locale (Stale-While-Revalidate) |
| – Inietta markup strutturato e localizzato |
+———————————————————–+
│
▼
+———————————————————–+
| Search Crawler: Indicizza Pagine Programmatiche |
| Uniche e ad Alto Valore Aggiunto |
+———————————————————–+
“`
Prevenire il Fenomeno dei “Thin Content”
In passato, i progetti programmatici facevano perno su template statici in cui venivano sostituite poche variabili isolate (come la città o il nome del prodotto). I motori di ricerca identificano rapidamente queste strutture, etichettandole come pagine doorway o contenuti di scarso valore, revocandone l’indicizzazione.
L’inserimento di modelli contestuali nel ciclo programmatico consente invece di modulare la struttura della narrazione, redigere analisi introduttive uniche basate sui parametri specifici della pagina e sintetizzare considerazioni analitiche dedicate.
I dettagli tecnici per implementare questa architettura senza rischi di penalizzazione sono disponibili in Ai-powered content magic: instantly boost your website’s visibility with automated copywriting wizards.
Rendering Edge e Performance Web
I Core Web Vitals influenzano direttamente il ranking organico. Quando si producono contenuti su larga scala, va assolutamente evitata la generazione dinamica tramite LLM durante il ciclo di richiesta-risposta del client. Interrogare un modello a runtime aggiunge diversi secondi di latenza, compromettendo il Time to First Byte (TTFB) e il Largest Contentful Paint (LCP).
L’approccio corretto prevede un’architettura asincrona event-driven:
1. Aggiornamento asincrono dei contenuti tramite webhook o job batch pianificati.
2. Rendering delle pagine in HTML statico in fase di build o memorizzazione nella cache edge dei CDN con logiche stale-while-revalidate.
3. Erogazione di documenti pre-compilati con tempi di risposta inferiori ai 100 millisecondi.
—
Pipeline di Ottimizzazione Continua e Controllo Qualità
Scalare un’architettura editoriale automatizzata senza un framework di revisione continua genera debito tecnico e contenutistico. Hallucination non rilevate, metriche obsolete e disallineamento semantico possono erodere la presenza organica di un sito nel medio periodo.
L’implementazione di cicli di manutenzione automatizzati garantisce la stabilità dei ranking nel tempo. Le linee guida per la gestione del ciclo di vita dei contenuti sono illustrate in Revolutionizing your website with ai-powered content optimization techniques.
“`
┌────────────────────────────────────────────────────────┐
│ Loop Continuo di Audit │
└────────────────────────────────────────────────────────┘
│
┌──────────────────┴──────────────────┐
▼ ▼
┌───────────────────────┐ ┌───────────────────────┐
│ Sync Search Console │ │ Cosine Similarity Vett|
│ (Monitoraggio CTR/Pos)│ │ (Rilevamento Drift) │
└───────────────────────┘ └───────────────────────┘
│ │
└──────────────────┬──────────────────┘
▼
┌───────────────────────────────────────────────────────────┐
│ Worker di Rigenerazione Dinamica │
│ (Rinnova entità, valida i dati e invia le sitemap) │
└───────────────────────────────────────────────────────────┘
“`
Framework di Validazione Automatica
Prima di distribuire il testo generato in produzione, il dato deve superare precisi filtri di convalida:
* **Rilevamento delle Allucinazioni tramite Doppia Verifica:** Confronto delle asserzioni fattuali, dei dati numerici e delle citazioni con le fonti di partenza, impiegando un secondo passaggio di controllo a temperatura zero.
* **Calcolo della Distanza Vettoriale Semantica:** Misurazione della similarità coseno tra gli embedding del testo elaborato e quelli dei primi tre competitor organici. Una similarità inferiore a 0,78 evidenzia la mancata copertura di nodi tematici fondamentali. Un valore superiore a 0,98 comporta il rischio di filtri algoritmici per carenza di Information Gain. La soglia ottimale si colloca tra 0,82 e 0,90.
* **Controllo dei Link Interni e del Grafo di Navigazione:** Verifica dell’allineamento tra ancore testuali e URL interni censiti nel database del CMS. I modelli generativi tendono a inventare percorsi inesistenti o ancore incoerenti; ogni link deve essere validato da un parser su whitelist interna prima del rilascio.
—
Costruire un Motore Automatizzato di Copywriting
La seguente implementazione illustra la configurazione di una pipeline professionale tramite Python, API OpenAI e webhook per CMS headless.
Step 1: Ingestione dell’Intento SERP ed Estrazione delle Entità
Recuperare i dati dei principali competitor tramite un’API SERP dedicata. Estrarre i titoli, eseguire un parser NER ed elaborare la distribuzione di frequenza delle entità tematiche irrinunciabili.
“`python
# snippet: entity_extraction_pipeline.py
import spacy
from collections import Counter
nlp = spacy.load(“en_core_web_md”)
def extract_serp_entities(competitor_texts):
combined_text = ” “.join(competitor_texts)
doc = nlp(combined_text)
# Filtro su entità tecniche, di prodotto e organizzative
valid_labels = {“ORG”, “PRODUCT”, “GPE”, “NORP”, “FAC”}
entities = [ent.text.lower() for ent in doc.ents if ent.label_ in valid_labels]
# Restituisce le 25 entità a più alta frequenza
return [item[0] for item in Counter(entities).most_common(25)]
“`
Step 2: Definizione del Prompt di Esecuzione Strutturato
Impostare un system prompt rigoroso che imponga un registro formale e tecnico, escluda formule promozionali generiche e richieda l’output in un payload JSON conforme alle specifiche.
“`markdown
SYSTEM PROMPT:
Sei un senior technical copywriter specializzato in programmatic SEO.
Genera un articolo tecnico approfondito e autorevole basato sulle specifiche fornite.
REGOLE:
1. Non utilizzare formule di transizione banali o vuoto gergo pubblicitario.
2. Mantieni un registro rigoroso, diretto e pragmatico per tutto il documento.
3. Integra in modo naturale e contestuale ogni elemento presente in REQUIRED_ENTITIES.
4. L’output deve rispettare tassativamente lo schema JSON richiesto. Non includere testo di apertura o commenti markdown fuori dal JSON.
PARAMETRI INPUT:
– PRIMARY_KEYWORD: AI writing
– TOPIC: Infrastruttura di Produzione Editoriale Automatizzata
– REQUIRED_ENTITIES: [“vector search”, “information gain”, “BM25”, “embeddings”, “schema validation”]
“`
Step 3: Esecuzione della Generazione e Controlli di Qualità
Inviare la richiesta alle API, validare l’oggetto JSON restituito ed eseguire i controlli di conformità sintattica e semantica.
“`python
# snippet: generation_controller.py
import json
from openai import OpenAI
client = OpenAI()
def generate_optimized_asset(prompt_payload):
response = client.chat.completions.create(
model=”gpt-4o-2024-08-06″,
response_format={“type”: “json_object”},
temperature=0.3, # La bassa temperatura garantisce aderenza strutturale
messages=[
{“role”: “system”, “content”: prompt_payload[“system”]},
{“role”: “user”, “content”: prompt_payload[“user”]}
]
)
article_data = json.loads(response.choices[0].message.content)
# Test di verifica delle entità obbligatorie
body_flat = ” “.join([sec[“body_markdown”] for sec in article_data[“sections”]])
for entity in prompt_payload[“required_entities”]:
assert entity.lower() in body_flat.lower(), f”Entità obbligatoria mancante: {entity}”
return article_data
“`
Step 4: Compilazione degli Schemi e Invio al CMS
Convertire il JSON validato in Markdown strutturato, associare il markup JSON-LD (come `Article` e `TechArticle`) e distribuire l’asset direttamente tramite l’endpoint API del proprio CMS.
—
Monitoraggio delle Prestazioni: Metriche Tecniche Essenziali
Il rendimento di una pipeline di pubblicazione automatizzata si misura tramite metriche analitiche specifiche, non dal volume grezzo di parole prodotte:
1. Crawl-to-Index Ratio
* **Definizione:** La quota percentuale di URL generati che, a seguito della scansione dei crawler, passa allo stato “Indicizzata” in Google Search Console.
* **Benchmark:** Valore superiore all’85%. Una concentrazione elevata di pagine in “Rilevata, ma attualmente non indicizzata” segnala ridondanza tematica, scarso valore informativo o criticità nell’architettura dei link interni.
2. Entity Alignment Score
* **Definizione:** Il livello di convergenza tra le entità target pianificate e quelle effettivamente estratte da Google (analizzabili tramite Google Cloud Natural Language API).
* **Benchmark:** Allineamento superiore al 75% tra l’intento di query analizzato e i topic identificati nella pagina.
3. Click-Through Efficiency (CTR vs. Posizione Attesa)
* **Definizione:** Scostamento tra il CTR organico registrato e la baseline media di settore calcolata per la medesima posizione in SERP.
* **Benchmark:** Una varianza positiva indica che i metadati generati intercettano con precisione l’intento di ricerca dell’utente.
4. Index Decay Rate
* **Definizione:** La velocità con cui un URL programmatico perde posizioni o impression dopo l’iniziale fase di posizionamento.
* **Benchmark:** Assenza di decadimento nell’arco di 90 giorni. Un calo repentino evidenzia un’insufficiente capacità di engagement o un valore di Information Gain inadeguato rispetto ai competitor.
—
Sviluppi Strategici
Implementare un sistema di crescita organica sfruttando l’**AI writing** è a tutti gli effetti un progetto di ingegneria del software, non una sperimentazione di stesura creativa. I team che gestiscono il copywriting automatizzato come una pipeline strutturata—unendo scraping competitivo, concatenazione avanzata dei prompt, convalida deterministica dei dati e ottimizzazione del front-end—costruiscono un vantaggio competitivo duraturo nei risultati di ricerca.
L’attenzione deve convergere sull’architettura dei sistemi: applicando alla produzione editoriale la medesima disciplina di testing richiesta dal codice applicativo, le piattaforme di pubblicazione forniranno valore misurabile e stabile sia agli utenti che ai motori di ricerca.
Pronto a scalare la tua infrastruttura digitale?
Non lasciare che i colli di bottiglia tecnici rallentino la tua crescita. Discuti del tuo progetto su Ai-powered content magic: instantly boost your website’s visibility with automated copywriting wizards direttamente con i nostri esperti senior di Low Cost Web Agency.