Gli algoritmi dei motori di ricerca non valutano più il testo come sequenze isolate di parole chiave. I moderni sistemi di information retrieval interpretano i contenuti digitali attraverso spazi vettoriali multidimensionali, relazioni tra entità e metriche predittive di soddisfazione dell’utente. Le architetture dei motori di ricerca — tra cui RankBrain, BERT e MUM di Google — sono passate dal semplice lexical matching a una comprensione semantica profonda.
Per consolidare una visibilità organica duratura e accelerare i tassi di conversione, i siti enterprise devono integrare workflow di ottimizzazione algoritmica. L’implementazione dell’IA nell’infrastruttura editoriale trasforma la produzione dei contenuti: da una stesura soggettiva a una vera e propria ingegneria dei contenuti basata sui dati. Questa guida analizza le dinamiche matematiche, architetturali ed editoriali necessarie per convertire le proprietà web in asset organici ad alto rendimento.
—
1. La Meccanica del Moderno Information Retrieval: Vettori e Grafi Semantici
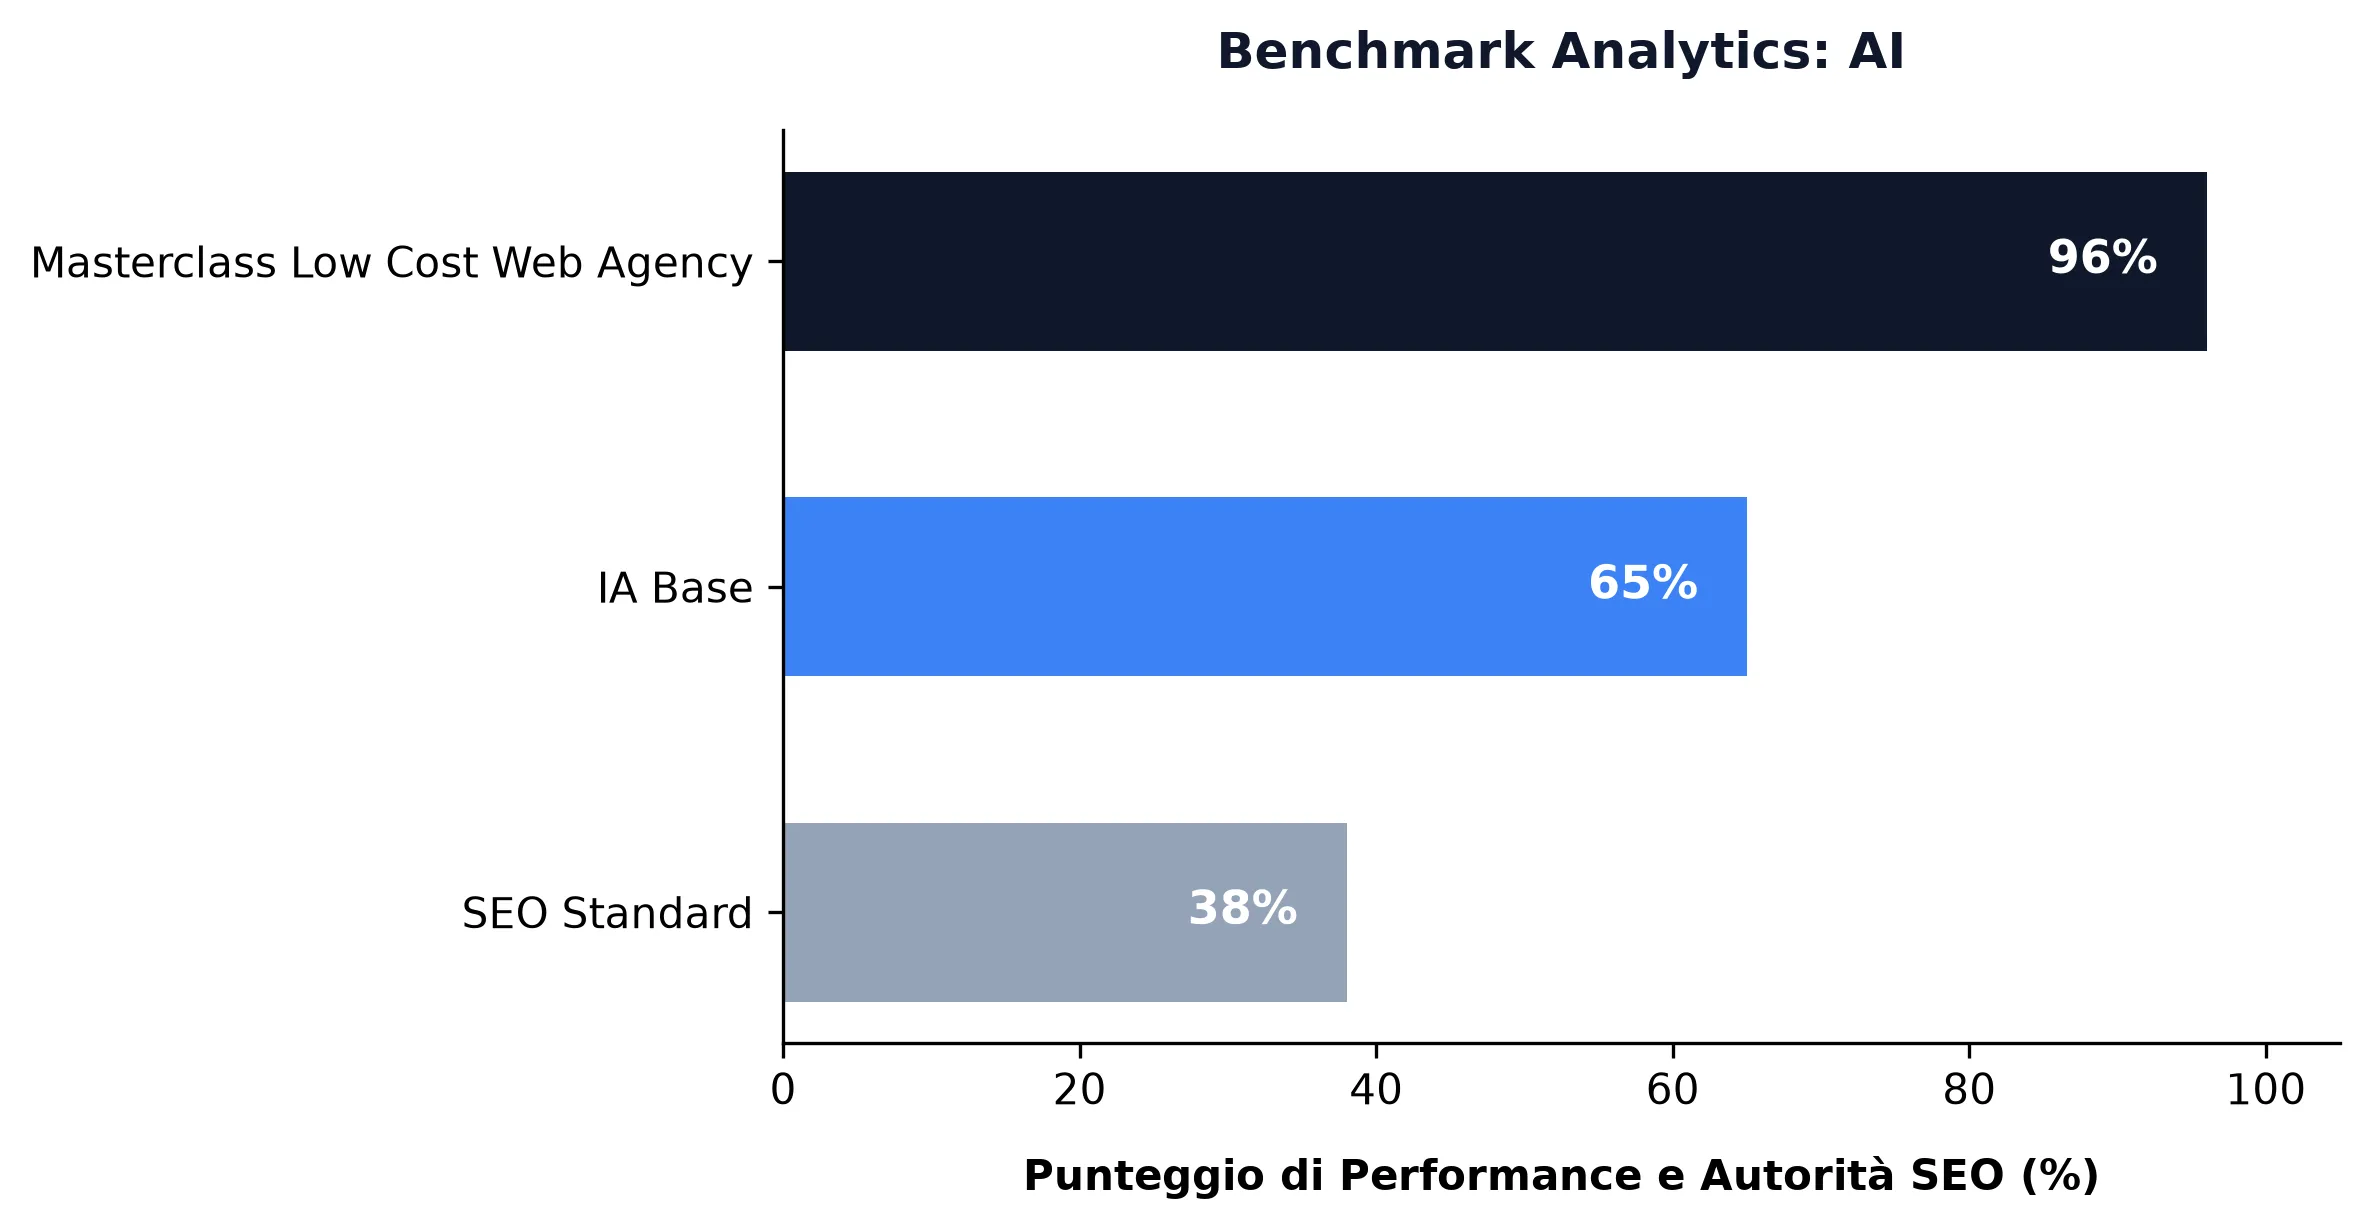
Benchmark de performance : AI
La SEO tradizionale si basava su calcoli di term frequency-inverse document frequency (TF-IDF). Oggi, i modelli linguistici di grandi dimensioni (LLM) e le reti neurali alimentano motori di recupero capaci di decodificare contesto, topical authority e le sfumature dell’intento di ricerca.
“`
Vector Embedding e Dense Passage Retrieval
Le piattaforme di ricerca convertono documenti e query in vettori numerici ad alta dimensionalità (tipicamente da 768 a 1536 dimensioni). Quando un utente cerca una soluzione, il motore non si limita a verificare corrispondenze di stringhe alfanumeriche; misura la prossimità spaziale del vettore della query rispetto ai vettori dei documenti all’interno di un sistema di coordinate condiviso, sfruttando la cosine similarity:
$$text{Cosine Similarity}(A, B) = frac{A cdot B}{|A| |B|} = frac{sum_{i=1}^{n} A_i B_i}{sqrt{sum_{i=1}^{n} A_i^2} sqrt{sum_{i=1}^{n} B_i^2}}$$
Se il testo presenta una distanza contestuale eccessiva rispetto ai concetti cardine, alle sotto-entità e agli attributi associati al topic, le pagine non emergeranno durante le operazioni di Dense Passage Retrieval (DPR). L’impiego di modelli IA per analizzare la copertura semantica permette di identificare le lacune concettuali che gli autori umani tendono sistematicamente a trascurare.
Estrazione delle Entità e Allineamento ai Knowledge Graph
I motori di ricerca gestiscono vasti knowledge graph: reti strutturate di entità (persone, luoghi, concetti, tecnologie) e delle loro relazioni codificate. Gli algoritmi analizzano l’HTML grezzo tramite tecniche di Natural Language Processing (NLP) come la Named Entity Recognition (NER) per individuare:
* **Entità Primarie del Topic:** Il fulcro tematico fondante dell’URI.
Esplicitando queste relazioni con una sintassi precisa e markup semantici di schema, si azzera l’ambiguità algoritmica. Questa precisione semantica risponde in modo diretto ai criteri esposti nelle linee guida di Google Search Central relativi all’autorevolezza tematica e all’indicizzazione a elevata utilità.
—
2. Ingegneria On-Page Dinamica tramite Analisi Algoritmica
Applicare l’IA all’ottimizzazione editoriale non si riduce alla generazione automatica di paragrafi con modelli generativi. Significa decodificare la densità informativa, eliminare le ridondanze semantiche e strutturare le risposte all’intento dell’utente riducendo al minimo ogni attrito cognitivo.
“`
Espansione Topica Automatizzata e Costruzione dei Cluster
Per conquistare autorità su una specifica verticale tecnica o commerciale, un singolo articolo non è sufficiente. Occorre un ecosistema interconnesso di documenti semanticamente correlati. Algoritmi di clustering basati sul machine learning (come k-means o clustering gerarchico agglomerativo) possono elaborare migliaia di risultati in SERP e catalogarli in base all’intento di ricerca:
1. **Intento Informazionale:** Contenuti formativi top-of-funnel dedicati ai meccanismi generali.
Strutturare cluster semantici completi tramite IA evita la cannibalizzazione interna delle keyword. Ogni URL del dominio presidia una specifica porzione dello spazio vettoriale, rafforzando il topic principale attraverso una maglia bidirezionale di link interni. Per approfondire come l’intelligenza artificiale colleghi i fattori di ranking semantici all’esperienza utente, consulta l’analisi su Contenuti creati dall’IA: il futuro della maestria tra SEO e web design .
Ottimizzazione del Livello Meta: Precisione Programmatica
I metadati costituiscono il primo punto di contatto tra gli algoritmi di ricerca, gli utenti in target e la presenza digitale del brand. Scrivere manualmente le meta description per migliaia di pagine di catalogo o URL programmatici genera disomogeneità stilistica, densità di parole chiave inadeguata e opportunità di click-through sprecate.
L’adozione di modelli dedicati e ottimizzati per la generazione dei meta asset garantisce il rispetto rigoroso dei vincoli di lunghezza (tipicamente tra 150 e 158 caratteri, o 960 pixel su schermi mobile), una naturale integrazione delle entità e call-to-action efficaci. Scopri i dettagli operativi di questo approccio in Meta descrizioni create dall’IA: la formula segreta per un boost immediato di visibilità .
Generazione di Headline e Ingegnerizzazione del Click-Through Rate (CTR)
I titoli di pagina (`
` e `</p>
<h1>`) determinano sia la pertinenza di posizionamento sia il tasso di interazione in SERP. La formulazione algoritmica dei titoli valuta gli storici di click pattern, l’intensità emotiva e i trigger cognitivi rapportandoli ai dati di ricerca in tempo reale.</p>
<p>“`<br />
Headline Generica Standard:<br />
“Come Ottimizzare i Contenuti del Tuo Sito Web con gli Strumenti”</p>
<p>Variante Algoritmica ad Alta Salienza:<br />
“Ottimizzazione Algoritmica dei Contenuti: 7 Framework Architetturali per una Maggiore Densità di Ricerca”<br />
“`</p>
<p>La versione ottimizzata mantiene un’elevata salienza d’entità (“Ottimizzazione Algoritmica dei Contenuti”), formalizza una proposta di valore specifica (“7 Framework Architetturali”) e intercetta direttamente l’intento di ricerca tecnico. Affina i protocolli redazionali esplorando le metodologie descritte in <a href="https://www.lowcostwebagency.com/?p=50430">Titoli creati dall’IA: aumenta i tuoi clic con titoli di notizie automatizzati</a>.</p>
<p>—</p>
<h2>3. Unificazione di Sistemi di Copywriting, Schema Strutturali e Framework Visivi</h2>
<p>L’ottimizzazione testuale rappresenta solo una delle dimensioni di un ecosistema di visibilità organica. I motori di ricerca premiano la coerenza tecnica: il copy deve integrarsi con i dati strutturati, l’architettura cognitiva di pagina e i percorsi di conversione.</p>
<h3>Composizione Algoritmica dei Contenuti e Scalabilità Editoriale</h3>
<p>I modelli di IA generativa, guidati da prompt chain strutturate e vincoli a livello di sistema, possono generare prime stesure complete, sintesi di categorie complesse e trattazioni analitiche a ritmi impossibili per un team tradizionale. I testi grezzi privi di controllo soffrono tuttavia di scarsa varietà lessicale, strutture sintattiche ripetitive e derive fattuali.</p>
<p>“`python<br />
# Architettura Concettuale: Pipeline Automatizzata di Verifica dei Contenuti<br />
def evaluate_content_quality(draft_text, target_entities, corpus_embeddings):<br />
# Step 1: Calcolo della densità delle entità<br />
extracted_entities = run_ner_model(draft_text)<br />
entity_coverage = len(set(extracted_entities) & set(target_entities)) / len(target_entities)</p>
<p> # Step 2: Calcolo della distanza vettoriale semantica<br />
draft_vector = generate_embeddings(draft_text)<br />
relevance_score = cosine_similarity(draft_vector, corpus_embeddings.mean_vector)</p>
<p> # Step 3: Rilevamento allucinazioni o incongruenze fattuali<br />
fact_check_flags = cross_reference_knowledge_base(draft_text)</p>
<p> return {<br />
“entity_coverage”: entity_coverage,<br />
“semantic_relevance”: relevance_score,<br />
“review_required”: len(fact_check_flags) > 0<br />
}<br />
“`</p>
<p>Configurando flussi operativi che accorpano la generazione assistita a rigidi protocolli di validazione programmatica, le aziende espandono l’indice delle proprie pagine senza compromettere l’integrità redazionale. Per studiare le architetture alla base di questi processi, consulta <a href="https://www.lowcostwebagency.com/ai-writing-magic-instantly-boost/">La magia della scrittura con IA: aumenta all’istante la visibilità del tuo sito con maghi del copywriting automatizzato</a>.</p>
<h3>Adattamento Strutturale dell’Interfaccia e Layout Orientati alla Conversione</h3>
<p>Un contenuto che si posiziona ai vertici ma non trattiene l’utente degrada i segnali di coinvolgimento e incrementa il bounce rate. L’IA consente di analizzare i comportamenti di navigazione tramite mappe di calore predittive, stime della profondità di scroll e modifiche dinamiche al DOM.</p>
<p>Questi sistemi consentono di proporre layout differenziati in base all’intento della sorgente di traffico:</p>
<p>* **Profili Tecnici:** Visualizzazione automatica di indici di documentazione avanzati, tabelle dei contenuti interattive e ambienti di codice espandibili.<br />
* **Profili Decisionali Commerciali:** Evidenziazione di box di riepilogo esecutivi, calcolatori immediati del ROI e pulsanti CTA posizionati a fianco delle sintesi strategiche.</p>
<p>Per un’analisi dettagliata delle strutture di pagina algoritmiche capaci di massimizzare il rendimento delle sessioni, esamina <a href="https://www.lowcostwebagency.com/it/revolutionizing-web-design-aipowered-layouts/">Rivoluzionare il web design: layout basati sull’IA che trasformano le visite in vendite</a>.</p>
<p>—</p>
<h2>4. Blueprint Operativo di Implementazione: Costruire una Pipeline Algoritmica</h2>
<p>L’implementazione di una pipeline aziendale richiede il superamento dei prompt estemporanei, adottando un’architettura ingegneristica standardizzata e ripetibile.</p>
<p>“`<br />
┌─────────────────────────────────────────────────────────────┐<br />
│ PIPELINE DI DEPLOYMENT PER L’OTTIMIZZAZIONE TRAMITE IA │<br />
└─────────────────────────────────────────────────────────────┘<br />
│<br />
├─ Fase 1: Estrazione del Corpus e Gap Analysis Semantica<br />
│ ├─ Scraping dei primi 20 documenti posizionati per la query target<br />
│ ├─ Esecuzione di Named Entity Recognition (NER) sul corpus competitivo<br />
│ └─ Calcolo del delta semantico (argomenti scoperti ed entità mancanti)<br />
│<br />
├─ Fase 2: Sintesi della Conoscenza e Information Gain<br />
│ ├─ Aggregazione di dati proprietari enterprise, metriche e case study<br />
│ ├─ Costruzione di prompt deterministici con vincoli rigidi<br />
│ └─ Stesura di moduli incentrati esclusivamente su dati inediti<br />
│<br />
├─ Fase 3: Parsing Tecnico e Integrazione dello Schema<br />
│ ├─ Generazione programmatica di schemi JSON-LD (Article, FAQ, Product)<br />
│ ├─ Ottimizzazione gerarchica dei tag di intestazione (H1 -> H2 -> H3)<br />
│ └─ Validazione della sintassi HTML semantica secondo standard W3C<br />
│<br />
└─ Fase 4: Monitoraggio Vettoriale Continuo e Cicli di Refresh<br />
├─ Tracciamento ranking parole chiave e feature in SERP<br />
├─ Misurazione del drift degli embedding ogni 90 giorni sui nuovi vettori SERP<br />
└─ Esecuzione di task di ri-ottimizzazione per gli URL in flessione<br />
“`</p>
<h3>Fase 1: Estrazione del Corpus e Gap Analysis Semantica</h3>
<p>L’analisi parte dall’interrogazione dell’indice competitivo. Estrai i 20 URL con il miglior posizionamento per la query commerciale di riferimento e converti il testo non strutturato in una matrice di entità:</p>
<p>1. **Estrazione delle Entità Dominanti:** Applica un parser NLP (come spaCy, Google Cloud Natural Language o pipeline transformer custom) per isolare entità ad alta salienza e triplette linguistiche (*soggetto-predicato-oggetto*).<br />
2. **Calcolo dei Baricentri Vettoriali:** Calcola il centroide semantico (la posizione media del vettore matematico) dei primi 3 risultati di ricerca.<br />
3. **Identificazione dei Delta Informativi:** Mappa i concetti trattati dai documenti leader che risultano del tutto assenti nella pagina in lavorazione.</p>
<h3>Fase 2: Information Gain e Iniezione di Valore Unico</h3>
<p>I brevetti di Google sull’Information Gain confermano che i motori di ricerca assegnano un punteggio preferenziale ai documenti che forniscono *informazioni inedite* rispetto a quelle già consultate dall’utente nelle pagine concorrenti. Rielaborare il testo della SERP con sinonimi porta inevitabilmente alla stagnazione del ranking.</p>
<p>* **Integrazione di Metriche Proprietarie:** Inserisci nei testi case study interni, dati analitici di conversione anonimizzati e rilevazioni prestazionali reali.<br />
* **Prospettive Tecniche Non Allineate:** Sfrutta l’IA per sottoporre a stress-test le tesi esposte, individuando casi limite e vincoli architetturali omessi dai concorrenti.<br />
* **Dati Tecnici Strutturati:** Traduci le procedure complesse in matrici comparative, checklist operative e snippet eseguibili.</p>
<h3>Fase 3: Parsing Tecnico e Ingegnerizzazione dello Schema</h3>
<p>Isola il testo ottimizzato all’interno di una marcatura semantica rigorosa. Gli algoritmi non devono dedurre per approssimazione l’autore, una guida sequenziale o una definizione tecnica:</p>
<p>“`json<br />
{<br />
“@context”: “https://schema.org”,<br />
“@type”: “TechArticle”,<br />
“headline”: “Advanced Content Optimization: Algorithmic Architecture and Semantic Search”,<br />
“description”: “A comprehensive masterclass on utilizing AI for vector search optimization, entity enrichment, and programmatic editorial performance.”,<br />
“author”: {<br />
“@type”: “Organization”,<br />
“name”: “Low Cost Web Agency”,<br />
“url”: “https://www.lowcostwebagency.com”<br />
},<br />
“keywords”: “AI, content optimization, vector search, semantic SEO, dense passage retrieval”,<br />
“about”: [<br />
{<br />
“@type”: “Thing”,</p>
<div class="lowcost-cta-box" style="background: #f8fafc;border-left: 4px solid #0f172a;padding: 25px;margin: 40px 0;border-radius: 0 8px 8px 0">
<h3 style="margin-top: 0;color: #0f172a;font-size: 1.3em">Pronto a scalare la tua infrastruttura digitale?</h3>
<p style="color: #334155;line-height: 1.6">Non lasciare che i colli di bottiglia tecnici rallentino la tua crescita. Discuti del tuo progetto su <strong>Revolutionizing your website with ai-powered content optimization techniques</strong> direttamente con i nostri esperti senior di Low Cost Web Agency.</p>
<p style="margin-bottom: 0"><a href="https://wa.me/919786495150" target="_blank" style="display: inline-block;background: #25D366;color: white;padding: 12px 24px;border-radius: 6px;text-decoration: none;font-weight: bold" rel="noopener">💬 Contattaci su WhatsApp (Solo messaggi: +919786495150)</a></p>
</p></div>
</div>
<span class="vcard rich-snippet-hidden"><span class="fn"><a href="https://www.lowcostwebagency.com/it/author/alex/" rel="author">Alexandre MENINI</a></span></span> <section class="related-posts single-related-posts">
<div class="fusion-title fusion-title-size-two sep-single sep-solid" style="margin-top:0px;margin-bottom:30px;">
<h2 class="title-heading-left" style="margin:0;">
Articoli simili </h2>
<span class="awb-title-spacer"></span>
<div class="title-sep-container">
<div class="title-sep sep-single sep-solid"></div>
</div>
</div>
<div class="awb-carousel awb-swiper awb-swiper-carousel fusion-carousel-title-below-image" data-imagesize="auto" data-metacontent="yes" data-autoplay="yes" data-touchscroll="no" data-columns="3" data-itemmargin="20px" data-itemwidth="180" data-scrollitems="1">
<div class="swiper-wrapper">
<div class="swiper-slide">
<div class="fusion-carousel-item-wrapper">
<div class="fusion-image-wrapper" aria-haspopup="true">
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="1344" height="768" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost.webp" class="attachment-full size-full wp-post-image" alt="Lo strumento di copywriting basato sull'intelligenza artificiale aumenta rapidamente la visibilità del sito" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-200x114.webp 200w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-400x229.webp 400w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-600x343.webp 600w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-800x457.webp 800w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-1200x686.webp 1200w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost.webp 1344w" data-sizes="(min-width: 2200px) 100vw, (min-width: 824px) 333px, (min-width: 732px) 499px, (min-width: 640px) 732px, " title="La magia dei contenuti basati sull’IA: aumenta all’istante la visibilità del tuo sito web con le guide automatizzate per la creazione di testi"><div class="fusion-rollover">
<div class="fusion-rollover-content">
<a class="fusion-rollover-link" href="https://www.lowcostwebagency.com/it/ai-copywriting-aumenta-la-visibilita/">La magia dei contenuti basati sull’IA: aumenta all’istante la visibilità del tuo sito web con le guide automatizzate per la creazione di testi</a>
<a class="fusion-link-wrapper" href="https://www.lowcostwebagency.com/it/ai-copywriting-aumenta-la-visibilita/" aria-label="La magia dei contenuti basati sull’IA: aumenta all’istante la visibilità del tuo sito web con le guide automatizzate per la creazione di testi"></a>
</div>
</div>
</div>
<h4 class="fusion-carousel-title">
<a class="fusion-related-posts-title-link" href="https://www.lowcostwebagency.com/it/ai-copywriting-aumenta-la-visibilita/" target="_self" title="La magia dei contenuti basati sull’IA: aumenta all’istante la visibilità del tuo sito web con le guide automatizzate per la creazione di testi">La magia dei contenuti basati sull’IA: aumenta all’istante la visibilità del tuo sito web con le guide automatizzate per la creazione di testi</a>
</h4>
<div class="fusion-carousel-meta">
<span class="fusion-date">Ottobre 11th, 2026</span>
<span class="fusion-inline-sep">|</span>
<span><a href="https://www.lowcostwebagency.com/it/ai-copywriting-aumenta-la-visibilita/#respond">0 Comments</a></span>
</div><!-- fusion-carousel-meta -->
</div><!-- fusion-carousel-item-wrapper -->
</div>
<div class="swiper-slide">
<div class="fusion-carousel-item-wrapper">
<div class="fusion-image-wrapper" aria-haspopup="true">
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="1344" height="768" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret.webp" class="attachment-full size-full wp-post-image" alt="AI-generated metadata for enhanced online visibility" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-200x114.webp 200w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-400x229.webp 400w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-600x343.webp 600w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-800x457.webp 800w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-1200x686.webp 1200w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret.webp 1344w" data-sizes="(min-width: 2200px) 100vw, (min-width: 824px) 333px, (min-width: 732px) 499px, (min-width: 640px) 732px, " title="Descrizioni meta ai-generated: il segreto per un'incremento immediato di visibilità"><div class="fusion-rollover">
<div class="fusion-rollover-content">
<a class="fusion-rollover-link" href="https://www.lowcostwebagency.com/it/meta-description-con-ia-visibilita/">Descrizioni meta ai-generated: il segreto per un’incremento immediato di visibilità</a>
<a class="fusion-link-wrapper" href="https://www.lowcostwebagency.com/it/meta-description-con-ia-visibilita/" aria-label="Descrizioni meta ai-generated: il segreto per un’incremento immediato di visibilità"></a>
</div>
</div>
</div>
<h4 class="fusion-carousel-title">
<a class="fusion-related-posts-title-link" href="https://www.lowcostwebagency.com/it/meta-description-con-ia-visibilita/" target="_self" title="Descrizioni meta ai-generated: il segreto per un’incremento immediato di visibilità">Descrizioni meta ai-generated: il segreto per un’incremento immediato di visibilità</a>
</h4>
<div class="fusion-carousel-meta">
<span class="fusion-date">Ottobre 10th, 2026</span>
<span class="fusion-inline-sep">|</span>
<span><a href="https://www.lowcostwebagency.com/it/meta-description-con-ia-visibilita/#respond">0 Comments</a></span>
</div><!-- fusion-carousel-meta -->
</div><!-- fusion-carousel-item-wrapper -->
</div>
<div class="swiper-slide">
<div class="fusion-carousel-item-wrapper">
<div class="fusion-image-wrapper" aria-haspopup="true">
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="1344" height="768" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of.webp" class="attachment-full size-full wp-post-image" alt="AI-generated content for SEO and web design success" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-200x114.webp 200w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-400x229.webp 400w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-600x343.webp 600w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-800x457.webp 800w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-1200x686.webp 1200w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of.webp 1344w" data-sizes="(min-width: 2200px) 100vw, (min-width: 824px) 333px, (min-width: 732px) 499px, (min-width: 640px) 732px, " title="Contenuti ai-creati: il futuro dell'seo e della maestria nel design web"><div class="fusion-rollover">
<div class="fusion-rollover-content">
<a class="fusion-rollover-link" href="https://www.lowcostwebagency.com/it/contenuti-ai-il-futuro-di/">Contenuti ai-creati: il futuro dell’seo e della maestria nel design web</a>
<a class="fusion-link-wrapper" href="https://www.lowcostwebagency.com/it/contenuti-ai-il-futuro-di/" aria-label="Contenuti ai-creati: il futuro dell’seo e della maestria nel design web"></a>
</div>
</div>
</div>
<h4 class="fusion-carousel-title">
<a class="fusion-related-posts-title-link" href="https://www.lowcostwebagency.com/it/contenuti-ai-il-futuro-di/" target="_self" title="Contenuti ai-creati: il futuro dell’seo e della maestria nel design web">Contenuti ai-creati: il futuro dell’seo e della maestria nel design web</a>
</h4>
<div class="fusion-carousel-meta">
<span class="fusion-date">Ottobre 9th, 2026</span>
<span class="fusion-inline-sep">|</span>
<span><a href="https://www.lowcostwebagency.com/it/contenuti-ai-il-futuro-di/#respond">0 Comments</a></span>
</div><!-- fusion-carousel-meta -->
</div><!-- fusion-carousel-item-wrapper -->
</div>
<div class="swiper-slide">
<div class="fusion-carousel-item-wrapper">
<div class="fusion-image-wrapper" aria-haspopup="true">
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="1344" height="768" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts.webp" class="attachment-full size-full wp-post-image" alt="AI-driven web layouts increasing conversions and sales" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-200x114.webp 200w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-400x229.webp 400w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-600x343.webp 600w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-800x457.webp 800w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-1200x686.webp 1200w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts.webp 1344w" data-sizes="(min-width: 2200px) 100vw, (min-width: 824px) 333px, (min-width: 732px) 499px, (min-width: 640px) 732px, " title="Rinnovamento del design web: layout ai che convertono visite in vendite"><div class="fusion-rollover">
<div class="fusion-rollover-content">
<a class="fusion-rollover-link" href="https://www.lowcostwebagency.com/it/web-design-con-ai-layout/">Rinnovamento del design web: layout ai che convertono visite in vendite</a>
<a class="fusion-link-wrapper" href="https://www.lowcostwebagency.com/it/web-design-con-ai-layout/" aria-label="Rinnovamento del design web: layout ai che convertono visite in vendite"></a>
</div>
</div>
</div>
<h4 class="fusion-carousel-title">
<a class="fusion-related-posts-title-link" href="https://www.lowcostwebagency.com/it/web-design-con-ai-layout/" target="_self" title="Rinnovamento del design web: layout ai che convertono visite in vendite">Rinnovamento del design web: layout ai che convertono visite in vendite</a>
</h4>
<div class="fusion-carousel-meta">
<span class="fusion-date">Ottobre 9th, 2026</span>
<span class="fusion-inline-sep">|</span>
<span><a href="https://www.lowcostwebagency.com/it/web-design-con-ai-layout/#respond">0 Comments</a></span>
</div><!-- fusion-carousel-meta -->
</div><!-- fusion-carousel-item-wrapper -->
</div>
<div class="swiper-slide">
<div class="fusion-carousel-item-wrapper">
<div class="fusion-image-wrapper" aria-haspopup="true">
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="1344" height="768" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility.webp" class="attachment-full size-full wp-post-image" alt="AI-driven SEO tool optimizing keywords for better visibility" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-200x114.webp 200w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-400x229.webp 400w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-600x343.webp 600w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-800x457.webp 800w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-1200x686.webp 1200w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility.webp 1344w" data-sizes="(min-width: 2200px) 100vw, (min-width: 824px) 333px, (min-width: 732px) 499px, (min-width: 640px) 732px, " title="L'ottimizzazione delle parole chiave con l'intelligenza artificiale: automatizzare per massimizzare la visibilità"><div class="fusion-rollover">
<div class="fusion-rollover-content">
<a class="fusion-rollover-link" href="https://www.lowcostwebagency.com/it/seo-e-ia-automatizza-le/">L’ottimizzazione delle parole chiave con l’intelligenza artificiale: automatizzare per massimizzare la visibilità</a>
<a class="fusion-link-wrapper" href="https://www.lowcostwebagency.com/it/seo-e-ia-automatizza-le/" aria-label="L’ottimizzazione delle parole chiave con l’intelligenza artificiale: automatizzare per massimizzare la visibilità"></a>
</div>
</div>
</div>
<h4 class="fusion-carousel-title">
<a class="fusion-related-posts-title-link" href="https://www.lowcostwebagency.com/it/seo-e-ia-automatizza-le/" target="_self" title="L’ottimizzazione delle parole chiave con l’intelligenza artificiale: automatizzare per massimizzare la visibilità">L’ottimizzazione delle parole chiave con l’intelligenza artificiale: automatizzare per massimizzare la visibilità</a>
</h4>
<div class="fusion-carousel-meta">
<span class="fusion-date">Ottobre 8th, 2026</span>
<span class="fusion-inline-sep">|</span>
<span><a href="https://www.lowcostwebagency.com/it/seo-e-ia-automatizza-le/#respond">0 Comments</a></span>
</div><!-- fusion-carousel-meta -->
</div><!-- fusion-carousel-item-wrapper -->
</div>
</div><!-- swiper-wrapper -->
</div><!-- fusion-carousel -->
</section><!-- related-posts -->
</article>
</section>
<aside id="sidebar" class="sidebar fusion-widget-area fusion-content-widget-area fusion-sidebar-right fusion-blogsidebar" style="float: right;" data="">
<section id="custom_html-8" class="widget_text widget widget_custom_html" style="border-style: solid;border-color:transparent;border-width:0px;"><div class="textwidget custom-html-widget"><div style="text-align: center; padding: 20px; border: 1px solid #e2e2e2; border-radius: 12px; background: #ffffff; box-shadow: 0 2px 8px rgba(0,0,0,0.05); margin-bottom: 25px;">
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/04/alexandre-menini-digital-entrepreneur-low-cost-web-agency.webp" alt="Alexandre Menini" style="width: 130px; height: 130px; border-radius: 50%; object-fit: cover; border: 4px solid #f0f0f0; margin-bottom: 15px; display: inline-block;" width="200" height="200" />
<h3 style="margin: 0 0 5px 0; color: #333; font-size: 19px; font-family: sans-serif;">Alexandre Menini</h3>
<p style="margin: 0 0 15px 0; font-weight: 600; color: #d94141; font-style: italic; font-size: 14px; font-family: sans-serif;">Fondatore & Global Strategist</p>
<p style="line-height: 1.6; color: #444; font-size: 14px; text-align: left; font-family: sans-serif; border-top: 1px solid #eee; padding-top: 15px; margin-top: 10px;">
<strong>Imprenditore Poliglotta.</strong> Con una carriera di 34 anni costruita negli acquisti internazionali e nell'espatrio globale, Alexandre mette a frutto la sua competenza strategica per guidare <strong>Low Cost Web Agency</strong> nella fornitura di soluzioni digitali ad alte prestazioni.
</p>
</div></div></section>
<section id="recent-posts-2" class="widget widget_recent_entries" style="border-style: solid;border-color:transparent;border-width:0px;">
<div class="heading"><h4 class="widget-title">Articoli recenti</h4></div>
<ul>
<li>
<a href="https://www.lowcostwebagency.com/it/ai-copywriting-aumenta-la-visibilita/">La magia dei contenuti basati sull’IA: aumenta all’istante la visibilità del tuo sito web con le guide automatizzate per la creazione di testi</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/meta-description-con-ia-visibilita/">Descrizioni meta ai-generated: il segreto per un’incremento immediato di visibilità</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/contenuti-ai-il-futuro-di/">Contenuti ai-creati: il futuro dell’seo e della maestria nel design web</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/descrizioni-meta-ai-per-unincremento/">Descrizioni meta ai per un’incremento di visibilità immediato</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/web-design-con-ai-layout/">Rinnovamento del design web: layout ai che convertono visite in vendite</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/content-ai-rivoluziona-i-contenuti/" aria-current="page">Rivoluzionando il tuo sito web con tecniche di ottimizzazione del contenuto basate sull’intelligenza artificiale</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/seo-e-ia-automatizza-le/">L’ottimizzazione delle parole chiave con l’intelligenza artificiale: automatizzare per massimizzare la visibilità</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/come-lia-rivoluziona-la-creazione/">Come l’intelligenza artificiale sta trasformando la creazione di contenuti in varie industrie</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/nuovo-bmw-ix5-lelettrico-sfida/">Bmw’s nuovo ix5 mette l’elettricità al centro contro i rivali cinesi</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/svolta-ai-di-google-si/">Lo Spostamento Della Politica Sull’intelligenza Artificiale Di Google Accende Un Dibattito</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/amazon-stop-agli-nda-per/">Amazon Abbandona I Ndas Per Maggiore Trasparenza Sui Centri Dati</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/ai-artist-senza-freni-dipinti/">Ai Artisti Selvaggi: Dipinti Nati Dal Codice</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/doppiaggio-ai-nuova-vita-ai/">I Doppiatori Vocali Alimentati Da Ia Riportano I Film Classici Alla Vita</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/play-dos-i-cult-anni-90/">Play-dos fa rivivere i grandi classici dei videogiochi degli anni ’90 per la sperimentazione moderna con l’IA</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/tuta-bypassa-imap-falle-di/">Tuta aggira Imap per sfruttare le vulnerabilità di Nextcloud</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/nuova-sicurezza-mac-apple-blocca/">La nuova funzione di sicurezza dei Mac di Apple blocca l’accesso all’IA</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/i-gadget-ia-di-meta/">I gadget con IA di Meta stanno per arrivare in un negozio vicino a te</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/netflix-nuovo-algoritmo-rivoluziona-lo/">Il nuovo algoritmo di Netflix potrebbe rivoluzionare la tua esperienza di visione</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/lo-stato-delle-web-agency-oggi-unimmersione-globale-nella-strategia-nellintelligenza-artificiale-e-nella-crescita/">Lo stato delle Web Agency oggi | Un’immersione globale nella strategia, nell’intelligenza artificiale e nella crescita</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/come-si-sceglie-hosting/">Come si sceglie l’hosting?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/pondicherry-je-taime-la-collezione-per-gli-amanti-di-pondicherry/">Pondicherry, je t’aime – La collezione per gli amanti di Pondicherry</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/impatto-del-gdpr-sulla-seo/">Impatto del GDPR sulla SEO</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/quali-sono-gli-strumenti-e-le-tecniche-per-lottimizzazione-dei-costi-e-dei-valori/">Quali sono gli strumenti e le tecniche per l’ottimizzazione dei costi e dei valori?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/46343/">(senza titolo)</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/tutto-quello-che-ce-da-sapere-sulle-serp/">Tutto quello che c’è da sapere sulle SERP</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/low-cost-web-agency-canada-plagio-e-cybersquatting/">Low Cost Web agency Canada, plagio e cybersquatting</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/quanto-costa-un-nome-di-dominio/">Quanto costa un nome di dominio?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/perche-wix-non-e-una-buona-idea/">Perché WIX non è una buona idea?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/dare-nuova-vita-alla-vostra-attivita-con-il-rebranding/">Dare nuova vita alla vostra attività con il rebranding</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/consigli-seo-per-google/">Consigli Seo per Google</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/come-la-marketing-automation-puo-aiutare-la-vostra-azienda-a-crescere/">Come la Marketing Automation può aiutare la vostra azienda a crescere</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/5-migliori-temi-wordpress-da-themeforest/">5 migliori temi WordPress da ThemeForest</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/commercio-elettronico-14-passi-per-iniziare/">Commercio elettronico: 14 passi per iniziare</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/che-impatto-ha-la-tipografia-nel-design-e-nel-marketing/">Che impatto ha la tipografia nel design e nel marketing?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/i-6-migliori-costruttori-di-pagine-wordpress/">I 6 migliori costruttori di pagine per WordPress</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/quali-sono-i-colori-migliori-per-la-vostra-attivita/">Quali sono i colori migliori per la vostra attività?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/wpml-e-il-miglior-plugin-wordpress-per-i-siti-web-multilingue/">WPML è il miglior plugin WordPress per i siti web multilingue?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/come-preparare-la-vostra-azienda-al-metaverse/">Come preparare la vostra azienda al Metaverse?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/le-migliori-soluzioni-lms-per-wordpress/">Le migliori soluzioni LMS per WordPress</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/come-creare-un-sito-internet-la-tua-guida-completa/">Come creare un sito Internet: La tua guida completa</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/lista-di-controllo-del-marketing-in-21-passi-per-le-nuove-imprese/">Lista di controllo del marketing in 21 passi per le nuove imprese</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/come-funzionano-le-truffe-online-e-8-passi-per-evitarle/">Come funzionano le truffe online e 8 passi per evitarle</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/20-plugin-wordpress/">20 plugin WordPress da utilizzare</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/perche-avete-bisogno-di-un-sito-web-per-la-vostra-attivita/">Perché avete bisogno di un sito web per la vostra attività?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/come-vengono-utilizzati-i-social-media-per-il-marketing-e-il-business/">Come vengono utilizzati i social media per il marketing e il business?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/chatgpt-cambiera-la-seo-per-sempre/">ChatGPT cambierà la SEO per sempre?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/23-potenti-strumenti-seo-per-le-piccole-e-medie-imprese-nel-2026/">23 potenti strumenti SEO per le piccole e medie imprese</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/che-cose-un-buon-logo/">Che cos’è un buon logo?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/carenza-di-profili-it-guerra-tra-ucraina-e-russia-la-web-agency-low-cost-ti-aiuta/">Carenza di profili IT | Guerra tra Ucraina e Russia | La Web Agency Low Cost ti aiuta!</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/10-temi-wordpress-piu-popolari-nel-2026/">10 temi WordPress popolari</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/i-7-migliori-plugin-per-il-backup-e-il-ripristino-di-wordpress/">I 7 migliori plugin per il backup e il ripristino di WordPress</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/it/rank-math-o-yoast/">Rank Math o Yoast SEO? Quale plugin WordPress per il SEO del vostro sito web?</a>
</li>
</ul>
</section><section id="woocommerce_product_categories-2" class="widget woocommerce widget_product_categories" style="border-style: solid;border-color:transparent;border-width:0px;"><div class="heading"><h4 class="widget-title">Categories</h4></div><ul class="product-categories"><li class="cat-item cat-item-1867"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/audit-e-analisi/">Audit e analisi</a></li>
<li class="cat-item cat-item-1850"><a href="https://www.lowcostwebagency.com/it/low-cost/sicurezza/backup-del-sito-web/">Backup del sito Web</a></li>
<li class="cat-item cat-item-1854"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/design-it/banner/">Banner</a></li>
<li class="cat-item cat-item-1886"><a href="https://www.lowcostwebagency.com/it/low-cost/stampa/biglietti-da-visita/">Biglietti da visita</a></li>
<li class="cat-item cat-item-1871"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/marketing-dei-contenuti/blog-scrittura-di-post/">Blog - Scrittura di post</a></li>
<li class="cat-item cat-item-1881"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/sem-it/campagna-facebook/">Campagna Facebook</a></li>
<li class="cat-item cat-item-1880"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/sem-it/campagna-google-adwords/">Campagna Google Adwords</a></li>
<li class="cat-item cat-item-1882"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/sem-it/campagna-linkedin/">Campagna LinkedIn</a></li>
<li class="cat-item cat-item-1888"><a href="https://www.lowcostwebagency.com/it/low-cost/stampa/cancelleria-aziendale/">Cancelleria aziendale</a></li>
<li class="cat-item cat-item-1890"><a href="https://www.lowcostwebagency.com/it/low-cost/stampa/cancelleria-aziendale/carta-intestata/">Carta intestata</a></li>
<li class="cat-item cat-item-1892"><a href="https://www.lowcostwebagency.com/it/low-cost/stampa/cancelleria-aziendale/certificati/">Certificati</a></li>
<li class="cat-item cat-item-1863"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/sito-web-pagina/codifica-e-debug/">Codifica e debug</a></li>
<li class="cat-item cat-item-1872"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/marketing-dei-contenuti/comunicato-stampa/">Comunicato stampa</a></li>
<li class="cat-item cat-item-1873"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/marketing-dei-contenuti/correzione-di-bozze/">Correzione di bozze</a></li>
<li class="cat-item cat-item-1862"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/sito-web-pagina/crm-crm/">CRM (CRM)</a></li>
<li class="cat-item cat-item-1875"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/marketing-dei-contenuti/curriculum-lettera-di-presentazione-linkedin-bio/">Curriculum - Lettera di presentazione - Linkedin Bio</a></li>
<li class="cat-item cat-item-1851"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/design-it/">Design</a></li>
<li class="cat-item cat-item-1856"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/design-it/design-della-presentazione/">Design della presentazione</a></li>
<li class="cat-item cat-item-1847"><a href="https://www.lowcostwebagency.com/it/low-cost/hosting-e-domini/domini/">Domini</a></li>
<li class="cat-item cat-item-1855"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/design-it/edizione-immagini-e-documenti/">Edizione Immagini e Documenti</a></li>
<li class="cat-item cat-item-1857"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/design-it/edizione-video/">Edizione video</a></li>
<li class="cat-item cat-item-1891"><a href="https://www.lowcostwebagency.com/it/low-cost/stampa/cancelleria-aziendale/fatture/">Fatture</a></li>
<li class="cat-item cat-item-1858"><a href="https://www.lowcostwebagency.com/it/low-cost/firma-digitale/">Firma digitale</a></li>
<li class="cat-item cat-item-1869"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/social-media-marketing-it/gestione-dellaccount-sui-social-media/">Gestione dell'account sui social media</a></li>
<li class="cat-item cat-item-1876"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/audit-e-analisi/google-analytics-it/">Google Analytics</a></li>
<li class="cat-item cat-item-1844"><a href="https://www.lowcostwebagency.com/it/low-cost/hosting-e-domini/">Hosting e domini</a></li>
<li class="cat-item cat-item-1859"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/sito-web-pagina/html-static-design-it/">HTML & Static Design</a></li>
<li class="cat-item cat-item-1889"><a href="https://www.lowcostwebagency.com/it/low-cost/stampa/cancelleria-aziendale/inviluppi/">Inviluppi</a></li>
<li class="cat-item cat-item-1853"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/design-it/logo-design-it/">Logo Design</a></li>
<li class="cat-item cat-item-1865"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/marketing-dei-contenuti/">Marketing dei contenuti</a></li>
<li class="cat-item cat-item-1866"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/marketing-via-e-mail/">Marketing via e-mail</a></li>
<li class="cat-item cat-item-1884"><a href="https://www.lowcostwebagency.com/it/low-cost/stampa/opuscolo/">Opuscolo</a></li>
<li class="cat-item cat-item-1846"><a href="https://www.lowcostwebagency.com/it/low-cost/hosting-e-domini/ospitare/">Ospitare</a></li>
<li class="cat-item cat-item-1883"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/sem-it/piano-personalizzato/">Piano personalizzato</a></li>
<li class="cat-item cat-item-1887"><a href="https://www.lowcostwebagency.com/it/low-cost/stampa/poster-it/">Poster</a></li>
<li class="cat-item cat-item-1893"><a href="https://www.lowcostwebagency.com/it/low-cost/prodotti-compositi/">Prodotti compositi</a></li>
<li class="cat-item cat-item-1870"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/social-media-marketing-it/promozione-sui-social-media/">Promozione sui social media</a></li>
<li class="cat-item cat-item-1878"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/audit-e-analisi/ricerca-di-parole-chiave/">Ricerca di parole chiave</a></li>
<li class="cat-item cat-item-1849"><a href="https://www.lowcostwebagency.com/it/low-cost/sicurezza/security-monitor-rimozione-malware/">Security Monitor & Rimozione malware</a></li>
<li class="cat-item cat-item-1868"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/sem-it/">Sem</a></li>
<li class="cat-item cat-item-2146"><a href="https://www.lowcostwebagency.com/it/low-cost/senza-categoria/">Senza categoria</a></li>
<li class="cat-item cat-item-1877"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/audit-e-analisi/seo-audit-it/">SEO Audit</a></li>
<li class="cat-item cat-item-1848"><a href="https://www.lowcostwebagency.com/it/low-cost/sicurezza/">Sicurezza</a></li>
<li class="cat-item cat-item-1852"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/sito-web-pagina/">Sito web & Pagina</a></li>
<li class="cat-item cat-item-1861"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/sito-web-pagina/sito-web-e-commerce/">Sito web e-commerce</a></li>
<li class="cat-item cat-item-1864"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/social-media-marketing-it/">Social Media Marketing</a></li>
<li class="cat-item cat-item-1845"><a href="https://www.lowcostwebagency.com/it/low-cost/stampa/">Stampa</a></li>
<li class="cat-item cat-item-1879"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/audit-e-analisi/strategia-di-web-marketing/">Strategia di Web Marketing</a></li>
<li class="cat-item cat-item-1874"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/marketing-dei-contenuti/traduzione/">Traduzione</a></li>
<li class="cat-item cat-item-1885"><a href="https://www.lowcostwebagency.com/it/low-cost/stampa/volantini-volantini/">Volantini / Volantini</a></li>
<li class="cat-item cat-item-1842"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/">Web Design</a></li>
<li class="cat-item cat-item-1843"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/">Web Marketing</a></li>
<li class="cat-item cat-item-1860"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/sito-web-pagina/wordpress-joomla-drupal-sito-cms/">Wordpress | Joomla | Drupal - Sito CMS</a></li>
</ul></section><section id="text-7" class="widget widget_text"> <div class="textwidget"><div class="fusion-image-element" style="text-align:center;--awb-liftup-border-radius:0px;--awb-caption-title-font-family:var(--h2_typography-font-family);--awb-caption-title-font-weight:var(--h2_typography-font-weight);--awb-caption-title-font-style:var(--h2_typography-font-style);--awb-caption-title-size:var(--h2_typography-font-size);--awb-caption-title-transform:var(--h2_typography-text-transform);--awb-caption-title-line-height:var(--h2_typography-line-height);--awb-caption-title-letter-spacing:var(--h2_typography-letter-spacing);"><div class="awb-image-frame awb-image-frame-1 imageframe-liftup"><span class="fusion-imageframe imageframe-none imageframe-1"><a class="fusion-no-lightbox" href="http://avada.theme-fusion.com/classic-shop/women/" target="_self"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" decoding="async" data-src="http://avada.theme-fusion.com/classic-shop/wp-content/uploads/sites/48/2015/12/promotion_women_img.jpg" alt class="img-responsive"/></a></span></div></div></div>
</section> </aside>
</div> <!-- fusion-row -->
</main> <!-- #main -->
<div class="fusion-footer">
<footer class="fusion-footer-widget-area fusion-widget-area">
<div class="fusion-row">
<div class="fusion-columns fusion-columns-5 fusion-widget-area">
<div class="fusion-column col-lg-2 col-md-2 col-sm-2">
<section id="pyre_tabs-widget-2" class="fusion-footer-widget-column widget fusion-tabs-widget" style="border-style: solid;border-color:transparent;border-width:0px;"> <div class="fusion-tabs-widget-wrapper fusion-tabs-widget-2 fusion-tabs-clean fusion-tabs-image-circle tab-holder">
<nav class="fusion-tabs-nav">
<ul class="tabset tabs">
<li class="active"><a href="#" data-link="fusion-tab-popular">Popular</a></li>
<li><a href="#" data-link="fusion-tab-recent">Recent</a></li>
</ul>
</nav>
<div class="fusion-tabs-widget-content tab-box tabs-container">
<div class="fusion-tab-popular fusion-tab-content tab tab_content" data-name="fusion-tab-popular">
<ul class="fusion-tabs-widget-items news-list">
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/wpml-e-il-miglior-plugin-wordpress-per-i-siti-web-multilingue/" aria-label="WPML è il miglior plugin WordPress per i siti web multilingue?"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2022/06/WPML-Image-Redesign1200-600-66x66.png.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="WPML Image Redesign lcwa(1200-600)" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2022/06/WPML-Image-Redesign1200-600-66x66.png.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2022/06/WPML-Image-Redesign1200-600-100x100.png.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2022/06/WPML-Image-Redesign1200-600-150x150.png.webp 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="WPML è il miglior plugin WordPress per i siti web multilingue?"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/wpml-e-il-miglior-plugin-wordpress-per-i-siti-web-multilingue/">WPML è il miglior plugin WordPress per i siti web multilingue?</a>
<div class="fusion-meta">
Febbraio 3rd, 2025 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/consigli-seo-per-google/" aria-label="Consigli Seo per Google"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2017/12/Google-SEO-700x441-1-66x66.jpg.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="Google-SEO-700×441" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2017/12/Google-SEO-700x441-1-66x66.jpg.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2017/12/Google-SEO-700x441-1-100x100.jpg.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2017/12/Google-SEO-700x441-1-150x150.jpg.webp 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="Consigli Seo per Google"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/consigli-seo-per-google/">Consigli Seo per Google</a>
<div class="fusion-meta">
Aprile 22nd, 2025 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/perche-avete-bisogno-di-un-sito-web-per-la-vostra-attivita/" aria-label="Perché avete bisogno di un sito web per la vostra attività?"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2025/06/why-your-business-needs-a-website-2026-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="A futuristic holographic display showing AI and business growth, illustrating why your business needs a website in 2026." decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2025/06/why-your-business-needs-a-website-2026-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2025/06/why-your-business-needs-a-website-2026-scaled-100x100.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2025/06/why-your-business-needs-a-website-2026-150x150.webp 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="Perché avete bisogno di un sito web per la vostra attività?"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/perche-avete-bisogno-di-un-sito-web-per-la-vostra-attivita/">Perché avete bisogno di un sito web per la vostra attività?</a>
<div class="fusion-meta">
Novembre 24th, 2024 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/23-potenti-strumenti-seo-per-le-piccole-e-medie-imprese-nel-2026/" aria-label="23 potenti strumenti SEO per le piccole e medie imprese"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2022/11/Best-SEO-plugins-for-WP-66x66.png" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="I migliori plugin SEO per WP" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2022/11/Best-SEO-plugins-for-WP-66x66.png 66w, https://www.lowcostwebagency.com/wp-content/uploads/2022/11/Best-SEO-plugins-for-WP-100x100.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2022/11/Best-SEO-plugins-for-WP-150x150.png 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="23 potenti strumenti SEO per le piccole e medie imprese"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/23-potenti-strumenti-seo-per-le-piccole-e-medie-imprese-nel-2026/">23 potenti strumenti SEO per le piccole e medie imprese</a>
<div class="fusion-meta">
Novembre 7th, 2024 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/dare-nuova-vita-alla-vostra-attivita-con-il-rebranding/" aria-label="Dare nuova vita alla vostra attività con il rebranding"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2022/05/tutorial-redesign-page-lcwa1200-600-66x66.png.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="tutorial redesign page lcwa(1200-600)" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2022/05/tutorial-redesign-page-lcwa1200-600-66x66.png.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2022/05/tutorial-redesign-page-lcwa1200-600-100x100.png.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2022/05/tutorial-redesign-page-lcwa1200-600-150x150.png.webp 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="Dare nuova vita alla vostra attività con il rebranding"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/dare-nuova-vita-alla-vostra-attivita-con-il-rebranding/">Dare nuova vita alla vostra attività con il rebranding</a>
<div class="fusion-meta">
Aprile 26th, 2025 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/carenza-di-profili-it-guerra-tra-ucraina-e-russia-la-web-agency-low-cost-ti-aiuta/" aria-label="Carenza di profili IT | Guerra tra Ucraina e Russia | La Web Agency Low Cost ti aiuta!"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2022/04/shortage-contact-us-low-cost-web-agency-66x66.png.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="shortage contact us-low cost web agency" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2022/04/shortage-contact-us-low-cost-web-agency-66x66.png.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2022/04/shortage-contact-us-low-cost-web-agency-100x100.png.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2022/04/shortage-contact-us-low-cost-web-agency-150x150.png.webp 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="Carenza di profili IT | Guerra tra Ucraina e Russia | La Web Agency Low Cost ti aiuta!"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/carenza-di-profili-it-guerra-tra-ucraina-e-russia-la-web-agency-low-cost-ti-aiuta/">Carenza di profili IT | Guerra tra Ucraina e Russia | La Web Agency Low Cost ti aiuta!</a>
<div class="fusion-meta">
Ottobre 9th, 2024 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/rank-math-o-yoast/" aria-label="Rank Math o Yoast SEO? Quale plugin WordPress per il SEO del vostro sito web?"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2022/05/Image-Rank-Math-ou-Yoast-SEO-Quel-plugin-Worpress-choisir-pour-le-SEO-de-votre-site-Web-2-66x66.png.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="Image Rank Math ou Yoast SEO Quel plugin Worpress choisir pour le SEO de votre site Web (2)" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2022/05/Image-Rank-Math-ou-Yoast-SEO-Quel-plugin-Worpress-choisir-pour-le-SEO-de-votre-site-Web-2-66x66.png.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2022/05/Image-Rank-Math-ou-Yoast-SEO-Quel-plugin-Worpress-choisir-pour-le-SEO-de-votre-site-Web-2-100x100.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2022/05/Image-Rank-Math-ou-Yoast-SEO-Quel-plugin-Worpress-choisir-pour-le-SEO-de-votre-site-Web-2-150x150.png.webp 150w, https://www.lowcostwebagency.com/wp-content/uploads/2022/05/Image-Rank-Math-ou-Yoast-SEO-Quel-plugin-Worpress-choisir-pour-le-SEO-de-votre-site-Web-2-200x200.png.webp 200w" data-sizes="(max-width: 66px) 100vw, 66px" title="Rank Math o Yoast SEO? Quale plugin Wordpress per il SEO del vostro sito web?"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/rank-math-o-yoast/">Rank Math o Yoast SEO? Quale plugin WordPress per il SEO del vostro sito web?</a>
<div class="fusion-meta">
Ottobre 3rd, 2024 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/che-cose-un-buon-logo/" aria-label="Che cos’è un buon logo?"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2018/10/Good-Logo-3-700x441-1-66x66.jpg.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="Good-Logo-3-700×441" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2018/10/Good-Logo-3-700x441-1-66x66.jpg.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2018/10/Good-Logo-3-700x441-1-100x100.jpg.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2018/10/Good-Logo-3-700x441-1-150x150.jpg.webp 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="Che cos'è un buon logo?"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/che-cose-un-buon-logo/">Che cos’è un buon logo?</a>
<div class="fusion-meta">
Novembre 5th, 2024 </div>
</div>
</li>
</ul>
</div>
<div class="fusion-tab-recent fusion-tab-content tab tab_content" data-name="fusion-tab-recent" style="display: none;">
<ul class="fusion-tabs-widget-items news-list">
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/ai-copywriting-aumenta-la-visibilita/" aria-label="La magia dei contenuti basati sull’IA: aumenta all’istante la visibilità del tuo sito web con le guide automatizzate per la creazione di testi"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="Lo strumento di copywriting basato sull'intelligenza artificiale aumenta rapidamente la visibilità del sito" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-150x150.webp 150w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-200x200.webp 200w" data-sizes="(max-width: 66px) 100vw, 66px" title="La magia dei contenuti basati sull’IA: aumenta all’istante la visibilità del tuo sito web con le guide automatizzate per la creazione di testi"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/ai-copywriting-aumenta-la-visibilita/">La magia dei contenuti basati sull’IA: aumenta all’istante la visibilità del tuo sito web con le guide automatizzate per la creazione di testi</a>
<div class="fusion-meta">
Ottobre 11th, 2026 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/meta-description-con-ia-visibilita/" aria-label="Descrizioni meta ai-generated: il segreto per un’incremento immediato di visibilità"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="AI-generated metadata for enhanced online visibility" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-100x100.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-150x150.webp 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="Descrizioni meta ai-generated: il segreto per un'incremento immediato di visibilità"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/meta-description-con-ia-visibilita/">Descrizioni meta ai-generated: il segreto per un’incremento immediato di visibilità</a>
<div class="fusion-meta">
Ottobre 10th, 2026 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/contenuti-ai-il-futuro-di/" aria-label="Contenuti ai-creati: il futuro dell’seo e della maestria nel design web"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="AI-generated content for SEO and web design success" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-150x150.webp 150w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-200x200.webp 200w" data-sizes="(max-width: 66px) 100vw, 66px" title="Contenuti ai-creati: il futuro dell'seo e della maestria nel design web"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/contenuti-ai-il-futuro-di/">Contenuti ai-creati: il futuro dell’seo e della maestria nel design web</a>
<div class="fusion-meta">
Ottobre 9th, 2026 </div>
</div>
</li>
<li>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/descrizioni-meta-ai-per-unincremento/">Descrizioni meta ai per un’incremento di visibilità immediato</a>
<div class="fusion-meta">
Ottobre 9th, 2026 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/web-design-con-ai-layout/" aria-label="Rinnovamento del design web: layout ai che convertono visite in vendite"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="AI-driven web layouts increasing conversions and sales" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-150x150.webp 150w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-200x200.webp 200w" data-sizes="(max-width: 66px) 100vw, 66px" title="Rinnovamento del design web: layout ai che convertono visite in vendite"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/web-design-con-ai-layout/">Rinnovamento del design web: layout ai che convertono visite in vendite</a>
<div class="fusion-meta">
Ottobre 9th, 2026 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/content-ai-rivoluziona-i-contenuti/" aria-label="Rivoluzionando il tuo sito web con tecniche di ottimizzazione del contenuto basate sull’intelligenza artificiale"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-your-website-with-aipowered-content-optimization-techniques-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="AI-driven content优化提升网站效率示意图" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-your-website-with-aipowered-content-optimization-techniques-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-your-website-with-aipowered-content-optimization-techniques-100x100.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-your-website-with-aipowered-content-optimization-techniques-150x150.webp 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="Rivoluzionando il tuo sito web con tecniche di ottimizzazione del contenuto basate sull'intelligenza artificiale"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/content-ai-rivoluziona-i-contenuti/">Rivoluzionando il tuo sito web con tecniche di ottimizzazione del contenuto basate sull’intelligenza artificiale</a>
<div class="fusion-meta">
Ottobre 9th, 2026 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/seo-e-ia-automatizza-le/" aria-label="L’ottimizzazione delle parole chiave con l’intelligenza artificiale: automatizzare per massimizzare la visibilità"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="AI-driven SEO tool optimizing keywords for better visibility" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-150x150.webp 150w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-200x200.webp 200w" data-sizes="(max-width: 66px) 100vw, 66px" title="L'ottimizzazione delle parole chiave con l'intelligenza artificiale: automatizzare per massimizzare la visibilità"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/seo-e-ia-automatizza-le/">L’ottimizzazione delle parole chiave con l’intelligenza artificiale: automatizzare per massimizzare la visibilità</a>
<div class="fusion-meta">
Ottobre 8th, 2026 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/it/come-lia-rivoluziona-la-creazione/" aria-label="Come l’intelligenza artificiale sta trasformando la creazione di contenuti in varie industrie"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/how-ai-is-transforming-content-creation-across-industries-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="AI-driven content creation across industries illustrated" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/how-ai-is-transforming-content-creation-across-industries-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/how-ai-is-transforming-content-creation-across-industries-150x150.webp 150w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/how-ai-is-transforming-content-creation-across-industries-200x200.webp 200w" data-sizes="(max-width: 66px) 100vw, 66px" title="Come l'intelligenza artificiale sta trasformando la creazione di contenuti in varie industrie"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/it/come-lia-rivoluziona-la-creazione/">Come l’intelligenza artificiale sta trasformando la creazione di contenuti in varie industrie</a>
<div class="fusion-meta">
Ottobre 8th, 2026 </div>
</div>
</li>
</ul>
</div>
</div>
</div>
<div style="clear:both;"></div></section> </div>
<div class="fusion-column col-lg-2 col-md-2 col-sm-2">
<section id="nav_menu-13" class="fusion-footer-widget-column widget widget_nav_menu" style="border-style: solid;border-color:transparent;border-width:0px;"><h4 class="widget-title">ACQUISTA ONLINE</h4><div class="menu-seo-menu-italian-container"><ul id="menu-seo-menu-italian" class="menu"><li id="menu-item-46454" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-46454"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/sito-web-pagina/" title="Creazione di siti web e sviluppo di pagine personalizzate">Sito web & Pagina</a></li>
<li id="menu-item-46455" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-46455"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/design-it/" title="Servizi di web design professionale per la tua presenza online">Design</a></li>
<li id="menu-item-46456" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-46456"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/" title="Soluzioni complete di web marketing per aumentare la tua visibilità">Web Marketing</a></li>
<li id="menu-item-46457" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-46457"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/marketing-dei-contenuti/" title="Strategie di content marketing per coinvolgere il tuo pubblico">Marketing dei contenuti</a></li>
<li id="menu-item-46458" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-46458"><a href="https://www.lowcostwebagency.com/it/low-cost/sicurezza/" title="Proteggi il tuo sito web con le nostre soluzioni di sicurezza avanzate">Sicurezza</a></li>
<li id="menu-item-46459" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-46459"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/audit-e-analisi/strategia-di-web-marketing/" title="Sviluppo di strategie di web marketing su misura per il tuo business">Strategia di Web Marketing</a></li>
<li id="menu-item-46463" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-46463"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/marketing-via-e-mail/" title="Creazione e gestione di campagne di email marketing efficaci">Marketing via e-mail</a></li>
<li id="menu-item-46460" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-46460"><a href="https://www.lowcostwebagency.com/it/low-cost/web-marketing-it/social-media-marketing-it/" title="Fai crescere la tua community con i nostri servizi di social media marketing">Social Media Marketing</a></li>
<li id="menu-item-46461" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-46461"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/sito-web-pagina/codifica-e-debug/" title="Servizi esperti di programmazione e risoluzione di bug (debugging)">Codifica e debug</a></li>
<li id="menu-item-46462" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-46462"><a href="https://www.lowcostwebagency.com/it/low-cost/web-design/sito-web-pagina/sito-web-e-commerce/" title="Creazione e ottimizzazione di siti e-commerce ad alte prestazioni">Sito web e-commerce</a></li>
</ul></div><div style="clear:both;"></div></section> </div>
<div class="fusion-column col-lg-2 col-md-2 col-sm-2">
<section id="nav_menu-12" class="fusion-footer-widget-column widget widget_nav_menu" style="border-style: solid;border-color:transparent;border-width:0px;"><h4 class="widget-title">LA NOSTRA DIFFERENZA</h4><div class="menu-check-our-difference-italian-container"><ul id="menu-check-our-difference-italian" class="menu"><li id="menu-item-48521" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48521"><a href="https://www.lowcostwebagency.com/it/faqs/chi-ce-dietro-la-low-cost-web-agency/">Chi c’è dietro Low Cost Web Agency?</a></li>
<li id="menu-item-48522" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48522"><a href="https://www.lowcostwebagency.com/it/faqs/garanzia-del-miglior-prezzo-davvero-come-funziona/">Garanzia del miglior prezzo… Davvero? Come funziona?</a></li>
<li id="menu-item-48523" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48523"><a href="https://www.lowcostwebagency.com/it/faqs/posso-sapere-cosa-e-incluso-nella-vostra-garanzia-a-vita/">Posso sapere cosa è incluso nella vostra Garanzia a Vita?</a></li>
<li id="menu-item-48524" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48524"><a href="https://www.lowcostwebagency.com/it/faqs/i-vostri-prezzi-sono-comprensivi-di-tasse-ci-sono-spese-nascoste/">I vostri prezzi sono comprensivi di tasse? Ci sono spese nascoste?</a></li>
<li id="menu-item-48525" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48525"><a href="https://www.lowcostwebagency.com/it/faqs/il-prodotto-finito-sara-di-mia-proprieta/">Il prodotto finito sarà di mia proprietà?</a></li>
<li id="menu-item-48526" class="menu-item menu-item-type-post_type menu-item-object-page menu-item-48526"><a href="https://www.lowcostwebagency.com/it/portafoglio/">Portafoglio</a></li>
<li id="menu-item-48527" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48527"><a href="https://www.lowcostwebagency.com/it/faqs/posso-vedere-esempi-di-modelli-di-siti-web/">Posso vedere esempi di modelli di siti web?</a></li>
<li id="menu-item-48528" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48528"><a href="https://www.lowcostwebagency.com/it/faqs/wordpress-vs-joomla-vs-drupal-quale-cms-e-migliore/">WordPress Vs. Joomla Vs. Drupal? Quale CMS è migliore?</a></li>
<li id="menu-item-48529" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48529"><a href="https://www.lowcostwebagency.com/it/faqs/garanzia-del-miglior-prezzo-davvero-come-funziona/">Garanzia del miglior prezzo… Davvero? Come funziona?</a></li>
<li id="menu-item-48530" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48530"><a href="https://www.lowcostwebagency.com/it/faqs/posso-sapere-cosa-e-incluso-nella-vostra-garanzia-a-vita/">Posso sapere cosa è incluso nella vostra Garanzia a Vita?</a></li>
</ul></div><div style="clear:both;"></div></section> </div>
<div class="fusion-column col-lg-2 col-md-2 col-sm-2">
<section id="nav_menu-11" class="fusion-footer-widget-column widget widget_nav_menu" style="border-style: solid;border-color:transparent;border-width:0px;"><h4 class="widget-title">INFORMAZIONI/FAQ</h4><div class="menu-info-menu-italian-container"><ul id="menu-info-menu-italian" class="menu"><li id="menu-item-48537" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48537"><a href="https://www.lowcostwebagency.com/it/faqs/dove-posso-trovare-i-vostri-termini-e-condizioni/">Dove posso trovare i vostri Termini e condizioni?</a></li>
<li id="menu-item-48538" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48538"><a href="https://www.lowcostwebagency.com/it/faqs/come-e-quando-pago-i-vostri-servizi-effettuate-rimborsi/">Come e quando pago i vostri servizi? Effettuate rimborsi?</a></li>
<li id="menu-item-46510" class="menu-item menu-item-type-post_type menu-item-object-page menu-item-46510"><a href="https://www.lowcostwebagency.com/it/condizioni-di-utilizzo/">Condizioni di utilizzo</a></li>
<li id="menu-item-48539" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48539"><a href="https://www.lowcostwebagency.com/it/faqs/avete-una-politica-di-utilizzo-corretto-per-i-vostri-servizi-di-hosting/">Avete una politica di utilizzo corretto per i vostri servizi di hosting?</a></li>
<li id="menu-item-48540" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48540"><a href="https://www.lowcostwebagency.com/it/faqs/utilizzate-modelli-premium/">Utilizzate modelli premium?</a></li>
<li id="menu-item-48541" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48541"><a href="https://www.lowcostwebagency.com/it/faqs/quanti-contenuti-aggiungerete-al-mio-sito-web-articoli-post-prodotti-immagini/">Quanti contenuti aggiungerete al mio sito web? Articoli, post, prodotti, immagini?</a></li>
<li id="menu-item-48542" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48542"><a href="https://www.lowcostwebagency.com/it/faqs/che-cose-un-ip-dedicato-ne-ho-bisogno/">Che cos’è un IP dedicato? Ne ho bisogno?</a></li>
<li id="menu-item-48543" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48543"><a href="https://www.lowcostwebagency.com/it/faqs/che-tipo-di-assistenza-manutenzione-e-garanzia-offrite-con-i-vostri-servizi-di-hosting/">Che tipo di assistenza, manutenzione e garanzia offrite con i vostri servizi di hosting?</a></li>
<li id="menu-item-46511" class="menu-item menu-item-type-post_type menu-item-object-page menu-item-46511"><a href="https://www.lowcostwebagency.com/it/contattateci/">Contattateci</a></li>
</ul></div><div style="clear:both;"></div></section> </div>
<div class="fusion-column fusion-column-last col-lg-2 col-md-2 col-sm-2">
<section id="custom_html-5" class="widget_text fusion-footer-widget-column widget widget_custom_html" style="border-style: solid;border-color:transparent;border-width:0px;"><h4 class="widget-title">PREVENTIVO GRATUITO IN 24 ORE</h4><div class="textwidget custom-html-widget"><div class="footer-form-intro" style="margin-bottom:20px;font-size:14px;line-height:1.6;color:#dddddd;">
<p>Vuoi far decollare la tua presenza digitale? Parlaci del tuo progetto qui sotto. Il nostro team combina soluzioni web d'eccellenza e tariffe competitive per dare slancio al tuo business. Risposta garantita entro 24 ore.</p>
<p style="margin-top:10px;font-size:13px;">
<span style="color:#aaaaaa;">Hai un'urgenza?</span>
<a href="https://wa.me/919786495150?text=Buongiorno%20Alex,%20vorrei%20parlare%20di%20un%20progetto..." target="_blank" rel="noopener noreferrer" style="color:#25D366;font-weight:bold;text-decoration:none;margin-left:5px;">
Contattaci su WhatsApp
</a>
</p>
</div>
<div class="wpcf7 no-js" id="wpcf7-f49835-o1" lang="it-IT" dir="ltr" data-wpcf7-id="49835">
<div class="screen-reader-response"><p role="status" aria-live="polite" aria-atomic="true"></p> <ul></ul></div>
<form action="/it/content-ai-rivoluziona-i-contenuti/#wpcf7-f49835-o1" method="post" class="wpcf7-form init" aria-label="Modulo di contatto" novalidate="novalidate" data-status="init">
<fieldset class="hidden-fields-container"><input type="hidden" name="_wpcf7" value="49835" /><input type="hidden" name="_wpcf7_version" value="6.1.7" /><input type="hidden" name="_wpcf7_locale" value="it_IT" /><input type="hidden" name="_wpcf7_unit_tag" value="wpcf7-f49835-o1" /><input type="hidden" name="_wpcf7_container_post" value="0" /><input type="hidden" name="_wpcf7_posted_data_hash" value="" /><input type="hidden" name="_wpcf7cf_hidden_group_fields" value="[]" /><input type="hidden" name="_wpcf7cf_hidden_groups" value="[]" /><input type="hidden" name="_wpcf7cf_visible_groups" value="[]" /><input type="hidden" name="_wpcf7cf_repeaters" value="[]" /><input type="hidden" name="_wpcf7cf_steps" value="{}" /><input type="hidden" name="_wpcf7cf_options" value="{"form_id":49835,"conditions":[],"settings":{"animation":"yes","animation_intime":200,"animation_outtime":200,"conditions_ui":"normal","notice_dismissed":false,"repeater_remove_button":"bottom","notice_dismissed_rollback-cf7-5.8.1":true,"notice_dismissed_update-cf7-6.2":true}}" />
</fieldset>
<div class="wpcf7-turnstile cf-turnstile" data-sitekey="0x4AAAAAADHHp2OLRckyMy7w" data-response-field-name="_wpcf7_turnstile_response"></div>
<style>
.footer-contact-form input,
.footer-contact-form textarea {
background-color: #ffffff !important;
color: #333333 !important;
border: 1px solid #cccccc !important;
width: 100% !important;
border-radius: 4px !important;
}
.footer-contact-form input { height: 45px !important; margin-bottom: 10px !important; padding: 0 15px !important; }
.footer-contact-form textarea { height: 100px !important; margin-bottom: 15px !important; padding: 10px 15px !important; }
.footer-contact-form .wpcf7-submit {
background-color: #FFD810 !important;
color: #000000 !important;
font-weight: bold !important;
width: 100% !important;
height: 50px !important;
border: none !important;
border-radius: 4px !important;
cursor: pointer !important;
}
</style>
<div class="footer-contact-form">
<p><span class="wpcf7-form-control-wrap" data-name="your-name"><input size="40" maxlength="400" class="wpcf7-form-control wpcf7-text wpcf7-validates-as-required" aria-required="true" aria-invalid="false" placeholder="*Nome completo" value="" type="text" name="your-name" /></span><br />
<span class="wpcf7-form-control-wrap" data-name="your-email"><input size="40" maxlength="400" class="wpcf7-form-control wpcf7-email wpcf7-validates-as-required wpcf7-text wpcf7-validates-as-email" aria-required="true" aria-invalid="false" placeholder="*Indirizzo e-mail" value="" type="email" name="your-email" /></span><br />
<span class="wpcf7-form-control-wrap" data-name="tel-837"><input size="40" maxlength="400" class="wpcf7-form-control wpcf7-tel wpcf7-validates-as-required wpcf7-text wpcf7-validates-as-tel" aria-required="true" aria-invalid="false" placeholder="*Telefono (es: +33 6... / +91...)" value="" type="tel" name="tel-837" /></span><br />
<span class="wpcf7-form-control-wrap" data-name="your-message"><textarea cols="40" rows="2" maxlength="2000" class="wpcf7-form-control wpcf7-textarea" aria-invalid="false" placeholder="Dettagli del progetto..." name="your-message"></textarea></span><br />
<div class="cf7-cf-turnstile" style="margin-top: 0px; margin-bottom: -15px;"> <div id="cf-turnstile-cf7-1050561614" class="cf-turnstile" data-sitekey="0x4AAAAAADHHp2OLRckyMy7w" data-theme="auto" data-language="auto" data-size="flexible" data-retry="auto" data-retry-interval="1000" data-refresh-expired="auto" data-refresh-timeout="auto" data-action="contact-form-7" data-callback="turnstileCF7Callback" data-appearance="always"></div> <style>.wpcf7-submit { pointer-events: none; opacity: 0.5; }</style> <br class="cf-turnstile-br cf-turnstile-br-cf7-1050561614"> </div><br/><input class="wpcf7-form-control wpcf7-submit has-spinner" type="submit" value="Richiedi un preventivo" />
</p>
</div><p style="display: none !important;" class="akismet-fields-container" data-prefix="_wpcf7_ak_"><label>Δ<textarea name="_wpcf7_ak_hp_textarea" cols="45" rows="8" maxlength="100"></textarea></label><input type="hidden" id="ak_js_1" name="_wpcf7_ak_js" value="194"/><script src="data:text/javascript;base64,ZG9jdW1lbnQuZ2V0RWxlbWVudEJ5SWQoImFrX2pzXzEiKS5zZXRBdHRyaWJ1dGUoInZhbHVlIiwobmV3IERhdGUoKSkuZ2V0VGltZSgpKQ==" defer></script>
</p><div class="fusion-alert alert custom alert-custom fusion-alert-center wpcf7-response-output awb-alert-native-link-color alert-dismissable awb-alert-close-boxed" style="--awb-border-size:1px;--awb-border-top-left-radius:0px;--awb-border-top-right-radius:0px;--awb-border-bottom-left-radius:0px;--awb-border-bottom-right-radius:0px;" role="alert"><div class="fusion-alert-content-wrapper"><span class="fusion-alert-content"></span></div><button type="button" class="close toggle-alert" data-dismiss="alert" aria-label="Close">×</button></div>
</form>
</div>
</div><div style="clear:both;"></div></section> </div>
<div class="fusion-clearfix"></div>
</div> <!-- fusion-columns -->
</div> <!-- fusion-row -->
</footer> <!-- fusion-footer-widget-area -->
<footer id="footer" class="fusion-footer-copyright-area fusion-footer-copyright-center">
<div class="fusion-row">
<div class="fusion-copyright-content">
<div class="fusion-copyright-notice">
<div>
Accettiamo tutte le principali carte di credito : <img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" data-src="/wp-content/uploads/2017/09/paypal_accept.png.webp" width="271" height="27" />
<div style="margin-top: 1%;">
<a href='https://www.lowcostwebagency.com' target='_blank'>
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" data-src="/wp-content/uploads/2016/10/footerlcwalogo.png.webp" style="width: 17px;" width="22" height="25" /> Low Cost Web Agency Pvt. Ltd.
</a>
© Copyright 2026 | Tutti i diritti riservati |
<a href="/terms-use" target="_blank">Termini d'uso | </a>
<a href=' https://www.icann.org/fr/contracted-parties/accredited-registrars/registrar-accreditation-agreement/registrant-rights-and-responsibilities-under-the-2009-registrar-accreditation-agreement-27-06-2011-it ' target='_blank'> ICANN ➔</a>
<a href=' https://www.icann.org/resources/pages/benefits-2013-09-16-en ' target='_blank'> Termini</a>
</div> </div>
</div>
<div class="fusion-social-links-footer">
<div class="fusion-social-networks"><div class="fusion-social-networks-wrapper"><a class="fusion-social-network-icon fusion-tooltip fusion-facebook awb-icon-facebook" style data-placement="top" data-title="Facebook" data-toggle="tooltip" title="Facebook" href="https://www.facebook.com/lowcostwebagency" target="_blank" rel="noreferrer nofollow"><span class="screen-reader-text">Facebook</span></a><a class="fusion-social-network-icon fusion-tooltip fusion-linkedin awb-icon-linkedin" style data-placement="top" data-title="LinkedIn" data-toggle="tooltip" title="LinkedIn" href="http://www.linkedin.com/company/low-cost-web-agency-ltd-" target="_blank" rel="noopener noreferrer nofollow"><span class="screen-reader-text">LinkedIn</span></a><a class="fusion-social-network-icon fusion-tooltip fusion-twitter awb-icon-twitter" style data-placement="top" data-title="X" data-toggle="tooltip" title="X" href="https://twitter.com/LOWCOSTCONCEPT" target="_blank" rel="noopener noreferrer nofollow"><span class="screen-reader-text">X</span></a><a class="fusion-social-network-icon fusion-tooltip fusion-youtube awb-icon-youtube" style data-placement="top" data-title="YouTube" data-toggle="tooltip" title="YouTube" href="https://www.youtube.com/user/easyrome73" target="_blank" rel="noopener noreferrer nofollow"><span class="screen-reader-text">YouTube</span></a></div></div></div>
</div> <!-- fusion-fusion-copyright-content -->
</div> <!-- fusion-row -->
</footer> <!-- #footer -->
</div> <!-- fusion-footer -->
</div> <!-- wrapper -->
</div> <!-- #boxed-wrapper -->
<a class="fusion-one-page-text-link fusion-page-load-link" tabindex="-1" href="#" aria-hidden="true">Page load link</a>
<div class="avada-footer-scripts">
<script type="speculationrules">
{"prefetch":[{"source":"document","where":{"and":[{"href_matches":"/it/*"},{"not":{"href_matches":["/wp-*.php","/wp-admin/*","/wp-content/uploads/*","/wp-content/*","/wp-content/plugins/*","/wp-content/themes/Avada-Child-Theme/*","/wp-content/themes/Avada/*","/it/*\\?(.+)"]}},{"not":{"selector_matches":"a[rel~=\"nofollow\"]"}},{"not":{"selector_matches":".no-prefetch, .no-prefetch a"}}]},"eagerness":"conservative"}]}
</script>
<script type="text/javascript" src="data:text/javascript;base64,alF1ZXJ5KGRvY3VtZW50KS5yZWFkeShmdW5jdGlvbigpe2Z1bmN0aW9uIHdjX3F2X2dldFdpZHRoKCl7eFdpZHRoPW51bGw7aWYod2luZG93LnNjcmVlbiE9bnVsbCkKeFdpZHRoPXdpbmRvdy5zY3JlZW4uYXZhaWxXaWR0aDtpZih3aW5kb3cuaW5uZXJXaWR0aCE9bnVsbCkKeFdpZHRoPXdpbmRvdy5pbm5lcldpZHRoO2lmKGRvY3VtZW50LmJvZHkhPW51bGwpCnhXaWR0aD1kb2N1bWVudC5ib2R5LmNsaWVudFdpZHRoO3JldHVybiB4V2lkdGh9CmZ1bmN0aW9uIHdjX3F2X2dldF9jdXN0b21fdGVtcGxhdGUocHJvZHVjdF9pZCxleHRyYV9wYXJhbWV0ZXJzPScnKXt2YXIgaXNfc2hvcD0nbm8nO3ZhciBpc19jYXRlZ29yeT0nbm8nO3ZhciBvcmRlcmJ5PWpRdWVyeSgnLndvb2NvbW1lcmNlLW9yZGVyaW5nJykuZmluZCgnc2VsZWN0W25hbWU9b3JkZXJieV0nKS52YWwoKTt2YXIgdXJsPScvd3AtYWRtaW4vYWRtaW4tYWpheC5waHAnKyc/YWN0aW9uPXF1aWNrX3ZpZXdfY3VzdG9tX3RlbXBsYXRlX2xvYWQmcHJvZHVjdF9pZD0nK3Byb2R1Y3RfaWQrJyZpc19zaG9wPScraXNfc2hvcCsnJmlzX2NhdGVnb3J5PScraXNfY2F0ZWdvcnkrJyZvcmRlcmJ5PScrb3JkZXJieSsnJnNlY3VyaXR5PWYwNTg2ZThhZjUnO2lmKCcnIT09ZXh0cmFfcGFyYW1ldGVycyl7dXJsKz1leHRyYV9wYXJhbWV0ZXJzfQpyZXR1cm4gdXJsfQpqUXVlcnkoZG9jdW1lbnQpLm9uKCdxdWlja192aWV3X2Nsb3NlX3BvcHVwJyxmdW5jdGlvbigpe2lmKGpRdWVyeSgnZGl2LnBwX292ZXJsYXknKS5sZW5ndGg+MCl7alF1ZXJ5LnByZXR0eVBob3RvLmNsb3NlKCl9fSk7alF1ZXJ5KCIuaW5pdF9wcmV0dHlwaG90byIpLnByZXR0eVBob3RvKHthbmltYXRpb25fc3BlZWQ6MCxzb2NpYWxfdG9vbHM6ITEsdGhlbWU6J3BwX3dvb2NvbW1lcmNlJyxob3Jpem9udGFsX3BhZGRpbmc6MjAsb3BhY2l0eTowLjgsYWpheGNhbGxiYWNrOmZ1bmN0aW9uKCl7alF1ZXJ5KGRvY3VtZW50KS5maW5kKCcucHBfY29udGVudCcpLmFwcGVuZCgnPGRpdiBjbGFzcz0icXVpY2tfdmlld19wb3B1cF9sb2FkaW5nIj48L2Rpdj4nKTtqUXVlcnkoJy5xdWlja192aWV3X3BvcHVwX2xvYWRpbmcnKS5zaG93KCk7alF1ZXJ5KCcucHBfbG9hZGVySWNvbicpLnNob3coKX0sY2hhbmdlcGljdHVyZWNhbGxiYWNrOmZ1bmN0aW9uKCl7dmFyIHBvcHVwX2NvbnRhaW5lcj1qUXVlcnkoJy5xdWlja192aWV3X3BvcHVwX2NvbnRhaW5lcicpO3ZhciBwcm9kdWN0X2lkPXBvcHVwX2NvbnRhaW5lci5kYXRhKCdwcm9kdWN0X2lkJyk7dmFyIG9yZGVyYnk9cG9wdXBfY29udGFpbmVyLmRhdGEoJ29yZGVyYnknKTt2YXIgaXNfc2hvcD1wb3B1cF9jb250YWluZXIuZGF0YSgnaXNfc2hvcCcpO3ZhciBpc19jYXRlZ29yeT1wb3B1cF9jb250YWluZXIuZGF0YSgnaXNfY2F0ZWdvcnknKTt2YXIgcXZfZGF0YT17YWN0aW9uOiJxdWlja192aWV3X3ByZXR0eXBob3RvX2N1c3RvbV90ZW1wbGF0ZV9sb2FkIixwcm9kdWN0X2lkOnByb2R1Y3RfaWQsb3JkZXJieTpvcmRlcmJ5LGlzX3Nob3A6aXNfc2hvcCxpc19jYXRlZ29yeTppc19jYXRlZ29yeSxzZWN1cml0eTonNjNlZTM1NjI0OCd9O2pRdWVyeS5wb3N0KCcvd3AtYWRtaW4vYWRtaW4tYWpheC5waHAnLHF2X2RhdGEsZnVuY3Rpb24ocmVzcG9uc3ZlKXtwb3B1cF9jb250YWluZXIuaHRtbChyZXNwb25zdmUpO2pRdWVyeSgnLnF1aWNrX3ZpZXdfcG9wdXBfbG9hZGluZycpLmhpZGUoKTtqUXVlcnkoJy5wcF9sb2FkZXJJY29uJykuaGlkZSgpfSl9fSk7alF1ZXJ5KGRvY3VtZW50KS5vbigiY2xpY2siLCIucXVpY2tfdmlld191bHRpbWF0ZV9jbGljay5wcmV0dHlwaG90byIsZnVuY3Rpb24oKXt2YXIgcHJvZHVjdF9pZD1qUXVlcnkodGhpcykuYXR0cignaWQnKTt2YXIgcHJvZHVjdF91cmw9alF1ZXJ5KHRoaXMpLmF0dHIoJ2RhdGEtbGluaycpO3ZhciB1cmw9d2NfcXZfZ2V0X2N1c3RvbV90ZW1wbGF0ZShwcm9kdWN0X2lkLCcmYWpheD10cnVlJyk7dmFyIHBvcHVwX3RhbGw9MzAwO3ZhciBwb3B1cF93aWRlPTgwMDtpZih3Y19xdl9nZXRXaWR0aCgpPD02MDApe3BvcHVwX3dpZGU9JzkwJSc7cG9wdXBfdGFsbD0nOTAlJ30KalF1ZXJ5LnByZXR0eVBob3RvLm9wZW4odXJsKycmd2lkdGg9Jytwb3B1cF93aWRlKycmaGVpZ2h0PScrcG9wdXBfdGFsbCwnJywnJyk7cmV0dXJuITF9KX0p" defer></script>
<style type="text/css">
#cboxOverlay{ background-color: #666666 !important ; }
body .pp_overlay { background-color: #666666 !important ; }
</style>
<style type="text/css">
.quick_view_ultimate_content_under{text-align:center;clear:both;display:block;width:100%;padding:10px 0px;}
.quick_view_ultimate_content_under .quick_view_ultimate_under_link{
font:bold 12px/1.4em Arial, sans-serif !important;color:#000000 !important; text-align:center !important;
}
.quick_view_ultimate_content_under .quick_view_ultimate_under_link:hover{
color:#999999 !important;
}
.quick_view_ultimate_content_under .quick_view_ultimate_under_button{
font:bold 12px/1.4em Arial, sans-serif !important;color:#FFFFFF !important; border: 1px solid #000000 !important;border-radius: 3px 3px 3px 3px !important;-moz-border-radius: 3px 3px 3px 3px !important;-webkit-border-radius: 3px 3px 3px 3px !important; text-align:center !important;
padding: 7px 8px !important;
background: #000000 !important;
background: -webkit-gradient(linear, left top, left bottom, from(#000000), to(#000000)) !important;
background: -webkit-linear-gradient(#000000, #000000) !important;
background: -moz-linear-gradient(center top, #000000 0%, #000000 100%) !important;
background: -moz-gradient(center top, #000000 0%, #000000 100%) !important;
}
</style>
<style type="text/css">
.quick_view_ultimate_container{text-align:center;clear:both;display:block;width:100%;}
.quick_view_ultimate_container span{
font:normal 14px/1.4em Arial, sans-serif !important;color:#FFFFFF !important; text-align:center !important;
padding: 7px 17px !important;
}
.product_hover .quick_view_ultimate_container span.quick_view_ultimate_button{
color:#FFFFFF;
border: 1px solid #FFFFFF !important;border-radius: 3px 3px 3px 3px !important;-moz-border-radius: 3px 3px 3px 3px !important;-webkit-border-radius: 3px 3px 3px 3px !important; background: #999999;
background: -webkit-gradient(linear, left top, left bottom, from(#999999), to(#999999));
background: -webkit-linear-gradient(#999999, #999999);
background: -moz-linear-gradient(center top, #999999 0%, #999999 100%);
background: -moz-gradient(center top, #999999 0%, #999999 100%);
box-shadow: none !important ;-moz-box-shadow: none !important ;-webkit-box-shadow: none !important ; opacity:0.5;
filter:alpha(opacity=50);
}
</style>
<span class="awb-cart-count-data" data-cart-count="0" hidden></span><span class="awb-cart-count-live screen-reader-text" role="status" aria-live="polite" aria-atomic="true" data-singular="%s item in cart" data-plural="%s items in cart"></span><div class="woocommerce-cart-tab-container woocommerce-cart-tab-container--right"> <div class="woocommerce-cart-tab woocommerce-cart-tab--empty">
<svg xmlns="http://www.w3.org/2000/svg" viewbox="0 0 86 104.5" class="woocommerce-cart-tab__icon">
<path class="woocommerce-cart-tab__icon-bag" d="M67.2,26.7C64.6,11.5,54.8,0.2,43.1,0.2C31.4,0.2,21.6,11.5,19,26.7H0.1v77.6h86V26.7H67.2z M43.1,4.2 c9.6,0,17.7,9.6,20,22.6H23C25.4,13.8,33.5,4.2,43.1,4.2z M82.1,100.4h-78V30.7h14.4c-0.1,1.3-0.2,2.6-0.2,3.9c0,1.1,0,2.2,0.1,3.3 c-0.8,0.6-1.4,1.6-1.4,2.8c0,1.9,1.6,3.5,3.5,3.5s3.5-1.6,3.5-3.5c0-1.2-0.6-2.3-1.6-2.9c-0.1-1-0.1-2-0.1-3.1 c0-1.3,0.1-2.6,0.2-3.9h41.2c0.1,1.3,0.2,2.6,0.2,3.9c0,1,0,2.1-0.1,3.1c-1,0.6-1.6,1.7-1.6,2.9c0,1.9,1.6,3.5,3.5,3.5 c1.9,0,3.5-1.6,3.5-3.5c0-1.1-0.5-2.1-1.4-2.8c0.1-1.1,0.1-2.2,0.1-3.3c0-1.3-0.1-2.6-0.2-3.9h14.4V100.4z"/>
</svg>
<span class="woocommerce-cart-tab__contents">0</span>
<script type="text/javascript" src="data:text/javascript;base64,alF1ZXJ5KCcud29vY29tbWVyY2UtY2FydC10YWInKS5jbGljayhmdW5jdGlvbigpe2pRdWVyeSgnLndvb2NvbW1lcmNlLWNhcnQtdGFiLWNvbnRhaW5lcicpLnRvZ2dsZUNsYXNzKCd3b29jb21tZXJjZS1jYXJ0LXRhYi1jb250YWluZXItLXZpc2libGUnKTtqUXVlcnkoJ2JvZHknKS50b2dnbGVDbGFzcygnd29vY29tbWVyY2UtY2FydC10YWItaXMtdmlzaWJsZScpfSk=" defer></script>
</div>
<div class="widget woocommerce widget_shopping_cart"><h2 class="widgettitle">Your Cart</h2><div class="widget_shopping_cart_content"></div></div></div><!-- PayPal Checkout: Gateway not available for block theme injection --><div class='mwai-chatbot-container' data-params='{"aiName":"AI: ","userName":"User: ","guestName":"Guest:","textSend":"Send","textClear":"Clear","imageUpload":false,"fileUpload":false,"multiUpload":false,"maxUploads":1,"fileUploads":0,"mode":"chat","textInputPlaceholder":"Type your message...","textEmptyHint":"","textInputMaxLength":512,"textCompliance":"","startSentence":"Hi! How can I help you?","localMemory":true,"themeId":"chatgpt","window":true,"icon":"","iconText":"","iconTextDelay":1,"iconTextDuration":0,"iconTextOnce":"session","iconAlt":"AI Engine Chatbot","iconPosition":"bottom-right","centerOpen":false,"width":"","openDelay":"","iconBubble":false,"windowAnimation":"zoom","fullscreen":false,"copyButton":false,"pdfButton":false,"headerSubtitle":"Discuss with","containerType":"standard","headerType":"standard","messagesType":"standard","inputType":"standard","footerType":"standard"}' data-system='{"botId":"default","customId":null,"userData":null,"sessionId":null,"restNonce":null,"contextId":50316,"pluginUrl":"https:\/\/www.lowcostwebagency.com\/wp-content\/plugins\/ai-engine","restUrl":"https:\/\/www.lowcostwebagency.com\/it\/wp-json","stream":true,"debugMode":false,"eventLogs":false,"speech_recognition":false,"speech_synthesis":false,"typewriter":false,"crossSite":false,"texts":{"Ask me anything!":"Ask me anything!","Jump to the latest message":"Jump to the latest message","Try again":"Try again","Conversation cleared.":"Conversation cleared.","Undo":"Undo","Done!":"Done!","New Chat":"Nuova chat","No messages yet":"Ancora nessun messaggio","Rename":"Rinomina","Delete":"Elimina","Your text was cut at %d characters.":"Your text was cut at %d characters.","Hold to Talk":"Tieni premuto per parlare","Release to Send":"Release to Send","Press Space to talk":"Press Space to talk","Start session to upload images":"Start session to upload images","Usage limit exceeded":"Usage limit exceeded","Connection failed":"Connection failed","Connection failed. Please check your network and try again.":"Connection failed. Please check your network and try again.","Connection lost. Reconnecting...":"Connection lost. Reconnecting...","Connection lost while uploading image. Please try again.":"Connection lost while uploading image. Please try again.","Connection timeout: The server took too long to respond.":"Connection timeout: The server took too long to respond.","Could not start realtime session.":"Could not start realtime session.","An error occurred while starting the realtime session.":"An error occurred while starting the realtime session.","An error occurred while processing your request. Please try again.":"Si \u00e8 verificato un errore durante l'elaborazione della tua richiesta. Riprova.","An error occurred while committing the stats.":"An error occurred while committing the stats.","An error occurred while committing the discussion.":"An error occurred while committing the discussion.","An error occurred while executing the function.":"An error occurred while executing the function.","Authentication failed: Your session has expired. Please refresh the page.":"Authentication failed: Your session has expired. Please refresh the page.","Error uploading image. Please try again.":"Error uploading image. Please try again.","Failed to access microphone: ":"Failed to access microphone: ","Failed to access microphone. Please ensure microphone permissions are granted and try again.":"Accesso fallito al microfono. Assicurati che l'autorizzazione all'uso del microfono sia attiva e riprova.","Failed to establish connection with OpenAI servers. Please try again.":"Impossibile stabilire una connessione con i server OpenAI. Riprova.","Failed to read image file.":"Failed to read image file.","Failed to send image. Please try again.":"Failed to send image. Please try again.","Failed to upload image.":"Failed to upload image.","Image file size must be less than 20MB.":"Image file size must be less than 20MB.","Internal server error: An unexpected error occurred. Please try again.":"Errore interno del server: Si \u00e8 verificato un errore inatteso. Riprova.","Invalid API key: Please check your OpenAI API key in settings.":"Invalid API key: Please check your OpenAI API key in settings.","Invalid request: The message format was not recognized by the server.":"Richiesta non valida: Il formato del messaggio non \u00e8 stato riconosciuto dal server.","MediaDevices API not available. Please ensure you are using HTTPS and a modern browser.":"API MediaDevices non disponibile. Assicurati di utilizzare HTTPS ed un browser moderno.","Model overloaded: The AI model is currently experiencing high demand.":"Model overloaded: The AI model is currently experiencing high demand.","Network error: Failed to establish connection to the AI service.":"Network error: Failed to establish connection to the AI service.","Please select an image file.":"Please select an image file.","Please start a session before uploading images.":"Please start a session before uploading images.","Quota exceeded: You have reached your usage limit for this period.":"Quota superata: Hai raggiunto il tuo limite di utilizzo per questo periodo.","Rate limit exceeded: Too many requests. Please try again later.":"Rate limit exceeded: Too many requests. Please try again later.","Service unavailable: The AI service is temporarily down for maintenance.":"Servizio non disponibile: Il servizio AI \u00e8 temporaneamente fuori servizio per manutenzione."},"actions":[],"blocks":[],"shortcuts":[]}' data-theme='{"type":"internal","name":"ChatGPT","themeId":"chatgpt","settings":{"headerButtonsColor":"#434D58"},"style":"","cssUrl":"https:\/\/www.lowcostwebagency.com\/wp-content\/plugins\/ai-engine\/themes\/chatgpt.css"}'></div> <script type='text/javascript' src="data:text/javascript;base64,KGZ1bmN0aW9uKCl7dmFyIGM9ZG9jdW1lbnQuYm9keS5jbGFzc05hbWU7Yz1jLnJlcGxhY2UoL3dvb2NvbW1lcmNlLW5vLWpzLywnd29vY29tbWVyY2UtanMnKTtkb2N1bWVudC5ib2R5LmNsYXNzTmFtZT1jfSkoKQ==" defer></script>
<script type="text/javascript" id="flying-scripts" src="data:text/javascript;base64,Y29uc3QgbG9hZFNjcmlwdHNUaW1lcj1zZXRUaW1lb3V0KGxvYWRTY3JpcHRzLDUqMTAwMCk7Y29uc3QgdXNlckludGVyYWN0aW9uRXZlbnRzPVsnY2xpY2snLCdtb3VzZW1vdmUnLCdrZXlkb3duJywndG91Y2hzdGFydCcsJ3RvdWNobW92ZScsJ3doZWVsJ107dXNlckludGVyYWN0aW9uRXZlbnRzLmZvckVhY2goZnVuY3Rpb24oZXZlbnQpe3dpbmRvdy5hZGRFdmVudExpc3RlbmVyKGV2ZW50LHRyaWdnZXJTY3JpcHRMb2FkZXIse3Bhc3NpdmU6ITB9KX0pO2Z1bmN0aW9uIHRyaWdnZXJTY3JpcHRMb2FkZXIoKXtsb2FkU2NyaXB0cygpO2NsZWFyVGltZW91dChsb2FkU2NyaXB0c1RpbWVyKTt1c2VySW50ZXJhY3Rpb25FdmVudHMuZm9yRWFjaChmdW5jdGlvbihldmVudCl7d2luZG93LnJlbW92ZUV2ZW50TGlzdGVuZXIoZXZlbnQsdHJpZ2dlclNjcmlwdExvYWRlcix7cGFzc2l2ZTohMH0pfSl9CmZ1bmN0aW9uIGxvYWRTY3JpcHRzKCl7ZG9jdW1lbnQucXVlcnlTZWxlY3RvckFsbCgic2NyaXB0W2RhdGEtdHlwZT0nbGF6eSddIikuZm9yRWFjaChmdW5jdGlvbihlbGVtKXtlbGVtLnNldEF0dHJpYnV0ZSgic3JjIixlbGVtLmdldEF0dHJpYnV0ZSgiZGF0YS1zcmMiKSl9KX0=" defer></script>
<script id="wcml-mc-scripts-js-extra" src="data:text/javascript;base64,dmFyIHdjbWxfbWNfc2V0dGluZ3M9eyJ3Y21sX3NwaW5uZXIiOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS93cC1jb250ZW50L3BsdWdpbnMvc2l0ZXByZXNzLW11bHRpbGluZ3VhbC1jbXMvcmVzL2ltZy9hamF4LWxvYWRlci5naWYiLCJjdXJyZW50X2N1cnJlbmN5Ijp7ImNvZGUiOiJVU0QiLCJzeW1ib2wiOiImIzM2OyJ9LCJjYWNoZV9lbmFibGVkIjoiIn0=" defer></script>
<script data-optimized="1" data-wp-strategy="defer" defer id="wcml-mc-scripts-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/864c22c53c3a1db500aef6628fdb72a7.js?ver=711be"></script>
<script id="thickbox-js-extra" src="data:text/javascript;base64,dmFyIHRoaWNrYm94TDEwbj17Im5leHQiOiJTdWNjLiBcdTAwYmIiLCJwcmV2IjoiXHUwMGFiIFByZWMuIiwiaW1hZ2UiOiJJbW1hZ2luZSIsIm9mIjoiZGkiLCJjbG9zZSI6IkNoaXVkaSIsIm5vaWZyYW1lcyI6IlF1ZXN0YSBmdW56aW9uYWxpdFx1MDBlMCByaWNoaWVkZSBpbCBmcmFtZSBpbiBsaW5lYS4gSGFpIGdsaSBpZnJhbWUgZGlzYWJpbGl0YXRpIG8gaWwgYnJvd3NlciBub24gbGkgc3VwcG9ydGEuIiwibG9hZGluZ0FuaW1hdGlvbiI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWluY2x1ZGVzL2pzL3RoaWNrYm94L2xvYWRpbmdBbmltYXRpb24uZ2lmIn0=" defer></script>
<script data-optimized="1" id="thickbox-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/7cd7b7f36836d52fd3e67198c204f882.js?ver=0cf4c" defer data-deferred="1"></script>
<script id="jquery-ui-core-js-before" src="data:text/javascript;base64,alF1ZXJ5LnVpQmFja0NvbXBhdD0hMA==" defer></script>
<script data-optimized="1" id="jquery-ui-core-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/7551c43cec1dfc51a17d7b78e3d79886.js?ver=74224" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-ui-tooltip-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/e81c4a7c39e0bc5ce67f8e99aea2af2e.js?ver=2de31" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-ui-mouse-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/4b979d0f99246060f63dc04090111a34.js?ver=305a0" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-ui-slider-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/1197abdc32ab83a69b14eec5b79e1f06.js?ver=5d95a" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-ui-datepicker-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/54a1a0f32168d1bef8faf19365f3581c.js?ver=cfbb8" defer data-deferred="1"></script>
<script id="jquery-ui-datepicker-js-after" src="data:text/javascript;base64,alF1ZXJ5KGZ1bmN0aW9uKGpRdWVyeSl7alF1ZXJ5LmRhdGVwaWNrZXIuc2V0RGVmYXVsdHMoeyJjbG9zZVRleHQiOiJDaGl1ZGkiLCJjdXJyZW50VGV4dCI6Ik9nZ2kiLCJtb250aE5hbWVzIjpbIkdlbm5haW8iLCJGZWJicmFpbyIsIk1hcnpvIiwiQXByaWxlIiwiTWFnZ2lvIiwiR2l1Z25vIiwiTHVnbGlvIiwiQWdvc3RvIiwiU2V0dGVtYnJlIiwiT3R0b2JyZSIsIk5vdmVtYnJlIiwiRGljZW1icmUiXSwibW9udGhOYW1lc1Nob3J0IjpbIkdlbiIsIkZlYiIsIk1hciIsIkFwciIsIk1hZyIsIkdpdSIsIkx1ZyIsIkFnbyIsIlNldCIsIk90dCIsIk5vdiIsIkRpYyJdLCJuZXh0VGV4dCI6Ik5leHQiLCJwcmV2VGV4dCI6IlByZXZpb3VzIiwiZGF5TmFtZXMiOlsiZG9tZW5pY2EiLCJsdW5lZFx1MDBlYyIsIm1hcnRlZFx1MDBlYyIsIm1lcmNvbGVkXHUwMGVjIiwiZ2lvdmVkXHUwMGVjIiwidmVuZXJkXHUwMGVjIiwic2FiYXRvIl0sImRheU5hbWVzU2hvcnQiOlsiRG9tIiwiTHVuIiwiTWFyIiwiTWVyIiwiR2lvIiwiVmVuIiwiU2FiIl0sImRheU5hbWVzTWluIjpbIkQiLCJMIiwiTSIsIk0iLCJHIiwiViIsIlMiXSwiZGF0ZUZvcm1hdCI6ImQgTU0geXkiLCJmaXJzdERheSI6MSwiaXNSVEwiOiExfSl9KQ==" defer></script>
<script data-optimized="1" id="jquery-effects-core-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/d07791d93d8c6407cc425a952409b3be.js?ver=83a64" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-ui-menu-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/0690d10a10618ef2ef4020a1ee5bff47.js?ver=9a037" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-dom-ready-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/6492f64af2f74486bf7a70afc2260607.js?ver=27c8e" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-hooks-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/f84e88a6ddd53ef5cc5b24773a501bd0.js?ver=b5e9f" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-i18n-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/4b114ee18e22025b760f414c5b31b64a.js?ver=841dd" defer data-deferred="1"></script>
<script id="wp-i18n-js-after" src="data:text/javascript;base64,d3AuaTE4bi5zZXRMb2NhbGVEYXRhKHsndGV4dCBkaXJlY3Rpb25cdTAwMDRsdHInOlsnbHRyJ119KQ==" defer></script>
<script id="wp-a11y-js-translations" src="data:text/javascript;base64,KGZ1bmN0aW9uKGRvbWFpbix0cmFuc2xhdGlvbnMpe3ZhciBsb2NhbGVEYXRhPXRyYW5zbGF0aW9ucy5sb2NhbGVfZGF0YVtkb21haW5dfHx0cmFuc2xhdGlvbnMubG9jYWxlX2RhdGEubWVzc2FnZXM7bG9jYWxlRGF0YVsiIl0uZG9tYWluPWRvbWFpbjt3cC5pMThuLnNldExvY2FsZURhdGEobG9jYWxlRGF0YSxkb21haW4pfSkoImRlZmF1bHQiLHsidHJhbnNsYXRpb24tcmV2aXNpb24tZGF0ZSI6IjIwMjYtMDQtMDIgMTc6MTE6MjgrMDAwMCIsImdlbmVyYXRvciI6Ikdsb3RQcmVzc1wvNC4wLjMiLCJkb21haW4iOiJtZXNzYWdlcyIsImxvY2FsZV9kYXRhIjp7Im1lc3NhZ2VzIjp7IiI6eyJkb21haW4iOiJtZXNzYWdlcyIsInBsdXJhbC1mb3JtcyI6Im5wbHVyYWxzPTI7IHBsdXJhbD1uICE9IDE7IiwibGFuZyI6Iml0In0sIk5vdGlmaWNhdGlvbnMiOlsiTm90aWZpY2hlIl19fSwiY29tbWVudCI6eyJyZWZlcmVuY2UiOiJ3cC1pbmNsdWRlc1wvanNcL2Rpc3RcL2ExMXkuanMifX0p" defer></script>
<script data-optimized="1" id="wp-a11y-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/82bff17ae976a1ca7cc0d1e3f9aff27c.js?ver=b069c" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-ui-autocomplete-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/df9349a78f452c6d7473faa72ead1e9b.js?ver=6717a" defer data-deferred="1"></script>
<script data-optimized="1" id="lfb_frontend-libs-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/dd3890664793f9ff51c7a20d2cd52a25.js?ver=76f2d" defer data-deferred="1"></script>
<script data-optimized="1" id="touchpunch-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/2acae1a02a1f6fbcca72af8a5610fed0.js?ver=c7dd6" defer data-deferred="1"></script>
<script id="lfb_frontend-js-extra" src="data:text/javascript;base64,dmFyIGxmYl9mb3Jtcz1beyJjdXJyZW50UmVmIjowLCJyZWZWYXJOYW1lIjoicmVmIiwiaG9tZVVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tIiwiYWpheHVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWFkbWluL2FkbWluLWFqYXgucGhwIiwiaW5pdGlhbFByaWNlIjoiMCIsIm1heF9wcmljZSI6IjAiLCJwZXJjZW50VG9QYXkiOiIxMDAiLCJmaXhlZFRvUGF5IjoiMTAwIiwicGF5TW9kZSI6IiIsImN1cnJlbmN5IjoiJCIsImN1cnJlbmN5UG9zaXRpb24iOiJsZWZ0IiwiaW50cm9fZW5hYmxlZCI6IjEiLCJzYXZlX3RvX2NhcnQiOiIwIiwic2F2ZV90b19jYXJ0X2VkZCI6IjAiLCJjb2xvckEiOiIjZjA3NjFmIiwiYW5pbWF0aW9uc1NwZWVkIjoiMC4zIiwiZW1haWxfdG9Vc2VyIjoiMSIsInNob3dTdGVwcyI6IjIiLCJmb3JtSUQiOiI4IiwiZ3Jhdml0eUZvcm1JRCI6IjAiLCJzaG93SW5pdGlhbFByaWNlIjoiMSIsImRpc2FibGVUaXBNb2JpbGUiOiIwIiwibGVnYWxOb3RpY2VFbmFibGUiOiIwIiwibGlua3MiOlt7ImlkIjoiOTU0NyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY0IiwiZGVzdGluYXRpb25JRCI6IjY2IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiNjRfNTIxXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU0OCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY0IiwiZGVzdGluYXRpb25JRCI6IjcwIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiNjRfNTIwXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU0OSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY0IiwiZGVzdGluYXRpb25JRCI6Ijg3IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiNjRfNTI2XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1MCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY0IiwiZGVzdGluYXRpb25JRCI6IjY5IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiNjRfNTIzXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1MSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY0IiwiZGVzdGluYXRpb25JRCI6IjY4IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiNjRfNTIyXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1MiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY0IiwiZGVzdGluYXRpb25JRCI6IjY1IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiNjRfNjE1XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1MyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY2IiwiZGVzdGluYXRpb25JRCI6Ijk0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1NCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijk0IiwiZGVzdGluYXRpb25JRCI6Ijg2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1NSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijg2IiwiZGVzdGluYXRpb25JRCI6IjkxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1NiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjcwIiwiZGVzdGluYXRpb25JRCI6Ijc3IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1NyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijc3IiwiZGVzdGluYXRpb25JRCI6IjkyIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1OCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijg3IiwiZGVzdGluYXRpb25JRCI6Ijg4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1OSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijg4IiwiZGVzdGluYXRpb25JRCI6IjcxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU2MCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjczIiwiZGVzdGluYXRpb25JRCI6Ijg5IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU2MSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY5IiwiZGVzdGluYXRpb25JRCI6IjczIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU2MiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY5IiwiZGVzdGluYXRpb25JRCI6IjE3OSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjY5XzQ0MFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1NjMiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI2OCIsImRlc3RpbmF0aW9uSUQiOiI5MCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1NjQiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI2NSIsImRlc3RpbmF0aW9uSUQiOiI5MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1NjUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzkiLCJkZXN0aW5hdGlvbklEIjoiOTEiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCI2OV80NDBcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTY2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTMiLCJkZXN0aW5hdGlvbklEIjoiOTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTY3IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTAiLCJkZXN0aW5hdGlvbklEIjoiOTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTY4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiODkiLCJkZXN0aW5hdGlvbklEIjoiOTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTY5IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiNzEiLCJkZXN0aW5hdGlvbklEIjoiOTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTcwIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTIiLCJkZXN0aW5hdGlvbklEIjoiOTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTcxIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTEiLCJkZXN0aW5hdGlvbklEIjoiOTUiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCI5MV83MzhcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTcyIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTEiLCJkZXN0aW5hdGlvbklEIjoiOTgiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCI5MV83MDhcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTczIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTEiLCJkZXN0aW5hdGlvbklEIjoiMTAxIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiOTFfNzAxXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU3NCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjkxIiwiZGVzdGluYXRpb25JRCI6IjEwNCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjkxXzcwMlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1NzUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI5MSIsImRlc3RpbmF0aW9uSUQiOiIxMDciLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCI5MV83MDNcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTc2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTEiLCJkZXN0aW5hdGlvbklEIjoiMTA5IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiOTFfNzA1XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU3NyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijk1IiwiZGVzdGluYXRpb25JRCI6Ijk2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU3OCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijk2IiwiZGVzdGluYXRpb25JRCI6Ijk3IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU3OSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijk4IiwiZGVzdGluYXRpb25JRCI6Ijk5IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU4MCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijk5IiwiZGVzdGluYXRpb25JRCI6IjEwMCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1ODEiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMDEiLCJkZXN0aW5hdGlvbklEIjoiMTAyIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU4MiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEwMiIsImRlc3RpbmF0aW9uSUQiOiIxMDMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTgzIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTA0IiwiZGVzdGluYXRpb25JRCI6IjEwNSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1ODQiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMDUiLCJkZXN0aW5hdGlvbklEIjoiMTA2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU4NSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEwNyIsImRlc3RpbmF0aW9uSUQiOiIxMDgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTg2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTA5IiwiZGVzdGluYXRpb25JRCI6IjExMCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1ODciLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMDQiLCJkZXN0aW5hdGlvbklEIjoiMTgwIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTA0Xzg1N1wiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1ODgiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI5NyIsImRlc3RpbmF0aW9uSUQiOiIxMTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTg5IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTAwIiwiZGVzdGluYXRpb25JRCI6IjExMSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1OTAiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMDMiLCJkZXN0aW5hdGlvbklEIjoiMTExIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU5MSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEwNiIsImRlc3RpbmF0aW9uSUQiOiIxMTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTkyIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTA4IiwiZGVzdGluYXRpb25JRCI6IjExMSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1OTMiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMTAiLCJkZXN0aW5hdGlvbklEIjoiMTExIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU5NCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE4MCIsImRlc3RpbmF0aW9uSUQiOiIxMTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTk1IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjEyNyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV85MDFcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTk2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjEyNCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV84OTlcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTk3IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjEyMSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV84OTJcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTk4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjExOCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV84OTNcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTk5IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjExNSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV84OTRcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjAwIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjExMyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV84OTZcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjAyIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTEzIiwiZGVzdGluYXRpb25JRCI6IjExMiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MDMiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMTUiLCJkZXN0aW5hdGlvbklEIjoiMTE0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYwNCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjExOCIsImRlc3RpbmF0aW9uSUQiOiIxODEiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxMThfOTM3XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYwNSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjExOCIsImRlc3RpbmF0aW9uSUQiOiIxMTciLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjA2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTE3IiwiZGVzdGluYXRpb25JRCI6IjExNiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MDciLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMjEiLCJkZXN0aW5hdGlvbklEIjoiMTIwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYwOCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyMCIsImRlc3RpbmF0aW9uSUQiOiIxMTkiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjA5IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTI0IiwiZGVzdGluYXRpb25JRCI6IjEyMyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MTAiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMjMiLCJkZXN0aW5hdGlvbklEIjoiMTIyIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYxMiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyNiIsImRlc3RpbmF0aW9uSUQiOiIxMjciLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxMjdfMTAwMVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIxMjdfMTAwMlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTYxMyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyNiIsImRlc3RpbmF0aW9uSUQiOiIxMjUiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjE0IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTI1IiwiZGVzdGluYXRpb25JRCI6IjEyOCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MTUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMjIiLCJkZXN0aW5hdGlvbklEIjoiMTI4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYxNiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjExOSIsImRlc3RpbmF0aW9uSUQiOiIxMjgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjE3IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTE2IiwiZGVzdGluYXRpb25JRCI6IjEyOCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MTgiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMTQiLCJkZXN0aW5hdGlvbklEIjoiMTI4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYxOSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjExMiIsImRlc3RpbmF0aW9uSUQiOiIxMjgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjIwIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTI4IiwiZGVzdGluYXRpb25JRCI6IjEyOSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjEyOF8xMDE0XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYyMSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyOCIsImRlc3RpbmF0aW9uSUQiOiIxMzQiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxMjhfMTAxMlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MjIiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMjgiLCJkZXN0aW5hdGlvbklEIjoiMTM3IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTI4XzEwMDVcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjIzIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTI4IiwiZGVzdGluYXRpb25JRCI6IjE0MCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjEyOF8xMDA2XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYyNCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyOCIsImRlc3RpbmF0aW9uSUQiOiIxNDIiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxMjhfMTAwN1wiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MjUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMjgiLCJkZXN0aW5hdGlvbklEIjoiMTQ0IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTI4XzEwMDlcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjI2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTQwIiwiZGVzdGluYXRpb25JRCI6IjE4MiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE0MF8xMDk0XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYyNyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyOSIsImRlc3RpbmF0aW9uSUQiOiIxMzAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjI4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTM0IiwiZGVzdGluYXRpb25JRCI6IjEzMyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MjkiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMzciLCJkZXN0aW5hdGlvbklEIjoiMTM2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYzMCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE0MCIsImRlc3RpbmF0aW9uSUQiOiIxMzkiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjMxIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTQyIiwiZGVzdGluYXRpb25JRCI6IjE0MSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MzIiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNDQiLCJkZXN0aW5hdGlvbklEIjoiMTQzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYzMyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEzMCIsImRlc3RpbmF0aW9uSUQiOiIxMzEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjM0IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTMzIiwiZGVzdGluYXRpb25JRCI6IjEzMiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MzUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMzYiLCJkZXN0aW5hdGlvbklEIjoiMTM1IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYzNiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEzOSIsImRlc3RpbmF0aW9uSUQiOiIxMzgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjM3IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTMxIiwiZGVzdGluYXRpb25JRCI6IjE2MSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MzgiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMzIiLCJkZXN0aW5hdGlvbklEIjoiMTYxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYzOSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEzNSIsImRlc3RpbmF0aW9uSUQiOiIxNjEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjQwIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTM4IiwiZGVzdGluYXRpb25JRCI6IjE2MSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NDEiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNDEiLCJkZXN0aW5hdGlvbklEIjoiMTYxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY0MiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE0MyIsImRlc3RpbmF0aW9uSUQiOiIxNjEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjQzIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTgxIiwiZGVzdGluYXRpb25JRCI6IjEyOCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NDQiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxODIiLCJkZXN0aW5hdGlvbklEIjoiMTYxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY0NSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE1NiIsImRlc3RpbmF0aW9uSUQiOiIxODMiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxNTZfMTE5NlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NDYiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNjAiLCJkZXN0aW5hdGlvbklEIjoiMTU5IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY0NyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE1OCIsImRlc3RpbmF0aW9uSUQiOiIxNTciLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjQ4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTU2IiwiZGVzdGluYXRpb25JRCI6IjE1NSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NDkiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNTUiLCJkZXN0aW5hdGlvbklEIjoiMTU0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY1MCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE1MyIsImRlc3RpbmF0aW9uSUQiOiIxNTIiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjUxIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTUyIiwiZGVzdGluYXRpb25JRCI6IjE1MSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NTIiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNTAiLCJkZXN0aW5hdGlvbklEIjoiMTQ5IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY1MyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE0OSIsImRlc3RpbmF0aW9uSUQiOiIxNDgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjU0IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTYxIiwiZGVzdGluYXRpb25JRCI6IjE1MCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE2MV8xMjI3XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY1NSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE0NSIsImRlc3RpbmF0aW9uSUQiOiIxNDYiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjU2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTQ2IiwiZGVzdGluYXRpb25JRCI6IjE0NyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NTciLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNjEiLCJkZXN0aW5hdGlvbklEIjoiMTQ1IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTYxXzEyMjlcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjU4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTYxIiwiZGVzdGluYXRpb25JRCI6IjE1MyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE2MV8xMjIwXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY1OSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE2MSIsImRlc3RpbmF0aW9uSUQiOiIxNTYiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxNjFfMTIyMVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NjAiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNjEiLCJkZXN0aW5hdGlvbklEIjoiMTU4IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTYxXzEyMjJcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjYxIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTYxIiwiZGVzdGluYXRpb25JRCI6IjE2MCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE2MV8xMjI0XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY2MiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE0NyIsImRlc3RpbmF0aW9uSUQiOiIxNzgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjYzIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTQ4IiwiZGVzdGluYXRpb25JRCI6IjE3OCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NjQiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNTEiLCJkZXN0aW5hdGlvbklEIjoiMTc4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY2NSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE1NCIsImRlc3RpbmF0aW9uSUQiOiIxNzgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjY2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTU3IiwiZGVzdGluYXRpb25JRCI6IjE3OCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NjciLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNTkiLCJkZXN0aW5hdGlvbklEIjoiMTc4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY2OCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE4MyIsImRlc3RpbmF0aW9uSUQiOiIxNzgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjY5IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTc4IiwiZGVzdGluYXRpb25JRCI6IjE2MiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE3OF8xMzQyXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY3MCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE3OCIsImRlc3RpbmF0aW9uSUQiOiIxNjUiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxNzhfMTM0MFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NzEiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzgiLCJkZXN0aW5hdGlvbklEIjoiMTY4IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTc4XzEzMzNcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjcyIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTc4IiwiZGVzdGluYXRpb25JRCI6IjE3MSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE3OF8xMzM0XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY3MyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE3OCIsImRlc3RpbmF0aW9uSUQiOiIxNzQiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxNzhfMTMzNVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NzQiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzgiLCJkZXN0aW5hdGlvbklEIjoiMTc2IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTc4XzEzMzdcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Njc1IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTYyIiwiZGVzdGluYXRpb25JRCI6IjE2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NzYiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNjMiLCJkZXN0aW5hdGlvbklEIjoiMTY0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY3NyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE2NSIsImRlc3RpbmF0aW9uSUQiOiIxNjYiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Njc4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTY2IiwiZGVzdGluYXRpb25JRCI6IjE2NyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NzkiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNjgiLCJkZXN0aW5hdGlvbklEIjoiMTY5IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY4MCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE2OSIsImRlc3RpbmF0aW9uSUQiOiIxNzAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjgxIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTcxIiwiZGVzdGluYXRpb25JRCI6IjE3MiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2ODIiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzIiLCJkZXN0aW5hdGlvbklEIjoiMTczIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY4MyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE3NCIsImRlc3RpbmF0aW9uSUQiOiIxNzUiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Njg0IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTc2IiwiZGVzdGluYXRpb25JRCI6IjE3NyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2ODUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzEiLCJkZXN0aW5hdGlvbklEIjoiMTg0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY4NiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE4NCIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2ODciLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzciLCJkZXN0aW5hdGlvbklEIjoiNjMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Njg4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTc1IiwiZGVzdGluYXRpb25JRCI6IjYzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY4OSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE3MyIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2OTAiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzAiLCJkZXN0aW5hdGlvbklEIjoiNjMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjkxIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTY3IiwiZGVzdGluYXRpb25JRCI6IjYzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY5MiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE2NCIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2OTMiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI2MyIsImRlc3RpbmF0aW9uSUQiOiI1OSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2OTQiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI1OSIsImRlc3RpbmF0aW9uSUQiOiI2MSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2OTUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI2MSIsImRlc3RpbmF0aW9uSUQiOiI2MiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2OTYiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI5MSIsImRlc3RpbmF0aW9uSUQiOiIxODAiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCI5MV83MDZcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifSx7XCJpbnRlcmFjdGlvblwiOlwiOTFfNzA0XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiJPUiJ9LHsiaWQiOiI5Njk3IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjE4MSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV84OTdcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifSx7XCJpbnRlcmFjdGlvblwiOlwiMTExXzg5NVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTY5OCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyOCIsImRlc3RpbmF0aW9uSUQiOiIxODIiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxMjhfMTAxMFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIxMjhfMTAwOFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTY5OSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE2MSIsImRlc3RpbmF0aW9uSUQiOiIxODMiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxNjFfMTIyNVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIxNjFfMTIyM1wiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTcwMCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE3OCIsImRlc3RpbmF0aW9uSUQiOiIxODQiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxNzhfMTMzOFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIxNzhfMTMzNlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTcwMSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE3OCIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MDIiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNjEiLCJkZXN0aW5hdGlvbklEIjoiNjMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzAzIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTI4IiwiZGVzdGluYXRpb25JRCI6IjYzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcwNCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjExMSIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MDUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI5MSIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MDYiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI2NCIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn1dLCJjbG9zZV91cmwiOiIjIiwicmVkaXJlY3Rpb25zIjpbeyJpZCI6IjEiLCJmb3JtSUQiOiI4IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn0seyJpZCI6IjIiLCJmb3JtSUQiOiI4IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn0seyJpZCI6IjMiLCJmb3JtSUQiOiI4IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn0seyJpZCI6IjQiLCJmb3JtSUQiOiI4IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn0seyJpZCI6IjUiLCJmb3JtSUQiOiI4IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn0seyJpZCI6IjYiLCJmb3JtSUQiOiI4IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn1dLCJ1c2VSZWRpcmVjdGlvbkNvbmRpdGlvbnMiOiIwIiwidXNlUGRmIjoxLCJ0eHRfeWVzIjoiWWVzIiwidHh0X25vIjoiTm8iLCJ0eHRfbGFzdEJ0biI6IlN1Ym1pdCIsInR4dF9idG5TdGVwIjoiTmV4dCAiLCJkYXRlRm9ybWF0IjoiZCBNTSB5eXl5IiwiZGF0ZVBpY2tlckxhbmd1YWdlIjoiIiwidGhvdXNhbmRzU2VwYXJhdG9yIjoiIiwiZGVjaW1hbHNTZXBhcmF0b3IiOiIuIiwibWlsbGlvblNlcGFyYXRvciI6IiIsImJpbGxpb25zU2VwYXJhdG9yIjoiIiwic3VtbWFyeV9oaWRlUXQiOiIxIiwic3VtbWFyeV9oaWRlWmVybyI6IjEiLCJzdW1tYXJ5X2hpZGVaZXJvUXQiOiIxIiwic3VtbWFyeV9oaWRlUHJpY2VzIjoiMSIsInN1bW1hcnlfaGlkZVplcm9EZWNpbWFscyI6IjEiLCJncm91cEF1dG9DbGljayI6IjEiLCJmaWxlc1VwbG9hZF90ZXh0IjoiRHJvcCBmaWxlcyBoZXJlIHRvIHVwbG9hZCIsImZpbGVzVXBsb2FkU2l6ZV90ZXh0IjoiRmlsZSBpcyB0b28gYmlnIChtYXggc2l6ZToge3ttYXhGaWxlc2l6ZX19TUIpIiwiZmlsZXNVcGxvYWRUeXBlX3RleHQiOiJJbnZhbGlkIGZpbGUgdHlwZSIsImZpbGVzVXBsb2FkTGltaXRfdGV4dCI6IllvdSBjYW4gbm90IHVwbG9hZCBhbnkgbW9yZSBmaWxlcyIsInNlbmRDb250YWN0QVNBUCI6IjEiLCJzaG93VG90YWxCb3R0b20iOiIwIiwic3RyaXBlUHViS2V5IjoiIiwic2Nyb2xsVG9wTWFyZ2luIjoiMCIsInNjcm9sbFRvcE1hcmdpbk1vYmlsZSI6IjAiLCJyZWRpcmVjdGlvbkRlbGF5IjoiMCIsImdtYXBfa2V5IjoiIiwidHh0RGlzdGFuY2VFcnJvciI6IkNhbGN1bGF0aW5nIHRoZSBkaXN0YW5jZSBjb3VsZCBub3QgYmUgcGVyZm9ybWVkLCBwbGVhc2UgdmVyaWZ5IHRoZSBpbnB1dCBhZGRyZXNzZXMiLCJjYXB0Y2hhVXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vd3AtY29udGVudC9wbHVnaW5zL1dQX0VzdGltYXRpb25fRm9ybS9pbmNsdWRlcy9jYXB0Y2hhL2dldF9jYXB0Y2hhLnBocCIsInN1bW1hcnlfbm9EZWNpbWFscyI6IjEiLCJzY3JvbGxUb3BQYWdlIjoiMSIsImRpc2FibGVEcm9wZG93bnMiOiIxIiwiaW1nSWNvblN0eWxlIjoiem9vbSIsInN1bW1hcnlfaGlkZUZpbmFsU3RlcCI6IjEiLCJ0aW1lTW9kZUFNIjoiMCIsImVuYWJsZVNoaW5lRnhCdG4iOiIxIiwic3VtbWFyeV9zaG93QWxsUHJpY2VzRW1haWwiOiIwIiwiaW1nVGl0bGVzU3R5bGUiOiIiLCJsYXN0UyI6IjE2NjYwOTMxMjUyNDEiLCJlbXB0eVdvb0NhcnQiOiIwIiwic2VuZFVybFZhcmlhYmxlcyI6IjAiLCJzZW5kVmFyaWFibGVzTWV0aG9kIjoiIiwiZW5hYmxlWmFwaWVyIjoiMCIsInphcGllcldlYkhvb2siOiIiLCJzdW1tYXJ5X3Nob3dEZXNjcmlwdGlvbnMiOiIxIiwiaW1nUHJldmlldyI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWNvbnRlbnQvcGx1Z2lucy9XUF9Fc3RpbWF0aW9uX0Zvcm0vYXNzZXRzL2ltZy9maWxlLTMtMTI4LnBuZyIsInByb2dyZXNzQmFyUHJpY2VUeXBlIjoiIiwicmF6b3JwYXlfcHVibGlzaEtleSI6IiIsInJhem9ycGF5X2xvZ29JbWciOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS93cC1jb250ZW50L3VwbG9hZHMvMjAyMi8xMC9jcmVkaXRDYXJkQDJ4LnBuZyIsInZhcmlhYmxlcyI6W10sInVzZUVtYWlsVmVyaWZpY2F0aW9uIjoiMCIsInR4dF9lbWFpbEFjdGl2YXRpb25Db2RlIjoiRmlsbCB5b3VyIHZlcmlmaWNhdGlvbiBjb2RlIGhlcmUiLCJ0eHRfZW1haWxBY3RpdmF0aW9uSW5mbyI6IkEgdW5pcXVlIHZlcmlmaWNhdGlvbiBjb2RlIGhhcyBqdXN0IGJlZW4gc2VudCB0byB5b3UgYnkgZW1haWwsIHBsZWFzZSBjb3B5IGl0IGluIHRoZSBmaWVsZCBiZWxvdyB0byB2YWxpZGF0ZSB5b3VyIGVtYWlsIGFkZHJlc3MuIiwidXNlQ2FwdGNoYSI6IjAiLCJyZWNhcHRjaGEzS2V5IjoiIiwiZGlzdGFuY2VzTW9kZSI6InJvdXRlIiwiZW5hYmxlQ3VzdG9tZXJBY2NvdW50IjoiMCIsInR4dEN1c3RvbWVyc0RhdGFGb3Jnb3RQYXNzU2VudCI6IiIsInR4dEN1c3RvbWVyc0RhdGFGb3Jnb3RQYXNzTGluayI6IiIsImVtYWlsQ3VzdG9tZXJMaW5rcyI6IjEiLCJlbmFibGVQZGZEb3dubG9hZCI6IjEiLCJ1c2VTaWduYXR1cmUiOiIwIiwidXNlVkFUIjoiMCIsInZhdEFtb3VudCI6IjIwIiwidmF0TGFiZWwiOiJWQVQiLCJhdXRvY2xvc2VEYXRlcGlja2VyIjoiMCIsImZsb2F0U3VtbWFyeV9zaG93SW5mbyI6IjEiLCJoaWRlRmluYWxidG4iOiIwIiwiY2FydFBhZ2UiOiIiLCJkaXNhYmxlU2Nyb2xsIjoiMCJ9LHsiY3VycmVudFJlZiI6MCwicmVmVmFyTmFtZSI6InJlZiIsImhvbWVVcmwiOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbSIsImFqYXh1cmwiOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS93cC1hZG1pbi9hZG1pbi1hamF4LnBocCIsImluaXRpYWxQcmljZSI6IjAiLCJtYXhfcHJpY2UiOiIwIiwicGVyY2VudFRvUGF5IjoiMTAwIiwiZml4ZWRUb1BheSI6IjEwMCIsInBheU1vZGUiOiIiLCJjdXJyZW5jeSI6IiQiLCJjdXJyZW5jeVBvc2l0aW9uIjoibGVmdCIsImludHJvX2VuYWJsZWQiOiIxIiwic2F2ZV90b19jYXJ0IjoiMCIsInNhdmVfdG9fY2FydF9lZGQiOiIwIiwiY29sb3JBIjoiI2YwNzYxZiIsImFuaW1hdGlvbnNTcGVlZCI6IjAuMyIsImVtYWlsX3RvVXNlciI6IjEiLCJzaG93U3RlcHMiOiIyIiwiZm9ybUlEIjoiOSIsImdyYXZpdHlGb3JtSUQiOiIwIiwic2hvd0luaXRpYWxQcmljZSI6IjEiLCJkaXNhYmxlVGlwTW9iaWxlIjoiMCIsImxlZ2FsTm90aWNlRW5hYmxlIjoiMCIsImxpbmtzIjpbeyJpZCI6Ijk3MDciLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxODkiLCJkZXN0aW5hdGlvbklEIjoiMTkxIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTg5XzE0NDlcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzA4IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTg5IiwiZGVzdGluYXRpb25JRCI6IjE5NCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE4OV8xNDQ4XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcwOSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjE4OSIsImRlc3RpbmF0aW9uSUQiOiIxOTkiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxODlfMTQ1MlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MTAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxODkiLCJkZXN0aW5hdGlvbklEIjoiMTkzIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTg5XzE0NTFcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzExIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTg5IiwiZGVzdGluYXRpb25JRCI6IjE5MiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE4OV8xNDUwXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcxMiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjE4OSIsImRlc3RpbmF0aW9uSUQiOiIxOTAiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxODlfMTQ1M1wiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MTMiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxOTEiLCJkZXN0aW5hdGlvbklEIjoiMjA2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcxNCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIwNiIsImRlc3RpbmF0aW9uSUQiOiIxOTgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzE1IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTk4IiwiZGVzdGluYXRpb25JRCI6IjIwMyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MTYiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxOTQiLCJkZXN0aW5hdGlvbklEIjoiMTk3IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcxNyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjE5NyIsImRlc3RpbmF0aW9uSUQiOiIyMDQiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzE4IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTk5IiwiZGVzdGluYXRpb25JRCI6IjIwMCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MTkiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMDAiLCJkZXN0aW5hdGlvbklEIjoiMTk1IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcyMCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjE5NiIsImRlc3RpbmF0aW9uSUQiOiIyMDEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzIxIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTkzIiwiZGVzdGluYXRpb25JRCI6IjE5NiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MjIiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxOTMiLCJkZXN0aW5hdGlvbklEIjoiMjkxIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTkzXzE0NzZcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzIzIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTkyIiwiZGVzdGluYXRpb25JRCI6IjIwMiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MjQiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxOTAiLCJkZXN0aW5hdGlvbklEIjoiMjA1IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcyNSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI5MSIsImRlc3RpbmF0aW9uSUQiOiIyMDMiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxOTNfMTQ3NlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MjYiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMDUiLCJkZXN0aW5hdGlvbklEIjoiMjAzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcyNyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIwMiIsImRlc3RpbmF0aW9uSUQiOiIyMDMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzI4IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjAxIiwiZGVzdGluYXRpb25JRCI6IjIwMyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MjkiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxOTUiLCJkZXN0aW5hdGlvbklEIjoiMjAzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTczMCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIwNCIsImRlc3RpbmF0aW9uSUQiOiIyMDMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzMxIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjAzIiwiZGVzdGluYXRpb25JRCI6IjIwNyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjIwM18xNTQ2XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTczMiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIwMyIsImRlc3RpbmF0aW9uSUQiOiIyMTAiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyMDNfMTU0NFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MzMiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMDMiLCJkZXN0aW5hdGlvbklEIjoiMjEzIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjAzXzE1MzdcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzM0IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjAzIiwiZGVzdGluYXRpb25JRCI6IjIxNiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjIwM18xNTM4XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTczNSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIwMyIsImRlc3RpbmF0aW9uSUQiOiIyMTkiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyMDNfMTUzOVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MzYiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMDMiLCJkZXN0aW5hdGlvbklEIjoiMjIxIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjAzXzE1NDFcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzM3IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjA3IiwiZGVzdGluYXRpb25JRCI6IjIwOCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MzgiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMDgiLCJkZXN0aW5hdGlvbklEIjoiMjA5IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTczOSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIxMCIsImRlc3RpbmF0aW9uSUQiOiIyMTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzQwIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjExIiwiZGVzdGluYXRpb25JRCI6IjIxMiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NDEiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMTMiLCJkZXN0aW5hdGlvbklEIjoiMjE0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc0MiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIxNCIsImRlc3RpbmF0aW9uSUQiOiIyMTUiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzQzIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjE2IiwiZGVzdGluYXRpb25JRCI6IjIxNyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NDQiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMTciLCJkZXN0aW5hdGlvbklEIjoiMjE4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc0NSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIxOSIsImRlc3RpbmF0aW9uSUQiOiIyMjAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzQ2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjIxIiwiZGVzdGluYXRpb25JRCI6IjIyMiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NDciLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMTYiLCJkZXN0aW5hdGlvbklEIjoiMjkyIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjE2XzE2MjZcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzQ4IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjA5IiwiZGVzdGluYXRpb25JRCI6IjIyMyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NDkiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMTIiLCJkZXN0aW5hdGlvbklEIjoiMjIzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc1MCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIxNSIsImRlc3RpbmF0aW9uSUQiOiIyMjMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzUxIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjE4IiwiZGVzdGluYXRpb25JRCI6IjIyMyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NTIiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMjAiLCJkZXN0aW5hdGlvbklEIjoiMjIzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc1MyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIyMiIsImRlc3RpbmF0aW9uSUQiOiIyMjMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzU0IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjkyIiwiZGVzdGluYXRpb25JRCI6IjIyMyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NTUiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMjMiLCJkZXN0aW5hdGlvbklEIjoiMjM5IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjIzXzE2NjNcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzU2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjIzIiwiZGVzdGluYXRpb25JRCI6IjIzNiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjIyM18xNjYxXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc1NyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIyMyIsImRlc3RpbmF0aW9uSUQiOiIyMzMiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyMjNfMTY1NFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NTgiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMjMiLCJkZXN0aW5hdGlvbklEIjoiMjMwIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjIzXzE2NTVcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzU5IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjIzIiwiZGVzdGluYXRpb25JRCI6IjIyNyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjIyM18xNjU2XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc2MCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIyMyIsImRlc3RpbmF0aW9uSUQiOiIyMjUiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyMjNfMTY1OFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NjEiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMjUiLCJkZXN0aW5hdGlvbklEIjoiMjI0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc2MiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIyNyIsImRlc3RpbmF0aW9uSUQiOiIyMjYiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzYzIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjMwIiwiZGVzdGluYXRpb25JRCI6IjI5MyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjIzMF8xNjk0XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc2NCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIzMCIsImRlc3RpbmF0aW9uSUQiOiIyMjkiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzY1IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjI5IiwiZGVzdGluYXRpb25JRCI6IjIyOCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NjYiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMzMiLCJkZXN0aW5hdGlvbklEIjoiMjMyIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc2NyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIzMiIsImRlc3RpbmF0aW9uSUQiOiIyMzEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzY4IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjM2IiwiZGVzdGluYXRpb25JRCI6IjIzNSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NjkiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMzUiLCJkZXN0aW5hdGlvbklEIjoiMjM0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc3MCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIzOCIsImRlc3RpbmF0aW9uSUQiOiIyMzkiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyMzlfMTc1N1wiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIyMzlfMTc1OFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTc3MSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIzOCIsImRlc3RpbmF0aW9uSUQiOiIyMzciLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzcyIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjM3IiwiZGVzdGluYXRpb25JRCI6IjI0MCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NzMiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMzQiLCJkZXN0aW5hdGlvbklEIjoiMjQwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc3NCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIzMSIsImRlc3RpbmF0aW9uSUQiOiIyNDAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Nzc1IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjI4IiwiZGVzdGluYXRpb25JRCI6IjI0MCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NzYiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMjYiLCJkZXN0aW5hdGlvbklEIjoiMjQwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc3NyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIyNCIsImRlc3RpbmF0aW9uSUQiOiIyNDAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Nzc4IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjQwIiwiZGVzdGluYXRpb25JRCI6IjI0MSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI0MF8xNzcwXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc3OSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI0MCIsImRlc3RpbmF0aW9uSUQiOiIyNDYiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyNDBfMTc2OFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3ODAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNDAiLCJkZXN0aW5hdGlvbklEIjoiMjQ5IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjQwXzE3NjFcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzgxIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjQwIiwiZGVzdGluYXRpb25JRCI6IjI1MiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI0MF8xNzYyXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc4MiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI0MCIsImRlc3RpbmF0aW9uSUQiOiIyNTQiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyNDBfMTc2M1wiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3ODMiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNDAiLCJkZXN0aW5hdGlvbklEIjoiMjU2IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjQwXzE3NjVcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Nzg0IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjUyIiwiZGVzdGluYXRpb25JRCI6IjI5NCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI1Ml8xODQ1XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc4NSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI0MSIsImRlc3RpbmF0aW9uSUQiOiIyNDIiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Nzg2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjQ2IiwiZGVzdGluYXRpb25JRCI6IjI0NSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3ODciLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNDkiLCJkZXN0aW5hdGlvbklEIjoiMjQ4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc4OCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI1MiIsImRlc3RpbmF0aW9uSUQiOiIyNTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Nzg5IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjU0IiwiZGVzdGluYXRpb25JRCI6IjI1MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3OTAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNTYiLCJkZXN0aW5hdGlvbklEIjoiMjU1IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc5MSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI0MiIsImRlc3RpbmF0aW9uSUQiOiIyNDMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzkyIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjQ1IiwiZGVzdGluYXRpb25JRCI6IjI0NCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3OTMiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNDgiLCJkZXN0aW5hdGlvbklEIjoiMjQ3IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc5NCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI1MSIsImRlc3RpbmF0aW9uSUQiOiIyNTAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Nzk1IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjQzIiwiZGVzdGluYXRpb25JRCI6IjI3MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3OTYiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNDQiLCJkZXN0aW5hdGlvbklEIjoiMjczIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc5NyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI0NyIsImRlc3RpbmF0aW9uSUQiOiIyNzMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Nzk4IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjUwIiwiZGVzdGluYXRpb25JRCI6IjI3MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3OTkiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNTMiLCJkZXN0aW5hdGlvbklEIjoiMjczIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgwMCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI1NSIsImRlc3RpbmF0aW9uSUQiOiIyNzMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODAxIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjkzIiwiZGVzdGluYXRpb25JRCI6IjI0MCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MDIiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyOTQiLCJkZXN0aW5hdGlvbklEIjoiMjczIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgwMyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI2OCIsImRlc3RpbmF0aW9uSUQiOiIyOTUiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyNjhfMTk0MVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MDQiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNzIiLCJkZXN0aW5hdGlvbklEIjoiMjcxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgwNSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI3MCIsImRlc3RpbmF0aW9uSUQiOiIyNjkiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODA2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjY4IiwiZGVzdGluYXRpb25JRCI6IjI2NyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MDciLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNjciLCJkZXN0aW5hdGlvbklEIjoiMjY2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgwOCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI2NSIsImRlc3RpbmF0aW9uSUQiOiIyNjQiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODA5IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjY0IiwiZGVzdGluYXRpb25JRCI6IjI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MTAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNjIiLCJkZXN0aW5hdGlvbklEIjoiMjYxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgxMSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI2MSIsImRlc3RpbmF0aW9uSUQiOiIyNjAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODEyIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjczIiwiZGVzdGluYXRpb25JRCI6IjI2MiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI3M18xOTcwXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgxMyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI1NyIsImRlc3RpbmF0aW9uSUQiOiIyNTgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODE0IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjU4IiwiZGVzdGluYXRpb25JRCI6IjI1OSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MTUiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNzMiLCJkZXN0aW5hdGlvbklEIjoiMjU3IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjczXzE5NzJcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODE2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjczIiwiZGVzdGluYXRpb25JRCI6IjI2NSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI3M18xOTYzXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgxNyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI3MyIsImRlc3RpbmF0aW9uSUQiOiIyNjgiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyNzNfMTk2NFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MTgiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNzMiLCJkZXN0aW5hdGlvbklEIjoiMjcwIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjczXzE5NjVcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODE5IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjczIiwiZGVzdGluYXRpb25JRCI6IjI3MiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI3M18xOTY3XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgyMCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI1OSIsImRlc3RpbmF0aW9uSUQiOiIyOTAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODIxIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjYwIiwiZGVzdGluYXRpb25JRCI6IjI5MCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MjIiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNjMiLCJkZXN0aW5hdGlvbklEIjoiMjkwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgyMyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI2NiIsImRlc3RpbmF0aW9uSUQiOiIyOTAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODI0IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjY5IiwiZGVzdGluYXRpb25JRCI6IjI5MCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MjUiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNzEiLCJkZXN0aW5hdGlvbklEIjoiMjkwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgyNiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI5NSIsImRlc3RpbmF0aW9uSUQiOiIyOTAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODI3IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjkwIiwiZGVzdGluYXRpb25JRCI6IjI3NCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI5MF8yMDc4XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgyOCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI5MCIsImRlc3RpbmF0aW9uSUQiOiIyNzciLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyOTBfMjA3NlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MjkiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyOTAiLCJkZXN0aW5hdGlvbklEIjoiMjgwIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjkwXzIwNjlcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODMwIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjkwIiwiZGVzdGluYXRpb25JRCI6IjI4MyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI5MF8yMDcwXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgzMSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI5MCIsImRlc3RpbmF0aW9uSUQiOiIyODYiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyOTBfMjA3MVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MzIiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyOTAiLCJkZXN0aW5hdGlvbklEIjoiMjg4IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjkwXzIwNzNcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODMzIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjc0IiwiZGVzdGluYXRpb25JRCI6IjI3NSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MzQiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNzUiLCJkZXN0aW5hdGlvbklEIjoiMjc2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgzNSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI3NyIsImRlc3RpbmF0aW9uSUQiOiIyNzgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODM2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjc4IiwiZGVzdGluYXRpb25JRCI6IjI3OSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MzciLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyODAiLCJkZXN0aW5hdGlvbklEIjoiMjgxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgzOCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI4MSIsImRlc3RpbmF0aW9uSUQiOiIyODIiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODM5IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjgzIiwiZGVzdGluYXRpb25JRCI6IjI4NCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NDAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyODQiLCJkZXN0aW5hdGlvbklEIjoiMjg1IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTg0MSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI4NiIsImRlc3RpbmF0aW9uSUQiOiIyODciLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODQyIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjg4IiwiZGVzdGluYXRpb25JRCI6IjI4OSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NDMiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyODMiLCJkZXN0aW5hdGlvbklEIjoiMjk2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTg0NCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI5NiIsImRlc3RpbmF0aW9uSUQiOiIxODgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODQ1IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjg5IiwiZGVzdGluYXRpb25JRCI6IjE4OCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NDYiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyODciLCJkZXN0aW5hdGlvbklEIjoiMTg4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTg0NyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI4NSIsImRlc3RpbmF0aW9uSUQiOiIxODgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODQ4IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjgyIiwiZGVzdGluYXRpb25JRCI6IjE4OCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NDkiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNzkiLCJkZXN0aW5hdGlvbklEIjoiMTg4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTg1MCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI3NiIsImRlc3RpbmF0aW9uSUQiOiIxODgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODUxIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTg4IiwiZGVzdGluYXRpb25JRCI6IjE4NSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NTIiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxODUiLCJkZXN0aW5hdGlvbklEIjoiMTg2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTg1MyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjE4NiIsImRlc3RpbmF0aW9uSUQiOiIxODciLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODU0IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjAzIiwiZGVzdGluYXRpb25JRCI6IjI5MiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjIwM18xNTQyXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn0se1wiaW50ZXJhY3Rpb25cIjpcIjIwM18xNTQwXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiJPUiJ9LHsiaWQiOiI5ODU1IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjIzIiwiZGVzdGluYXRpb25JRCI6IjI5MyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjIyM18xNjU5XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn0se1wiaW50ZXJhY3Rpb25cIjpcIjIyM18xNjU3XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiJPUiJ9LHsiaWQiOiI5ODU2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjQwIiwiZGVzdGluYXRpb25JRCI6IjI5NCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI0MF8xNzY2XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn0se1wiaW50ZXJhY3Rpb25cIjpcIjI0MF8xNzY0XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiJPUiJ9LHsiaWQiOiI5ODU3IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjczIiwiZGVzdGluYXRpb25JRCI6IjI5NSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI3M18xOTY4XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn0se1wiaW50ZXJhY3Rpb25cIjpcIjI3M18xOTY2XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiJPUiJ9LHsiaWQiOiI5ODU4IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjkwIiwiZGVzdGluYXRpb25JRCI6IjI5NiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI5MF8yMDc0XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn0se1wiaW50ZXJhY3Rpb25cIjpcIjI5MF8yMDcyXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiJPUiJ9LHsiaWQiOiI5ODU5IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjkwIiwiZGVzdGluYXRpb25JRCI6IjE4OCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NjAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNzMiLCJkZXN0aW5hdGlvbklEIjoiMTg4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTg2MSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI0MCIsImRlc3RpbmF0aW9uSUQiOiIxODgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODYyIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjIzIiwiZGVzdGluYXRpb25JRCI6IjE4OCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NjMiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMDMiLCJkZXN0aW5hdGlvbklEIjoiMTg4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTg2NCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjE4OSIsImRlc3RpbmF0aW9uSUQiOiIxODgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9XSwiY2xvc2VfdXJsIjoiIyIsInJlZGlyZWN0aW9ucyI6W3siaWQiOiI3IiwiZm9ybUlEIjoiOSIsImNvbmRpdGlvbnMiOiJbXSIsImNvbmRpdGlvbnNPcGVyYXRvciI6IiIsInVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tLyJ9LHsiaWQiOiI4IiwiZm9ybUlEIjoiOSIsImNvbmRpdGlvbnMiOiJbXSIsImNvbmRpdGlvbnNPcGVyYXRvciI6IiIsInVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tLyJ9LHsiaWQiOiI5IiwiZm9ybUlEIjoiOSIsImNvbmRpdGlvbnMiOiJbXSIsImNvbmRpdGlvbnNPcGVyYXRvciI6IiIsInVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tLyJ9LHsiaWQiOiIxMCIsImZvcm1JRCI6IjkiLCJjb25kaXRpb25zIjoiW10iLCJjb25kaXRpb25zT3BlcmF0b3IiOiIiLCJ1cmwiOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS8ifSx7ImlkIjoiMTEiLCJmb3JtSUQiOiI5IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn0seyJpZCI6IjEyIiwiZm9ybUlEIjoiOSIsImNvbmRpdGlvbnMiOiJbXSIsImNvbmRpdGlvbnNPcGVyYXRvciI6IiIsInVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tLyJ9XSwidXNlUmVkaXJlY3Rpb25Db25kaXRpb25zIjoiMCIsInVzZVBkZiI6MSwidHh0X3llcyI6IlllcyIsInR4dF9ubyI6Ik5vIiwidHh0X2xhc3RCdG4iOiJTdWJtaXQiLCJ0eHRfYnRuU3RlcCI6Ik5leHQgIiwiZGF0ZUZvcm1hdCI6ImQgTU0geXl5eSIsImRhdGVQaWNrZXJMYW5ndWFnZSI6IiIsInRob3VzYW5kc1NlcGFyYXRvciI6IiIsImRlY2ltYWxzU2VwYXJhdG9yIjoiLiIsIm1pbGxpb25TZXBhcmF0b3IiOiIiLCJiaWxsaW9uc1NlcGFyYXRvciI6IiIsInN1bW1hcnlfaGlkZVF0IjoiMSIsInN1bW1hcnlfaGlkZVplcm8iOiIxIiwic3VtbWFyeV9oaWRlWmVyb1F0IjoiMSIsInN1bW1hcnlfaGlkZVByaWNlcyI6IjEiLCJzdW1tYXJ5X2hpZGVaZXJvRGVjaW1hbHMiOiIxIiwiZ3JvdXBBdXRvQ2xpY2siOiIxIiwiZmlsZXNVcGxvYWRfdGV4dCI6IkRyb3AgZmlsZXMgaGVyZSB0byB1cGxvYWQiLCJmaWxlc1VwbG9hZFNpemVfdGV4dCI6IkZpbGUgaXMgdG9vIGJpZyAobWF4IHNpemU6IHt7bWF4RmlsZXNpemV9fU1CKSIsImZpbGVzVXBsb2FkVHlwZV90ZXh0IjoiSW52YWxpZCBmaWxlIHR5cGUiLCJmaWxlc1VwbG9hZExpbWl0X3RleHQiOiJZb3UgY2FuIG5vdCB1cGxvYWQgYW55IG1vcmUgZmlsZXMiLCJzZW5kQ29udGFjdEFTQVAiOiIxIiwic2hvd1RvdGFsQm90dG9tIjoiMCIsInN0cmlwZVB1YktleSI6IiIsInNjcm9sbFRvcE1hcmdpbiI6IjAiLCJzY3JvbGxUb3BNYXJnaW5Nb2JpbGUiOiIwIiwicmVkaXJlY3Rpb25EZWxheSI6IjAiLCJnbWFwX2tleSI6IiIsInR4dERpc3RhbmNlRXJyb3IiOiJDYWxjdWxhdGluZyB0aGUgZGlzdGFuY2UgY291bGQgbm90IGJlIHBlcmZvcm1lZCwgcGxlYXNlIHZlcmlmeSB0aGUgaW5wdXQgYWRkcmVzc2VzIiwiY2FwdGNoYVVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWNvbnRlbnQvcGx1Z2lucy9XUF9Fc3RpbWF0aW9uX0Zvcm0vaW5jbHVkZXMvY2FwdGNoYS9nZXRfY2FwdGNoYS5waHAiLCJzdW1tYXJ5X25vRGVjaW1hbHMiOiIxIiwic2Nyb2xsVG9wUGFnZSI6IjAiLCJkaXNhYmxlRHJvcGRvd25zIjoiMSIsImltZ0ljb25TdHlsZSI6Inpvb20iLCJzdW1tYXJ5X2hpZGVGaW5hbFN0ZXAiOiIxIiwidGltZU1vZGVBTSI6IjAiLCJlbmFibGVTaGluZUZ4QnRuIjoiMSIsInN1bW1hcnlfc2hvd0FsbFByaWNlc0VtYWlsIjoiMCIsImltZ1RpdGxlc1N0eWxlIjoiIiwibGFzdFMiOiIxNjY1NDc3ODgzOTkzIiwiZW1wdHlXb29DYXJ0IjoiMCIsInNlbmRVcmxWYXJpYWJsZXMiOiIwIiwic2VuZFZhcmlhYmxlc01ldGhvZCI6IiIsImVuYWJsZVphcGllciI6IjAiLCJ6YXBpZXJXZWJIb29rIjoiIiwic3VtbWFyeV9zaG93RGVzY3JpcHRpb25zIjoiMSIsImltZ1ByZXZpZXciOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS93cC1jb250ZW50L3BsdWdpbnMvV1BfRXN0aW1hdGlvbl9Gb3JtL2Fzc2V0cy9pbWcvZmlsZS0zLTEyOC5wbmciLCJwcm9ncmVzc0JhclByaWNlVHlwZSI6IiIsInJhem9ycGF5X3B1Ymxpc2hLZXkiOiIiLCJyYXpvcnBheV9sb2dvSW1nIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vd3AtY29udGVudC91cGxvYWRzLzIwMjIvMTAvY3JlZGl0Q2FyZEAyeC5wbmciLCJ2YXJpYWJsZXMiOltdLCJ1c2VFbWFpbFZlcmlmaWNhdGlvbiI6IjAiLCJ0eHRfZW1haWxBY3RpdmF0aW9uQ29kZSI6IkZpbGwgeW91ciB2ZXJpZmlhdGlvbiBjb2RlIGhlcmUiLCJ0eHRfZW1haWxBY3RpdmF0aW9uSW5mbyI6IkEgdW5pcXVlIHZlcmlmaWNhdGlvbiBjb2RlIGhhcyBqdXN0IGJlZW4gc2VudCB0byB5b3UgYnkgZW1haWwsIHBsZWFzZSBjb3B5IGl0IGluIHRoZSBmaWVsZCBiZWxvdyB0byB2YWxpZGF0ZSB5b3VyIGVtYWlsIGFkZHJlc3MuIiwidXNlQ2FwdGNoYSI6IjAiLCJyZWNhcHRjaGEzS2V5IjoiIiwiZGlzdGFuY2VzTW9kZSI6InJvdXRlIiwiZW5hYmxlQ3VzdG9tZXJBY2NvdW50IjoiMCIsInR4dEN1c3RvbWVyc0RhdGFGb3Jnb3RQYXNzU2VudCI6IiIsInR4dEN1c3RvbWVyc0RhdGFGb3Jnb3RQYXNzTGluayI6IiIsImVtYWlsQ3VzdG9tZXJMaW5rcyI6IjEiLCJlbmFibGVQZGZEb3dubG9hZCI6IjEiLCJ1c2VTaWduYXR1cmUiOiIwIiwidXNlVkFUIjoiMCIsInZhdEFtb3VudCI6IjIwIiwidmF0TGFiZWwiOiJWQVQiLCJhdXRvY2xvc2VEYXRlcGlja2VyIjoiMCIsImZsb2F0U3VtbWFyeV9zaG93SW5mbyI6IjEiLCJoaWRlRmluYWxidG4iOiIwIiwiY2FydFBhZ2UiOiIiLCJkaXNhYmxlU2Nyb2xsIjoiMCJ9XQ==" defer></script>
<script data-optimized="1" id="lfb_frontend-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/5c752d5e3cc9177fc9f2089b272f6953.js?ver=e2f1b" defer data-deferred="1"></script>
<script id="wc-cashfree-checkout-js-js" defer data-deferred="1" data-type="lazy" data-src="https://sdk.cashfree.com/js/v3/cashfree.js?ver=4.8.1"></script>
<script data-optimized="1" id="wc-cashfree-checkout-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/5f4daa15f48fb910879c5b1559eb3ddf.js?ver=39a39" defer data-deferred="1"></script>
<script data-optimized="1" id="swv-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/5c4746a16ccf2a303e2c2c557c3c7f76.js?ver=9d723"></script>
<script id="contact-form-7-js-translations" src="data:text/javascript;base64,KGZ1bmN0aW9uKGRvbWFpbix0cmFuc2xhdGlvbnMpe3ZhciBsb2NhbGVEYXRhPXRyYW5zbGF0aW9ucy5sb2NhbGVfZGF0YVtkb21haW5dfHx0cmFuc2xhdGlvbnMubG9jYWxlX2RhdGEubWVzc2FnZXM7bG9jYWxlRGF0YVsiIl0uZG9tYWluPWRvbWFpbjt3cC5pMThuLnNldExvY2FsZURhdGEobG9jYWxlRGF0YSxkb21haW4pfSkoImNvbnRhY3QtZm9ybS03Iix7InRyYW5zbGF0aW9uLXJldmlzaW9uLWRhdGUiOiIyMDI2LTA1LTE1IDA3OjI1OjA5KzAwMDAiLCJnZW5lcmF0b3IiOiJHbG90UHJlc3NcLzQuMC4zIiwiZG9tYWluIjoibWVzc2FnZXMiLCJsb2NhbGVfZGF0YSI6eyJtZXNzYWdlcyI6eyIiOnsiZG9tYWluIjoibWVzc2FnZXMiLCJwbHVyYWwtZm9ybXMiOiJucGx1cmFscz0yOyBwbHVyYWw9biAhPSAxOyIsImxhbmciOiJpdCJ9LCJUaGlzIGNvbnRhY3QgZm9ybSBpcyBwbGFjZWQgaW4gdGhlIHdyb25nIHBsYWNlLiI6WyJRdWVzdG8gbW9kdWxvIGRpIGNvbnRhdHRvIFx1MDBlOCBwb3NpemlvbmF0byBuZWwgcG9zdG8gc2JhZ2xpYXRvLiJdLCJFcnJvcjoiOlsiRXJyb3JlOiJdfX0sImNvbW1lbnQiOnsicmVmZXJlbmNlIjoiaW5jbHVkZXNcL2pzXC9pbmRleC5qcyJ9fSk=" defer></script>
<script id="contact-form-7-js-before" src="data:text/javascript;base64,dmFyIHdwY2Y3PXsiYXBpIjp7InJvb3QiOiJodHRwczpcL1wvd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tXC9pdFwvd3AtanNvblwvIiwibmFtZXNwYWNlIjoiY29udGFjdC1mb3JtLTdcL3YxIn0sImNhY2hlZCI6MX0=" defer></script>
<script data-optimized="1" id="contact-form-7-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/cd0cd797ad2fba059531badb3e355fa3.js?ver=00ef2"></script>
<script data-optimized="1" id="nbcpf-intlTelInput-script-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/330de25c30a33ebaf65f95c4ad2085f1.js?ver=4f662"></script>
<script id="nbcpf-countryFlag-script-js-extra" src="data:text/javascript;base64,dmFyIG5iY3BmPXsiYWpheHVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWFkbWluL2FkbWluLWFqYXgucGhwIn0=" defer></script>
<script data-optimized="1" id="nbcpf-countryFlag-script-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/993b5808baa02386ce86789f7da94679.js?ver=2db17"></script>
<script id="nbcpf-countryFlag-script-js-after" src="data:text/javascript;base64,KGZ1bmN0aW9uKCQpeyQoZnVuY3Rpb24oKXskKCIud3BjZjctY291bnRyeXRleHQiKS5jb3VudHJ5U2VsZWN0KHt9KTskKCIud3BjZjctcGhvbmV0ZXh0IikuaW50bFRlbElucHV0KHthdXRvSGlkZURpYWxDb2RlOiEwLGF1dG9QbGFjZWhvbGRlcjohMCxuYXRpb25hbE1vZGU6ITEsc2VwYXJhdGVEaWFsQ29kZTohMCxoaWRkZW5JbnB1dDoiZnVsbF9udW1iZXIiLH0pOyQoIi53cGNmNy1waG9uZXRleHQiKS5lYWNoKGZ1bmN0aW9uKCl7dmFyIGhpZGRlbklucHV0PSQodGhpcykuYXR0cignbmFtZScpO3ZhciBkaWFsX2NvZGU9JCh0aGlzKS5zaWJsaW5ncygiLmZsYWctY29udGFpbmVyIikuZmluZCgiLnNlbGVjdGVkLWZsYWcgLnNlbGVjdGVkLWRpYWwtY29kZSIpLnRleHQoKTskKCJpbnB1dFtuYW1lPSIraGlkZGVuSW5wdXQrIi1jb3VudHJ5LWNvZGVdIikudmFsKGRpYWxfY29kZSl9KTskKCIud3BjZjctcGhvbmV0ZXh0Iikub24oImNvdW50cnljaGFuZ2UiLGZ1bmN0aW9uKCl7dmFyIGhpZGRlbklucHV0PSQodGhpcykuYXR0cigibmFtZSIpO3ZhciBkaWFsX2NvZGU9JCh0aGlzKS5zaWJsaW5ncygiLmZsYWctY29udGFpbmVyIikuZmluZCgiLnNlbGVjdGVkLWZsYWcgLnNlbGVjdGVkLWRpYWwtY29kZSIpLnRleHQoKTskKCJpbnB1dFtuYW1lPSIraGlkZGVuSW5wdXQrIi1jb3VudHJ5LWNvZGVdIikudmFsKGRpYWxfY29kZSl9KTt2YXIgaXNNb2JpbGU9L0FuZHJvaWQuK01vYmlsZXx3ZWJPU3xpUGhvbmV8aVBvZHxCbGFja0JlcnJ5fElFTW9iaWxlfE9wZXJhIE1pbmkvaS50ZXN0KG5hdmlnYXRvci51c2VyQWdlbnQpOyQoIi53cGNmNy1waG9uZXRleHQiKS5vbigia2V5dXAiLGZ1bmN0aW9uKCl7dmFyIGRpYWxfY29kZT0kKHRoaXMpLnNpYmxpbmdzKCIuZmxhZy1jb250YWluZXIiKS5maW5kKCIuc2VsZWN0ZWQtZmxhZyAuc2VsZWN0ZWQtZGlhbC1jb2RlIikudGV4dCgpO3ZhciB2YWx1ZT0kKHRoaXMpLnZhbCgpO2lmKHZhbHVlPT0iKyIpCiQodGhpcykudmFsKCIiKTtlbHNlIGlmKHZhbHVlLmluZGV4T2YoIisiKT09Ii0xIikKJCh0aGlzKS52YWwoZGlhbF9jb2RlK3ZhbHVlKTtlbHNlIGlmKHZhbHVlLmluZGV4T2YoIisiKT4wKQokKHRoaXMpLnZhbChkaWFsX2NvZGUrdmFsdWUuc3Vic3RyaW5nKGRpYWxfY29kZS5sZW5ndGgpKTt9KTskKCIud3BjZjctY291bnRyeXRleHQiKS5vbigia2V5dXAiLGZ1bmN0aW9uKCl7dmFyIGNvdW50cnlfbmFtZT0kKHRoaXMpLnNpYmxpbmdzKCIuZmxhZy1kcm9wZG93biIpLmZpbmQoIi5jb3VudHJ5LWxpc3QgbGkuYWN0aXZlIHNwYW4uY291bnRyeS1uYW1lIikudGV4dCgpO2lmKGNvdW50cnlfbmFtZT09IiIpCnZhciBjb3VudHJ5X25hbWU9JCh0aGlzKS5zaWJsaW5ncygiLmZsYWctZHJvcGRvd24iKS5maW5kKCIuY291bnRyeS1saXN0IGxpLmhpZ2hsaWdodCBzcGFuLmNvdW50cnktbmFtZSIpLnRleHQoKTt2YXIgdmFsdWU9JCh0aGlzKS52YWwoKTskKHRoaXMpLnZhbChjb3VudHJ5X25hbWUrdmFsdWUuc3Vic3RyaW5nKGNvdW50cnlfbmFtZS5sZW5ndGgpKX0pfSl9KShqUXVlcnkp" defer></script>
<script id="eafl-public-js-extra" src="data:text/javascript;base64,dmFyIGVhZmxfcHVibGljPXsiaG9tZV91cmwiOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS9pdC8iLCJhamF4X3VybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWFkbWluL2FkbWluLWFqYXgucGhwIiwibm9uY2UiOiI1NTA0NTc5ZmNiIn0=" defer></script>
<script data-optimized="1" id="eafl-public-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/72af9615f1bafb83a19f2c55bcb11008.js?ver=19bb9" defer data-deferred="1"></script>
<script data-optimized="1" id="underscore-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/656105ac6520e78e77d412aa1c9fdf5b.js?ver=0c53b" defer data-deferred="1"></script>
<script id="paypalplus-woocommerce-front-js-extra" src="data:text/javascript;base64,dmFyIHBwcEZyb250RGF0YUNvbGxlY3Rpb249eyJwYWdlaW5mbyI6eyJpc0NoZWNrb3V0IjohMSwiaXNDaGVja291dFBheVBhZ2UiOiExfSwiaXNDb25mbGljdFZlcnNpb24iOiIxIn0=" defer></script>
<script data-optimized="1" id="paypalplus-woocommerce-front-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/4d1068c96f7149addfc7f137ec517523.js?ver=85722" defer data-deferred="1"></script>
<script data-wp-strategy="async" id="cloudflare-turnstile-js" src="https://challenges.cloudflare.com/turnstile/v0/api.js"></script>
<script id="cloudflare-turnstile-js-after">
document.addEventListener( 'wpcf7submit', e => turnstile.reset() );
//# sourceURL=cloudflare-turnstile-js-after
</script>
<script id="daim-track-internal-links-js-before" src="data:text/javascript;base64,d2luZG93LkRBSU1fUEFSQU1FVEVSUz17YWpheF91cmw6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWFkbWluL2FkbWluLWFqYXgucGhwIixub25jZToiMjJlNzk3YmQ3YyJ9" defer></script>
<script data-optimized="1" id="daim-track-internal-links-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/6d01a6d028937b48180b1df8c62a5866.js?ver=90e80" defer data-deferred="1"></script>
<script data-optimized="1" data-wp-strategy="async" fetchpriority="low" id="comment-reply-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/30a5403410fa872b31989258af99a153.js?ver=1837e" defer data-deferred="1"></script>
<script id="cart-widget-js-extra" src="data:text/javascript;base64,dmFyIGFjdGlvbnM9eyJjdXJyZW50X2xhbmd1YWdlIjoiaXQiLCJmb3JjZV9yZXNldCI6IjAifQ==" defer></script>
<script data-optimized="1" data-wp-strategy="defer" defer id="cart-widget-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/b32ffb8fe1ef1b215581be0b17529bf4.js?ver=188b1"></script>
<script data-optimized="1" id="page-links-to-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/931848cb939a1246e892f804bed5222f.js?ver=abe0c" defer data-deferred="1"></script>
<script data-optimized="1" id="sourcebuster-js-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/33af9a69764a66dda4604a4bf93d71c5.js?ver=780b6" defer data-deferred="1"></script>
<script id="wc-order-attribution-js-extra" src="data:text/javascript;base64,dmFyIHdjX29yZGVyX2F0dHJpYnV0aW9uPXsicGFyYW1zIjp7ImxpZmV0aW1lIjoxLjBlLTUsInNlc3Npb24iOjMwLCJiYXNlNjQiOiExLCJhamF4dXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vd3AtYWRtaW4vYWRtaW4tYWpheC5waHAiLCJwcmVmaXgiOiJ3Y19vcmRlcl9hdHRyaWJ1dGlvbl8iLCJhbGxvd1RyYWNraW5nIjohMH0sImZpZWxkcyI6eyJzb3VyY2VfdHlwZSI6ImN1cnJlbnQudHlwIiwicmVmZXJyZXIiOiJjdXJyZW50X2FkZC5yZiIsInV0bV9jYW1wYWlnbiI6ImN1cnJlbnQuY21wIiwidXRtX3NvdXJjZSI6ImN1cnJlbnQuc3JjIiwidXRtX21lZGl1bSI6ImN1cnJlbnQubWRtIiwidXRtX2NvbnRlbnQiOiJjdXJyZW50LmNudCIsInV0bV9pZCI6ImN1cnJlbnQuaWQiLCJ1dG1fdGVybSI6ImN1cnJlbnQudHJtIiwidXRtX3NvdXJjZV9wbGF0Zm9ybSI6ImN1cnJlbnQucGx0IiwidXRtX2NyZWF0aXZlX2Zvcm1hdCI6ImN1cnJlbnQuZm10IiwidXRtX21hcmtldGluZ190YWN0aWMiOiJjdXJyZW50LnRjdCIsInNlc3Npb25fZW50cnkiOiJjdXJyZW50X2FkZC5lcCIsInNlc3Npb25fc3RhcnRfdGltZSI6ImN1cnJlbnRfYWRkLmZkIiwic2Vzc2lvbl9wYWdlcyI6InNlc3Npb24ucGdzIiwic2Vzc2lvbl9jb3VudCI6InVkYXRhLnZzdCIsInVzZXJfYWdlbnQiOiJ1ZGF0YS51YWcifX0=" defer></script>
<script id="wc-order-attribution-js" src="https://www.lowcostwebagency.com/wp-content/plugins/woocommerce/assets/js/frontend/order-attribution.min.js?ver=11.2.1" defer data-deferred="1"></script>
<script data-optimized="1" id="backbone-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/4f41f71788dbefe3fb7cf9f6b9d59b7c.js?ver=2e6ab" defer data-deferred="1"></script>
<script data-optimized="1" id="backbone.localStorage-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/66d95051c677839d60ceca75f6e17adb.js?ver=54627" defer data-deferred="1"></script>
<script data-optimized="1" id="wc-predictive-search-autocomplete-script-js" defer data-deferred="1" data-type="lazy" data-src="https://www.lowcostwebagency.com/wp-content/litespeed/js/2d67b5bd7ea86fa8800d159f92f51b16.js?ver=e81f0"></script>
<script data-optimized="1" id="wc-predictive-search-backbone-js" defer data-deferred="1" data-type="lazy" data-src="https://www.lowcostwebagency.com/wp-content/litespeed/js/28ceb0cade6f6a1c3c502d50abe6fcbb.js?ver=66e0a"></script>
<script id="wc-predictive-search-popup-backbone-js-extra" defer data-type="lazy" data-src="data:text/javascript;base64,dmFyIHdjX3BzX3ZhcnM9eyJtaW5DaGFycyI6IjEiLCJkZWxheSI6IjYwMCIsImNhY2hlX3RpbWVvdXQiOiIxIiwiaXNfZGVidWciOiJ5ZXMiLCJsZWdhY3lfYXBpX3VybCI6Ii8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL2l0L3djLWFwaS93Y19wc19sZWdhY3lfYXBpLz9hY3Rpb249Z2V0X3Jlc3VsdF9wb3B1cCIsInNlYXJjaF9wYWdlX3VybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL2l0L3JpY2VyY2EvIiwicGVybWFsaW5rX3N0cnVjdHVyZSI6Ii8lcG9zdG5hbWUlLyIsImlzX3J0bCI6IiJ9"></script>
<script data-optimized="1" id="wc-predictive-search-popup-backbone-js" defer data-deferred="1" data-type="lazy" data-src="https://www.lowcostwebagency.com/wp-content/litespeed/js/d12c9de4ced65974cbd788b88f8c2d8b.js?ver=11c6d"></script>
<script id="quick-view-popup-script-js-extra" src="data:text/javascript;base64,dmFyIHdjX3F2X3ZhcnM9eyJhamF4X3VybCI6Ii93cC1hZG1pbi9hZG1pbi1hamF4LnBocCJ9" defer></script>
<script data-optimized="1" id="quick-view-popup-script-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/f12aca297f2405c74d6f21c8f03a6504.js?ver=65ef2" defer data-deferred="1"></script>
<script id="wpcf7cf-scripts-js-extra" src="data:text/javascript;base64,dmFyIHdwY2Y3Y2ZfZ2xvYmFsX3NldHRpbmdzPXsiYWpheHVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWFkbWluL2FkbWluLWFqYXgucGhwIn0=" defer></script>
<script data-optimized="1" id="wpcf7cf-scripts-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/f425293af6a8f84ad6e449675dc73a3b.js?ver=a6647" defer data-deferred="1"></script>
<script data-cfasync="false" id="cfturnstile-js-before">
(function(w,d){var q=w.cfturnstileQueue=w.cfturnstileQueue||[];if(w.cfturnstileRender)return;var ready=false,hooked=false,ticks=0,timer=null;var cbs=["callback","error-callback","expired-callback","timeout-callback","unsupported-callback","before-interactive-callback","after-interactive-callback"];function opts(e){var p={};for(var i=0;i<cbs.length;i++){(function(n){var v=e.getAttribute("data-"+n);if(!v)return;p[n]=function(){var f=w[v];if(typeof f==="function")return f.apply(w,arguments);};})(cbs[i]);}return p;}w.cfturnstileOpts=function(e){if(typeof e==="string")e=d.querySelector(e);return e&&e.getAttribute?opts(e):{};};function one(id){var n="cf-turnstile"+id,e=d.getElementById(n);if(e&&e.cfturnstileQueued){e=null;var l=d.querySelectorAll(".cf-turnstile");for(var i=0;i<l.length;i++){if(l[i].id===n&&!l[i].cfturnstileQueued){e=l[i];break;}}}if(!e)return false;if(!e.firstElementChild){try{w.turnstile.render(e,opts(e));}catch(_){return false;}}e.cfturnstileQueued=1;return true;}function drain(){if(!ready)return;for(var i=q.length-1;i>=0;i--){if(one(q[i]))q.splice(i,1);}if(q.length&&!hooked&&d.readyState==="loading"){hooked=true;d.addEventListener("DOMContentLoaded",function(){hooked=false;drain();});}}function watch(){timer=null;if(!q.length)return;if(!ready&&w.turnstile&&typeof w.turnstile.render==="function")ready=true;drain();if(q.length&&++ticks<170)timer=setTimeout(watch,ticks<20?100:2000);}w.cfturnstileRender=function(){drain();if(q.length&&!timer)timer=setTimeout(watch,100);};w.cfturnstileOnload=function(){ready=true;w.cfturnstileRender();};w.cfturnstileRender();})(window,document);
(function(w,d){if(w.cfturnstileRefresh)return;w.cfturnstileRefresh=1;var F="input[name=cf-turnstile-response]",S="form.checkout, form.woocommerce-checkout, form.wc-block-checkout__form",u=false;function go(){u=true;}w.addEventListener("pagehide",go);w.addEventListener("beforeunload",go);d.addEventListener("submit",function(e){var f=e.target,s=[];if(!f||!f.querySelectorAll)return;try{if(S&&f.matches&&f.matches(S))return;}catch(_){}f.querySelectorAll(".cf-turnstile").forEach(function(el){var i=el.querySelector(F);if(i&&i.value)s.push([el,i.value]);});if(!s.length)return;setTimeout(function(){if(u||!w.turnstile||d.querySelector("#wfls-prompt-overlay,#wfls-token,#fls_2fa_form,.fls_2fs"))return;s.forEach(function(x){var i=x[0].querySelector(F);if(i&&i.value===x[1]){try{w.turnstile.reset(x[0]);}catch(_){}}});},2000);},true);})(window,document);
//# sourceURL=cfturnstile-js-before
</script>
<script id="cfturnstile-js" src="https://challenges.cloudflare.com/turnstile/v0/api.js?render=explicit&onload=cfturnstileOnload"></script>
<script data-cfasync="false" id="cfturnstile-js-after">
function turnstileCF7Callback() {
document.querySelectorAll('.wpcf7-submit').forEach(function(el) {
el.style.pointerEvents = 'auto';
el.style.opacity = '1';
});
}
//# sourceURL=cfturnstile-js-after
</script>
<script id="cfturnstile-js-js" src="https://www.lowcostwebagency.com/wp-content/plugins/simple-cloudflare-turnstile/js/disable-submit.js?ver=5.3"></script>
<script data-optimized="1" id="react-jsx-runtime-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/09d93c2c5be72e7a3fed7907b0c459ae.js?ver=25c38" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-deprecated-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/a572d0e79161dad01d3707f87f7ba723.js?ver=37a1b" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-dom-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/98ccef882ba8a3be5661723ab8b7dd51.js?ver=3392f" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-is-shallow-equal-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/0bd3a4bc3720e0ec30ebad3d32827068.js?ver=a184e" defer data-deferred="1"></script>
<script id="wp-keycodes-js-translations" src="data:text/javascript;base64,KGZ1bmN0aW9uKGRvbWFpbix0cmFuc2xhdGlvbnMpe3ZhciBsb2NhbGVEYXRhPXRyYW5zbGF0aW9ucy5sb2NhbGVfZGF0YVtkb21haW5dfHx0cmFuc2xhdGlvbnMubG9jYWxlX2RhdGEubWVzc2FnZXM7bG9jYWxlRGF0YVsiIl0uZG9tYWluPWRvbWFpbjt3cC5pMThuLnNldExvY2FsZURhdGEobG9jYWxlRGF0YSxkb21haW4pfSkoImRlZmF1bHQiLHsidHJhbnNsYXRpb24tcmV2aXNpb24tZGF0ZSI6IjIwMjYtMDQtMDIgMTc6MTE6MjgrMDAwMCIsImdlbmVyYXRvciI6Ikdsb3RQcmVzc1wvNC4wLjMiLCJkb21haW4iOiJtZXNzYWdlcyIsImxvY2FsZV9kYXRhIjp7Im1lc3NhZ2VzIjp7IiI6eyJkb21haW4iOiJtZXNzYWdlcyIsInBsdXJhbC1mb3JtcyI6Im5wbHVyYWxzPTI7IHBsdXJhbD1uICE9IDE7IiwibGFuZyI6Iml0In0sIkNvbW1hIjpbIlZpcmdvbGEiXSwiUGVyaW9kIjpbIlB1bnRvIl0sIkJhY2t0aWNrIjpbIkFjY2VudG8gZ3JhdmUiXSwiVGlsZGUiOlsiVGlsZGUiXX19LCJjb21tZW50Ijp7InJlZmVyZW5jZSI6IndwLWluY2x1ZGVzXC9qc1wvZGlzdFwva2V5Y29kZXMuanMifX0p" defer></script>
<script data-optimized="1" id="wp-keycodes-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/2927d2da040f2068c3cbd993b0f55145.js?ver=655a1" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-priority-queue-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/51bb0191b650ef22716f1eaf4c8554e7.js?ver=14b9d" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-private-apis-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/495f9a7e99b9c301e8e31f1a5dc4d250.js?ver=71beb" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-undo-manager-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/d0df5071163c01073456e9b251e45001.js?ver=4514b" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-compose-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/81117f563da4dfc95496dba8b863bca7.js?ver=36fc0" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-redux-routine-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/9e9c3f9d09f508e1cac1ecc7a68a34b7.js?ver=54a51" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-data-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/415b285dcba0872c0ec639161c17c80a.js?ver=ced99" defer data-deferred="1"></script>
<script id="wp-data-js-after" src="data:text/javascript;base64,KGZ1bmN0aW9uKCl7dmFyIHVzZXJJZD0wO3ZhciBzdG9yYWdlS2V5PSJXUF9EQVRBX1VTRVJfIit1c2VySWQ7d3AuZGF0YS51c2Uod3AuZGF0YS5wbHVnaW5zLnBlcnNpc3RlbmNlLHtzdG9yYWdlS2V5OnN0b3JhZ2VLZXl9KX0pKCk=" defer></script>
<script id="cfturnstile-woo-js-js" src="https://www.lowcostwebagency.com/wp-content/plugins/simple-cloudflare-turnstile/js/integrations/woocommerce.js?ver=2.2"></script>
<script data-cfasync="false" id="cfturnstile-render-js-after">
(window.cfturnstileQueue=window.cfturnstileQueue||[]).push("-cf7-1050561614");if(window.cfturnstileRender)window.cfturnstileRender();
//# sourceURL=cfturnstile-render-js-after
</script>
<script data-optimized="1" id="gsap-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/fb56464d155d0d850b928f04635dbe45.js?ver=340a8" defer data-deferred="1"></script>
<script data-optimized="1" id="gsap-scroll-trigger-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/8a578a608a8a925086d309c93f3bc9f5.js?ver=862ad" defer data-deferred="1"></script>
<script data-optimized="1" id="awb-tabs-widget-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/ee29fb7c9a47d6c1e1f7be2d5a3c1f40.js?ver=f4c32" defer data-deferred="1"></script>
<script data-optimized="1" id="awb-vertical-menu-widget-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/07bd413d4338894ab9180be6356f7ac5.js?ver=683fd" defer data-deferred="1"></script>
<script data-optimized="1" id="cssua-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/c0c29014335ca5324de497cb5141ec7d.js?ver=5e56e" defer data-deferred="1"></script>
<script data-optimized="1" id="modernizr-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/3b045c0f957ec59627aa7d85ef01b2b3.js?ver=9171b" defer data-deferred="1"></script>
<script id="fusion-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkpTVmFycz17InZpc2liaWxpdHlfc21hbGwiOiI2NDAiLCJ2aXNpYmlsaXR5X21lZGl1bSI6IjEwMjQifQ==" defer></script>
<script data-optimized="1" id="fusion-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/1eed82425cbd4ccf118f66e1ce36750e.js?ver=86d3e" defer data-deferred="1"></script>
<script data-optimized="1" id="swiper-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/3ba1f9981e2239364bb394dfd7ba96cb.js?ver=50bb6" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-request-animation-frame-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/2329bdfa0b2709536e7fee09b0aae0a3.js?ver=69a97" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-easing-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/8f2687d7e18eb14d70271cadbad42166.js?ver=042c9" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-fitvids-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/16dacc24bf6d2661745b81e6fc260541.js?ver=15fc2" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-flexslider-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/364a2eb5d2c0c69c1698b6cf523065c2.js?ver=34ca4" defer data-deferred="1"></script>
<script id="jquery-lightbox-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkxpZ2h0Ym94VmlkZW9WYXJzPXsibGlnaHRib3hfdmlkZW9fd2lkdGgiOiIxMjgwIiwibGlnaHRib3hfdmlkZW9faGVpZ2h0IjoiNzIwIn0=" defer></script>
<script data-optimized="1" id="jquery-lightbox-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/12ed22fe016348b849b9978c5ff87793.js?ver=40104" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-mousewheel-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/6a1f843c9c785a2d996ae87226862921.js?ver=0850c" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-fade-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/da17fab4f6c9ef23e4430a9de3556a65.js?ver=33352" defer data-deferred="1"></script>
<script id="fusion-equal-heights-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkVxdWFsSGVpZ2h0VmFycz17ImNvbnRlbnRfYnJlYWtfcG9pbnQiOiI4MDAifQ==" defer></script>
<script data-optimized="1" id="fusion-equal-heights-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/03d955b96d3f3def89ce3c76d088727e.js?ver=7a5ce" defer data-deferred="1"></script>
<script data-optimized="1" id="fusion-parallax-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/e07bcd5d79541b80af6318dc68a3d6d8.js?ver=3fd9d" defer data-deferred="1"></script>
<script id="fusion-video-general-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvblZpZGVvR2VuZXJhbFZhcnM9eyJzdGF0dXNfdmltZW8iOiIwIiwic3RhdHVzX3l0IjoiMCJ9" defer></script>
<script data-optimized="1" id="fusion-video-general-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/61646f92dd9072f96d8be7b0509deb12.js?ver=3c4df" defer data-deferred="1"></script>
<script id="fusion-video-bg-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvblZpZGVvQmdWYXJzPXsic3RhdHVzX3ZpbWVvIjoiMCIsInN0YXR1c195dCI6IjAiLCJ0aXRsZSI6IkJhY2tncm91bmQgdmlkZW8ifQ==" defer></script>
<script data-optimized="1" id="fusion-video-bg-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/d7aba9106308a658d02b124c3e80c575.js?ver=b2d86" defer data-deferred="1"></script>
<script id="fusion-lightbox-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkxpZ2h0Ym94VmFycz17InN0YXR1c19saWdodGJveCI6IjEiLCJsaWdodGJveF9nYWxsZXJ5IjoiMSIsImxpZ2h0Ym94X3NraW4iOiJtZXRyby13aGl0ZSIsImxpZ2h0Ym94X3RpdGxlIjoiIiwibGlnaHRib3hfem9vbSI6IjEiLCJsaWdodGJveF9hcnJvd3MiOiIxIiwibGlnaHRib3hfc2xpZGVzaG93X3NwZWVkIjoiNTAwMCIsImxpZ2h0Ym94X2xvb3AiOiIwIiwibGlnaHRib3hfYXV0b3BsYXkiOiIiLCJsaWdodGJveF9vcGFjaXR5IjoiMC45NyIsImxpZ2h0Ym94X2Rlc2MiOiIiLCJsaWdodGJveF9zb2NpYWwiOiIxIiwibGlnaHRib3hfc29jaWFsX2xpbmtzIjp7ImZhY2Vib29rIjp7InNvdXJjZSI6Imh0dHBzOi8vd3d3LmZhY2Vib29rLmNvbS9zaGFyZXIucGhwP3U9e1VSTH0iLCJ0ZXh0IjoiU2hhcmUgb24gRmFjZWJvb2sifSwidHdpdHRlciI6eyJzb3VyY2UiOiJodHRwczovL3guY29tL2ludGVudC9wb3N0P3VybD17VVJMfSIsInRleHQiOiJTaGFyZSBvbiBYIn0sInJlZGRpdCI6eyJzb3VyY2UiOiJodHRwczovL3JlZGRpdC5jb20vc3VibWl0P3VybD17VVJMfSIsInRleHQiOiJTaGFyZSBvbiBSZWRkaXQifSwibGlua2VkaW4iOnsic291cmNlIjoiaHR0cHM6Ly93d3cubGlua2VkaW4uY29tL3NoYXJpbmcvc2hhcmUtb2Zmc2l0ZS8/dXJsPXtVUkx9IiwidGV4dCI6IlNoYXJlIG9uIExpbmtlZEluIn0sInR1bWJsciI6eyJzb3VyY2UiOiJodHRwczovL3d3dy50dW1ibHIuY29tL3NoYXJlL2xpbms/dXJsPXtVUkx9IiwidGV4dCI6IlNoYXJlIG9uIFR1bWJsciJ9LCJwaW50ZXJlc3QiOnsic291cmNlIjoiaHR0cHM6Ly9waW50ZXJlc3QuY29tL3Bpbi9jcmVhdGUvYnV0dG9uLz91cmw9e1VSTH0iLCJ0ZXh0IjoiU2hhcmUgb24gUGludGVyZXN0In19LCJsaWdodGJveF9kZWVwbGlua2luZyI6IjEiLCJsaWdodGJveF9wYXRoIjoiaG9yaXpvbnRhbCIsImxpZ2h0Ym94X3Bvc3RfaW1hZ2VzIjoiIiwibGlnaHRib3hfYW5pbWF0aW9uX3NwZWVkIjoiZmFzdCIsImwxMG4iOnsiY2xvc2UiOiJQcmVzcyBFc2MgdG8gY2xvc2UiLCJlbnRlckZ1bGxzY3JlZW4iOiJFbnRlciBGdWxsc2NyZWVuIChTaGlmdCtFbnRlcikiLCJleGl0RnVsbHNjcmVlbiI6IkV4aXQgRnVsbHNjcmVlbiAoU2hpZnQrRW50ZXIpIiwic2xpZGVTaG93IjoiU2xpZGVzaG93IiwibmV4dCI6Ik5leHQiLCJwcmV2aW91cyI6IlByZXZpb3VzIn19" defer></script>
<script data-optimized="1" id="fusion-lightbox-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/e05c6b1d06f825187c78b387915ad28d.js?ver=48219" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-sticky-kit-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/ab3b872e652a347008df3d19d35da2a5.js?ver=34afe" defer data-deferred="1"></script>
<script data-optimized="1" id="fusion-general-global-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/e2eb9de8358f959e1a2e711ba040ec86.js?ver=2ae7c" defer data-deferred="1"></script>
<script data-optimized="1" id="lazysizes-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/bf252b175017fbf40e1bd49a12cc38df.js?ver=9389e" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-woo-product-variations-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/6adb6e52684749ed6821450688ce6bf9.js?ver=91729" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-general-footer-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/38b622b0a7c1cc843f3175256787cee9.js?ver=7f4d4" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-quantity-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/ba8256d54aa719dc57693c04a591fe35.js?ver=52d1a" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-crossfade-images-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/0333df7e7dcecf98df78d292e6a00dc6.js?ver=134a0" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-select-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/eae4a86f42b893c891c99f72671a0bf6.js?ver=18e3e" defer data-deferred="1"></script>
<script id="avada-wpml-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhTGFuZ3VhZ2VWYXJzPXsibGFuZ3VhZ2VfZmxhZyI6Iml0In0=" defer></script>
<script data-optimized="1" id="avada-wpml-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/81d87e1916421000a4d0e256c77cd38e.js?ver=95348" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-contact-form-7-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/cba694cff2c7f4c72e7a2fdc693ca508.js?ver=8a835" defer data-deferred="1"></script>
<script id="avada-comments-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhQ29tbWVudFZhcnM9eyJ0aXRsZV9zdHlsZV90eXBlIjoic2luZ2xlIHNvbGlkIiwidGl0bGVfbWFyZ2luX3RvcCI6IjBweCIsInRpdGxlX21hcmdpbl9ib3R0b20iOiIzMHB4In0=" defer></script>
<script data-optimized="1" id="avada-comments-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/5f02be46bcc7d1ed62df84ed2e32fd5e.js?ver=73a10" defer data-deferred="1"></script>
<script data-optimized="1" id="fusion-alert-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/0bc6b9b681cfe56c98ac249b901f4430.js?ver=1206e" defer data-deferred="1"></script>
<script data-optimized="1" id="awb-background-slider-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/99a6608632ee6a03b2b2dde62f6c3dcf.js?ver=796b0" defer data-deferred="1"></script>
<script id="fusion-flexslider-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkZsZXhTbGlkZXJWYXJzPXsic3RhdHVzX3ZpbWVvIjoiIiwic2xpZGVzaG93X2F1dG9wbGF5IjoiMSIsInNsaWRlc2hvd19zcGVlZCI6IjcwMDAiLCJwYWdpbmF0aW9uX3ZpZGVvX3NsaWRlIjoiIiwic3RhdHVzX3l0IjoiIiwiZmxleF9zbW9vdGhIZWlnaHQiOiJmYWxzZSJ9" defer></script>
<script data-optimized="1" id="fusion-flexslider-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/3cb69f26d07794a81f20521aa1ebdb1e.js?ver=c5393" defer data-deferred="1"></script>
<script id="awb-carousel-js-extra" src="data:text/javascript;base64,dmFyIGF3YkNhcm91c2VsVmFycz17InJlbGF0ZWRfcG9zdHNfc3BlZWQiOiIyNTAwIiwiY2Fyb3VzZWxfc3BlZWQiOiIyMDAwIn0=" defer></script>
<script data-optimized="1" id="awb-carousel-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/676965e40d5fda12007e19f918aa9a4d.js?ver=f35dc" defer data-deferred="1"></script>
<script id="fusion-animations-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkFuaW1hdGlvbnNWYXJzPXsic3RhdHVzX2Nzc19hbmltYXRpb25zIjoiZGVza3RvcCJ9" defer></script>
<script data-optimized="1" id="fusion-animations-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/d11f745c9892989292540840a0d325d0.js?ver=65f91" defer data-deferred="1"></script>
<script id="fusion-container-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkNvbnRhaW5lclZhcnM9eyJjb250ZW50X2JyZWFrX3BvaW50IjoiODAwIiwiY29udGFpbmVyX2h1bmRyZWRfcGVyY2VudF9oZWlnaHRfbW9iaWxlIjoiMCIsImlzX3N0aWNreV9oZWFkZXJfdHJhbnNwYXJlbnQiOiIxIn0=" defer></script>
<script data-optimized="1" id="fusion-container-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/aabc9cbdb5c5b18874406f0c1b1d0e57.js?ver=03ca1" defer data-deferred="1"></script>
<script id="awb-widget-areas-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhU2lkZWJhcnNWYXJzPXsiaGVhZGVyX3Bvc2l0aW9uIjoidG9wIiwiaGVhZGVyX2xheW91dCI6InYyIiwiaGVhZGVyX3N0aWNreSI6IjEiLCJoZWFkZXJfc3RpY2t5X3R5cGUyX2xheW91dCI6Im1lbnVfb25seSIsInNpZGVfaGVhZGVyX2JyZWFrX3BvaW50IjoiMTA1MCIsImhlYWRlcl9zdGlja3lfdGFibGV0IjoiIiwic3RpY2t5X2hlYWRlcl9zaHJpbmthZ2UiOiIiLCJuYXZfaGVpZ2h0IjoiMTAzIiwic2lkZWJhcl9icmVha19wb2ludCI6IjgwMCJ9" defer></script>
<script data-optimized="1" id="awb-widget-areas-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/0411623fde2fddcf5c2c8f1937a4a36f.js?ver=35745" defer data-deferred="1"></script>
<script id="avada-fade-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhRmFkZVZhcnM9eyJwYWdlX3RpdGxlX2ZhZGluZyI6IjEiLCJoZWFkZXJfcG9zaXRpb24iOiJ0b3AifQ==" defer></script>
<script data-optimized="1" id="avada-fade-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/42e2c1fb2c6fc6ae36d97cfa800797e6.js?ver=5e953" defer data-deferred="1"></script>
<script id="avada-drop-down-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhU2VsZWN0VmFycz17ImF2YWRhX2Ryb3BfZG93biI6IjEifQ==" defer></script>
<script data-optimized="1" id="avada-drop-down-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/bbf28ff16d3c5aa1d1cb7a284de6a4d2.js?ver=7506f" defer data-deferred="1"></script>
<script id="avada-to-top-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhVG9Ub3BWYXJzPXsic3RhdHVzX3RvdG9wIjoiZGVza3RvcF9hbmRfbW9iaWxlIiwidG90b3BfcG9zaXRpb24iOiJyaWdodCIsInRvdG9wX3Njcm9sbF9kb3duX29ubHkiOiIxIn0=" defer></script>
<script data-optimized="1" id="avada-to-top-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/90be7be21880207d646a43c87dbe3d94.js?ver=2a31d" defer data-deferred="1"></script>
<script id="avada-header-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhSGVhZGVyVmFycz17ImhlYWRlcl9wb3NpdGlvbiI6InRvcCIsImhlYWRlcl9zdGlja3kiOiIxIiwiaGVhZGVyX3N0aWNreV90eXBlMl9sYXlvdXQiOiJtZW51X29ubHkiLCJoZWFkZXJfc3RpY2t5X3NoYWRvdyI6IjEiLCJzaWRlX2hlYWRlcl9icmVha19wb2ludCI6IjEwNTAiLCJoZWFkZXJfc3RpY2t5X21vYmlsZSI6IiIsImhlYWRlcl9zdGlja3lfdGFibGV0IjoiIiwibW9iaWxlX21lbnVfZGVzaWduIjoibW9kZXJuIiwic3RpY2t5X2hlYWRlcl9zaHJpbmthZ2UiOiIiLCJuYXZfaGVpZ2h0IjoiMTAzIiwibmF2X2hpZ2hsaWdodF9ib3JkZXIiOiIzIiwibmF2X2hpZ2hsaWdodF9zdHlsZSI6ImJhciIsImxvZ29fbWFyZ2luX3RvcCI6IjMxcHgiLCJsb2dvX21hcmdpbl9ib3R0b20iOiIzMXB4IiwibGF5b3V0X21vZGUiOiJ3aWRlIiwiaGVhZGVyX3BhZGRpbmdfdG9wIjoiMHB4IiwiaGVhZGVyX3BhZGRpbmdfYm90dG9tIjoiMHB4Iiwic2Nyb2xsX29mZnNldCI6ImZ1bGwifQ==" defer></script>
<script data-optimized="1" id="avada-header-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/c5451df4cc6dffacfdedfe1cf2b473c6.js?ver=4397a" defer data-deferred="1"></script>
<script id="avada-menu-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhTWVudVZhcnM9eyJzaXRlX2xheW91dCI6IndpZGUiLCJoZWFkZXJfcG9zaXRpb24iOiJ0b3AiLCJsb2dvX2FsaWdubWVudCI6ImxlZnQiLCJoZWFkZXJfc3RpY2t5IjoiMSIsImhlYWRlcl9zdGlja3lfbW9iaWxlIjoiIiwiaGVhZGVyX3N0aWNreV90YWJsZXQiOiIiLCJzaWRlX2hlYWRlcl9icmVha19wb2ludCI6IjEwNTAiLCJtZWdhbWVudV9iYXNlX3dpZHRoIjoiY3VzdG9tX3dpZHRoIiwibW9iaWxlX21lbnVfZGVzaWduIjoibW9kZXJuIiwiZHJvcGRvd25fZ290byI6IkdvIHRvLi4uIiwibW9iaWxlX25hdl9jYXJ0IjoiU2hvcHBpbmcgQ2FydCIsIm1vYmlsZV9zdWJtZW51X29wZW4iOiJPcGVuIHN1Ym1lbnUgb2YgJXMiLCJtb2JpbGVfc3VibWVudV9jbG9zZSI6IkNsb3NlIHN1Ym1lbnUgb2YgJXMiLCJzdWJtZW51X3NsaWRlb3V0IjoiMSJ9" defer></script>
<script data-optimized="1" id="avada-menu-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/fdfdd9f54eaace3448c35d60ad80612e.js?ver=0e41f" defer data-deferred="1"></script>
<script data-optimized="1" id="awb-scrollspy-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/09043d9a3a9126fb5372d29f6a1db65a.js?ver=6c4cc" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-scrollspy-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/aa9eca04f870fe01c6554bbf0749aacb.js?ver=151f2" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-woo-products-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/7bd4cd15d3071a8ad2bca6f0d998e487.js?ver=c2eee" defer data-deferred="1"></script>
<script id="avada-woocommerce-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhV29vQ29tbWVyY2VWYXJzPXsib3JkZXJfYWN0aW9ucyI6IkRldGFpbHMiLCJ0aXRsZV9zdHlsZV90eXBlIjoic2luZ2xlIHNvbGlkIiwid29vY29tbWVyY2Vfc2hvcF9wYWdlX2NvbHVtbnMiOiI0Iiwid29vY29tbWVyY2VfY2hlY2tvdXRfZXJyb3IiOiJOb3QgYWxsIGZpZWxkcyBoYXZlIGJlZW4gZmlsbGVkIGluIGNvcnJlY3RseS4iLCJyZWxhdGVkX3Byb2R1Y3RzX2hlYWRpbmdfc2l6ZSI6IjIiLCJhamF4dXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vd3AtYWRtaW4vYWRtaW4tYWpheC5waHAiLCJjYXJ0X25vbmNlIjoiZTcxYjQ3MjQxYiIsInF1aWNrX3ZpZXdfbm9uY2UiOiJlMDM5MjdlN2M5IiwicXVpY2tfdmlld19jbG9zZSI6IkNsb3NlIHByb2R1Y3QgcXVpY2sgdmlldyIsInF1aWNrX3ZpZXdfdGl0bGUiOiJUaXRsZSIsInNob3BfcGFnZV9iZ19jb2xvciI6IiNmZmZmZmYiLCJzaG9wX3BhZ2VfYmdfY29sb3JfbGlnaHRuZXNzIjoiMTAwIiwicG9zdF90aXRsZV9mb250X3NpemUiOiIyNiIsImFqYXhfdXBkYXRlX2NhcnRfdmFsdWVzIjoiMSIsIndvb19hamF4X2ZpbHRlcnMiOiJubyIsIndvb19hamF4X3NvcnRpbmciOiIwIiwid29vX2FqYXhfY2F0ZWdvcmllcyI6Im9mZiJ9" defer></script>
<script data-optimized="1" id="avada-woocommerce-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/7c22006f21326b46baf8c96d4fe176c2.js?ver=48ba2" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-woo-product-images-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/e5ff1bf4d86a6642def4423c37f399b7.js?ver=25363" defer data-deferred="1"></script>
<script id="fusion-responsive-typography-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvblR5cG9ncmFwaHlWYXJzPXsic2l0ZV93aWR0aCI6IjE0MDBweCIsInR5cG9ncmFwaHlfc2Vuc2l0aXZpdHkiOiIwLjU0IiwidHlwb2dyYXBoeV9mYWN0b3IiOiIxLjUwIiwiZWxlbWVudHMiOiJoMSwgaDIsIGgzLCBoNCwgaDUsIGg2In0=" defer></script>
<script data-optimized="1" id="fusion-responsive-typography-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/bc6178fd5c47ab54e0056a094ee994dc.js?ver=af0b6" defer data-deferred="1"></script>
<script id="fusion-scroll-to-anchor-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvblNjcm9sbFRvQW5jaG9yVmFycz17ImNvbnRlbnRfYnJlYWtfcG9pbnQiOiI4MDAiLCJjb250YWluZXJfaHVuZHJlZF9wZXJjZW50X2hlaWdodF9tb2JpbGUiOiIwIn0=" defer></script>
<script data-optimized="1" id="fusion-scroll-to-anchor-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/a48e74a65e9c7f6d4a28126b91cd4f8f.js?ver=cc70b" defer data-deferred="1"></script>
<script id="fusion-video-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvblZpZGVvVmFycz17InN0YXR1c192aW1lbyI6IjAifQ==" defer></script>
<script data-optimized="1" id="fusion-video-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/b9908f7f9e91fd01104dc4e6e7af8efe.js?ver=69ca8" defer data-deferred="1"></script>
<script data-optimized="1" id="fusion-column-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/e1165df2c89a619f5f6aa3bd667bde43.js?ver=435be" defer data-deferred="1"></script>
<script id="wc-cart-fragments-js-extra" src="data:text/javascript;base64,dmFyIHdjX2NhcnRfZnJhZ21lbnRzX3BhcmFtcz17ImFqYXhfdXJsIjoiL3dwLWFkbWluL2FkbWluLWFqYXgucGhwP2xhbmc9aXQiLCJ3Y19hamF4X3VybCI6Ii9pdC8/d2MtYWpheD0lJWVuZHBvaW50JSUiLCJjYXJ0X2hhc2hfa2V5Ijoid2NfY2FydF9oYXNoX2ZhNmI2ZTJjZGFkNGZiYWI1ZTJjYTcxZTljOGIxOWVhLWl0LVVTRCIsImZyYWdtZW50X25hbWUiOiJ3Y19mcmFnbWVudHNfZmE2YjZlMmNkYWQ0ZmJhYjVlMmNhNzFlOWM4YjE5ZWEtaXQtVVNEIiwicmVxdWVzdF90aW1lb3V0IjoiNTAwMCJ9" defer></script>
<script data-optimized="1" data-wp-strategy="defer" defer id="wc-cart-fragments-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/7d81cfa231efbb9d8db5d9cc39ea7ef8.js?ver=592fb"></script>
<script type="text/javascript" src="data:text/javascript;base64,aWYodHlwZW9mIHdvb2NvbW1lcmNlX3ByaWNlX3NsaWRlcl9wYXJhbXMhPT0ndW5kZWZpbmVkJyl7d29vY29tbWVyY2VfcHJpY2Vfc2xpZGVyX3BhcmFtcy5jdXJyZW5jeV9mb3JtYXRfc3ltYm9sPXdjbWxfbWNfc2V0dGluZ3MuY3VycmVudF9jdXJyZW5jeS5zeW1ib2x9" defer></script>
</div>
<section class="to-top-container to-top-right awb-to-top-text-before" aria-labelledby="awb-to-top-label">
<a href="#" id="toTop" class="fusion-top-top-link">
<span id="awb-to-top-label" class="screen-reader-text">Go to Top</span>
</a>
</section>
<script data-no-optimize="1">window.lazyLoadOptions=Object.assign({},{threshold:300},window.lazyLoadOptions||{});!function(t,e){"object"==typeof exports&&"undefined"!=typeof module?module.exports=e():"function"==typeof define&&define.amd?define(e):(t="undefined"!=typeof globalThis?globalThis:t||self).LazyLoad=e()}(this,function(){"use strict";function e(){return(e=Object.assign||function(t){for(var e=1;e<arguments.length;e++){var n,a=arguments[e];for(n in a)Object.prototype.hasOwnProperty.call(a,n)&&(t[n]=a[n])}return t}).apply(this,arguments)}function o(t){return e({},at,t)}function l(t,e){return t.getAttribute(gt+e)}function c(t){return l(t,vt)}function s(t,e){return function(t,e,n){e=gt+e;null!==n?t.setAttribute(e,n):t.removeAttribute(e)}(t,vt,e)}function i(t){return s(t,null),0}function r(t){return null===c(t)}function u(t){return c(t)===_t}function d(t,e,n,a){t&&(void 0===a?void 0===n?t(e):t(e,n):t(e,n,a))}function f(t,e){et?t.classList.add(e):t.className+=(t.className?" ":"")+e}function _(t,e){et?t.classList.remove(e):t.className=t.className.replace(new RegExp("(^|\\s+)"+e+"(\\s+|$)")," ").replace(/^\s+/,"").replace(/\s+$/,"")}function g(t){return t.llTempImage}function v(t,e){!e||(e=e._observer)&&e.unobserve(t)}function b(t,e){t&&(t.loadingCount+=e)}function p(t,e){t&&(t.toLoadCount=e)}function n(t){for(var e,n=[],a=0;e=t.children[a];a+=1)"SOURCE"===e.tagName&&n.push(e);return n}function h(t,e){(t=t.parentNode)&&"PICTURE"===t.tagName&&n(t).forEach(e)}function a(t,e){n(t).forEach(e)}function m(t){return!!t[lt]}function E(t){return t[lt]}function I(t){return delete t[lt]}function y(e,t){var n;m(e)||(n={},t.forEach(function(t){n[t]=e.getAttribute(t)}),e[lt]=n)}function L(a,t){var o;m(a)&&(o=E(a),t.forEach(function(t){var e,n;e=a,(t=o[n=t])?e.setAttribute(n,t):e.removeAttribute(n)}))}function k(t,e,n){f(t,e.class_loading),s(t,st),n&&(b(n,1),d(e.callback_loading,t,n))}function A(t,e,n){n&&t.setAttribute(e,n)}function O(t,e){A(t,rt,l(t,e.data_sizes)),A(t,it,l(t,e.data_srcset)),A(t,ot,l(t,e.data_src))}function w(t,e,n){var a=l(t,e.data_bg_multi),o=l(t,e.data_bg_multi_hidpi);(a=nt&&o?o:a)&&(t.style.backgroundImage=a,n=n,f(t=t,(e=e).class_applied),s(t,dt),n&&(e.unobserve_completed&&v(t,e),d(e.callback_applied,t,n)))}function x(t,e){!e||0<e.loadingCount||0<e.toLoadCount||d(t.callback_finish,e)}function M(t,e,n){t.addEventListener(e,n),t.llEvLisnrs[e]=n}function N(t){return!!t.llEvLisnrs}function z(t){if(N(t)){var e,n,a=t.llEvLisnrs;for(e in a){var o=a[e];n=e,o=o,t.removeEventListener(n,o)}delete t.llEvLisnrs}}function C(t,e,n){var a;delete t.llTempImage,b(n,-1),(a=n)&&--a.toLoadCount,_(t,e.class_loading),e.unobserve_completed&&v(t,n)}function R(i,r,c){var l=g(i)||i;N(l)||function(t,e,n){N(t)||(t.llEvLisnrs={});var a="VIDEO"===t.tagName?"loadeddata":"load";M(t,a,e),M(t,"error",n)}(l,function(t){var e,n,a,o;n=r,a=c,o=u(e=i),C(e,n,a),f(e,n.class_loaded),s(e,ut),d(n.callback_loaded,e,a),o||x(n,a),z(l)},function(t){var e,n,a,o;n=r,a=c,o=u(e=i),C(e,n,a),f(e,n.class_error),s(e,ft),d(n.callback_error,e,a),o||x(n,a),z(l)})}function T(t,e,n){var a,o,i,r,c;t.llTempImage=document.createElement("IMG"),R(t,e,n),m(c=t)||(c[lt]={backgroundImage:c.style.backgroundImage}),i=n,r=l(a=t,(o=e).data_bg),c=l(a,o.data_bg_hidpi),(r=nt&&c?c:r)&&(a.style.backgroundImage='url("'.concat(r,'")'),g(a).setAttribute(ot,r),k(a,o,i)),w(t,e,n)}function G(t,e,n){var a;R(t,e,n),a=e,e=n,(t=Et[(n=t).tagName])&&(t(n,a),k(n,a,e))}function D(t,e,n){var a;a=t,(-1<It.indexOf(a.tagName)?G:T)(t,e,n)}function S(t,e,n){var a;t.setAttribute("loading","lazy"),R(t,e,n),a=e,(e=Et[(n=t).tagName])&&e(n,a),s(t,_t)}function V(t){t.removeAttribute(ot),t.removeAttribute(it),t.removeAttribute(rt)}function j(t){h(t,function(t){L(t,mt)}),L(t,mt)}function F(t){var e;(e=yt[t.tagName])?e(t):m(e=t)&&(t=E(e),e.style.backgroundImage=t.backgroundImage)}function P(t,e){var n;F(t),n=e,r(e=t)||u(e)||(_(e,n.class_entered),_(e,n.class_exited),_(e,n.class_applied),_(e,n.class_loading),_(e,n.class_loaded),_(e,n.class_error)),i(t),I(t)}function U(t,e,n,a){var o;n.cancel_on_exit&&(c(t)!==st||"IMG"===t.tagName&&(z(t),h(o=t,function(t){V(t)}),V(o),j(t),_(t,n.class_loading),b(a,-1),i(t),d(n.callback_cancel,t,e,a)))}function $(t,e,n,a){var o,i,r=(i=t,0<=bt.indexOf(c(i)));s(t,"entered"),f(t,n.class_entered),_(t,n.class_exited),o=t,i=a,n.unobserve_entered&&v(o,i),d(n.callback_enter,t,e,a),r||D(t,n,a)}function q(t){return t.use_native&&"loading"in HTMLImageElement.prototype}function H(t,o,i){t.forEach(function(t){return(a=t).isIntersecting||0<a.intersectionRatio?$(t.target,t,o,i):(e=t.target,n=t,a=o,t=i,void(r(e)||(f(e,a.class_exited),U(e,n,a,t),d(a.callback_exit,e,n,t))));var e,n,a})}function B(e,n){var t;tt&&!q(e)&&(n._observer=new IntersectionObserver(function(t){H(t,e,n)},{root:(t=e).container===document?null:t.container,rootMargin:t.thresholds||t.threshold+"px"}))}function J(t){return Array.prototype.slice.call(t)}function K(t){return t.container.querySelectorAll(t.elements_selector)}function Q(t){return c(t)===ft}function W(t,e){return e=t||K(e),J(e).filter(r)}function X(e,t){var n;(n=K(e),J(n).filter(Q)).forEach(function(t){_(t,e.class_error),i(t)}),t.update()}function t(t,e){var n,a,t=o(t);this._settings=t,this.loadingCount=0,B(t,this),n=t,a=this,Y&&window.addEventListener("online",function(){X(n,a)}),this.update(e)}var Y="undefined"!=typeof window,Z=Y&&!("onscroll"in window)||"undefined"!=typeof navigator&&/(gle|ing|ro)bot|crawl|spider/i.test(navigator.userAgent),tt=Y&&"IntersectionObserver"in window,et=Y&&"classList"in document.createElement("p"),nt=Y&&1<window.devicePixelRatio,at={elements_selector:".lazy",container:Z||Y?document:null,threshold:300,thresholds:null,data_src:"src",data_srcset:"srcset",data_sizes:"sizes",data_bg:"bg",data_bg_hidpi:"bg-hidpi",data_bg_multi:"bg-multi",data_bg_multi_hidpi:"bg-multi-hidpi",data_poster:"poster",class_applied:"applied",class_loading:"litespeed-loading",class_loaded:"litespeed-loaded",class_error:"error",class_entered:"entered",class_exited:"exited",unobserve_completed:!0,unobserve_entered:!1,cancel_on_exit:!0,callback_enter:null,callback_exit:null,callback_applied:null,callback_loading:null,callback_loaded:null,callback_error:null,callback_finish:null,callback_cancel:null,use_native:!1},ot="src",it="srcset",rt="sizes",ct="poster",lt="llOriginalAttrs",st="loading",ut="loaded",dt="applied",ft="error",_t="native",gt="data-",vt="ll-status",bt=[st,ut,dt,ft],pt=[ot],ht=[ot,ct],mt=[ot,it,rt],Et={IMG:function(t,e){h(t,function(t){y(t,mt),O(t,e)}),y(t,mt),O(t,e)},IFRAME:function(t,e){y(t,pt),A(t,ot,l(t,e.data_src))},VIDEO:function(t,e){a(t,function(t){y(t,pt),A(t,ot,l(t,e.data_src))}),y(t,ht),A(t,ct,l(t,e.data_poster)),A(t,ot,l(t,e.data_src)),t.load()}},It=["IMG","IFRAME","VIDEO"],yt={IMG:j,IFRAME:function(t){L(t,pt)},VIDEO:function(t){a(t,function(t){L(t,pt)}),L(t,ht),t.load()}},Lt=["IMG","IFRAME","VIDEO"];return t.prototype={update:function(t){var e,n,a,o=this._settings,i=W(t,o);{if(p(this,i.length),!Z&&tt)return q(o)?(e=o,n=this,i.forEach(function(t){-1!==Lt.indexOf(t.tagName)&&S(t,e,n)}),void p(n,0)):(t=this._observer,o=i,t.disconnect(),a=t,void o.forEach(function(t){a.observe(t)}));this.loadAll(i)}},destroy:function(){this._observer&&this._observer.disconnect(),K(this._settings).forEach(function(t){I(t)}),delete this._observer,delete this._settings,delete this.loadingCount,delete this.toLoadCount},loadAll:function(t){var e=this,n=this._settings;W(t,n).forEach(function(t){v(t,e),D(t,n,e)})},restoreAll:function(){var e=this._settings;K(e).forEach(function(t){P(t,e)})}},t.load=function(t,e){e=o(e);D(t,e)},t.resetStatus=function(t){i(t)},t}),function(t,e){"use strict";function n(){e.body.classList.add("litespeed_lazyloaded")}function a(){console.log("[LiteSpeed] Start Lazy Load"),o=new LazyLoad(Object.assign({},t.lazyLoadOptions||{},{elements_selector:"[data-lazyloaded]",callback_finish:n})),i=function(){o.update()},t.MutationObserver&&new MutationObserver(i).observe(e.documentElement,{childList:!0,subtree:!0,attributes:!0})}var o,i;t.addEventListener?t.addEventListener("load",a,!1):t.attachEvent("onload",a)}(window,document);</script><script>window.litespeed_ui_events=window.litespeed_ui_events||["mouseover","click","keydown","wheel","touchmove","touchstart","pointerup","pointerdown"];var urlCreator=window.URL||window.webkitURL;function litespeed_load_delayed_js_force(){console.log("[LiteSpeed] Start Load JS Delayed"),litespeed_ui_events.forEach(e=>{window.removeEventListener(e,litespeed_load_delayed_js_force,{passive:!0})}),document.querySelectorAll("iframe[data-litespeed-src]").forEach(e=>{e.setAttribute("src",e.getAttribute("data-litespeed-src"))}),"loading"==document.readyState?window.addEventListener("DOMContentLoaded",litespeed_load_delayed_js):litespeed_load_delayed_js()}litespeed_ui_events.forEach(e=>{window.addEventListener(e,litespeed_load_delayed_js_force,{passive:!0})});async function litespeed_load_delayed_js(){let t=[];for(var d in document.querySelectorAll('script[type="litespeed/javascript"]').forEach(e=>{t.push(e)}),t)await new Promise(e=>litespeed_load_one(t[d],e));document.dispatchEvent(new Event("DOMContentLiteSpeedLoaded")),window.dispatchEvent(new Event("DOMContentLiteSpeedLoaded"))}function litespeed_load_one(t,e){console.log("[LiteSpeed] Load ",t);function d(){o.src.startsWith("blob:")&&URL.revokeObjectURL(o.src),e()}var o=document.createElement("script");o.addEventListener("load",d),o.addEventListener("error",d),t.getAttributeNames().forEach(e=>{"type"!=e&&o.setAttribute("data-src"==e?"src":e,t.getAttribute(e))}),o.type="text/javascript",!o.src&&t.textContent&&(o.src=litespeed_inline2src(t.textContent)),t.after(o),t.remove()}function litespeed_inline2src(t){try{var d=urlCreator.createObjectURL(new Blob([t.replace(/^(?:<!--)?(.*?)(?:-->)?$/gm,"$1")],{type:"text/javascript"}))}catch(e){d="data:text/javascript;base64,"+btoa(t.replace(/^(?:<!--)?(.*?)(?:-->)?$/gm,"$1"))}return d}</script></body>
</html>
<!-- Page cached by LiteSpeed Cache 7.9.1 on 2026-10-12 20:06:47 -->