Les algorithmes des moteurs de recherche n’évaluent plus les textes comme de simples suites de mots-clés isolés. Les systèmes modernes de recherche d’information interprètent désormais le contenu web à travers des espaces vectoriels multidimensionnels, des graphes de relations d’entités et des modèles prédictifs de satisfaction utilisateur. Des architectures majeures — à l’instar de RankBrain, BERT ou MUM chez Google — ont délaissé le simple appariement lexical au profit d’une compréhension sémantique profonde.
Pour pérenniser sa visibilité organique et maximiser la conversion, un écosystème digital d’entreprise doit intégrer des processus d’optimisation algorithmique. L’intégration de l’IA au cœur de l’infrastructure de publication transforme la production éditoriale : l’écriture subjective cède la place à une ingénierie de contenu rigoureusement adossée à la donnée. Ce guide détaille les leviers mathématiques, architecturaux et éditoriaux indispensables pour convertir vos plateformes web en actifs organiques à haute performance.
—
1. Les Mécanismes de la Recherche d’Information Moderne : Vecteurs et Graphes Sémantiques
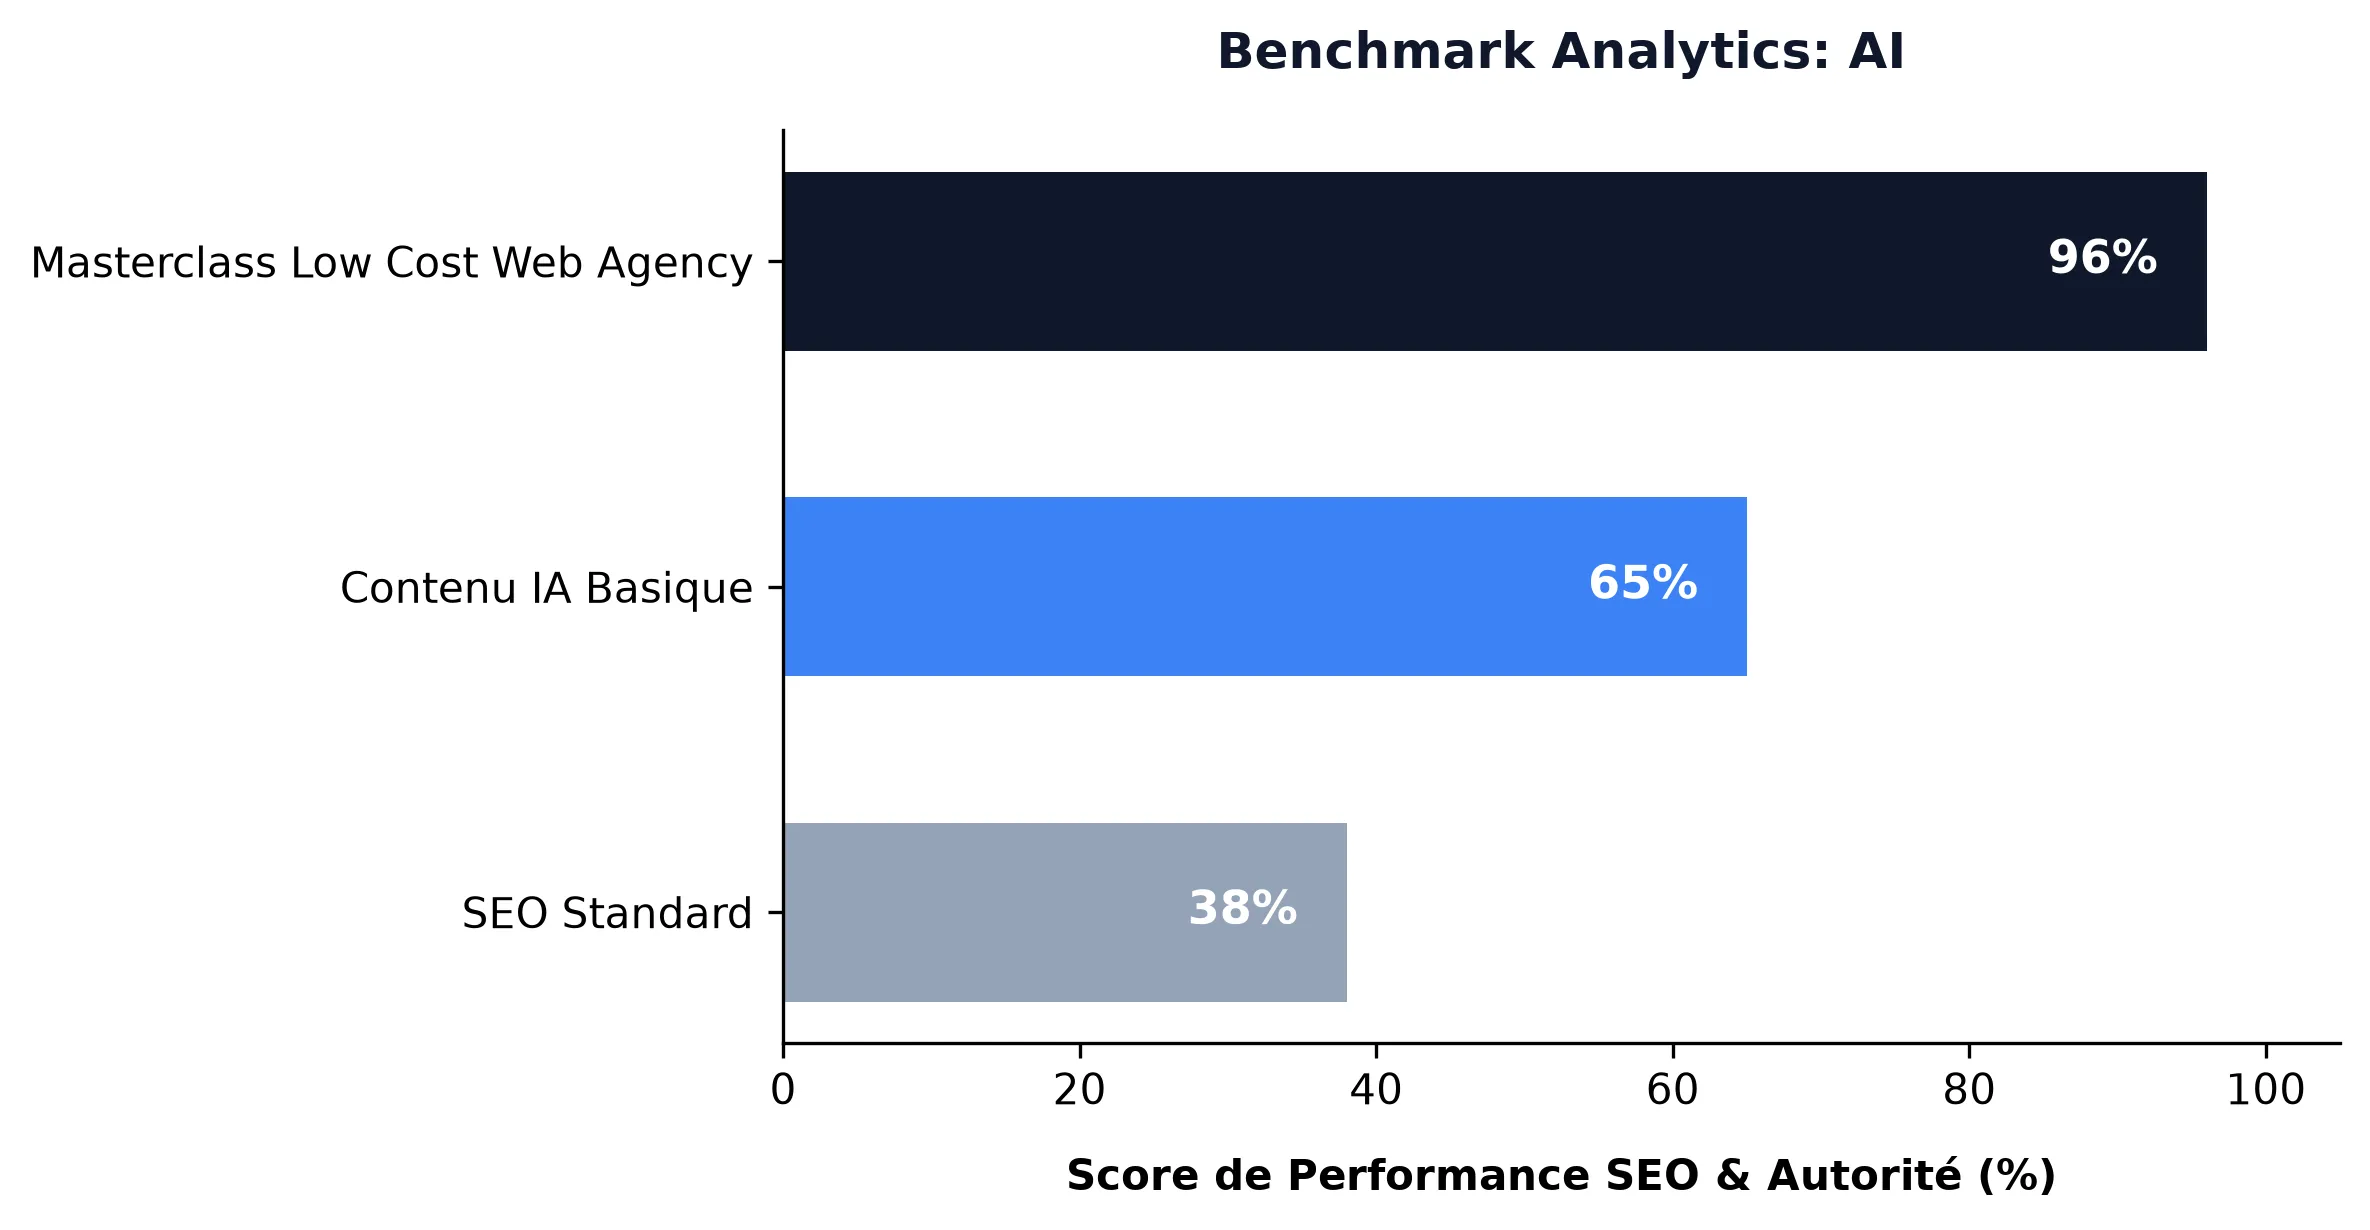
Benchmark de performance : AI
Le référencement naturel traditionnel reposait historiquement sur des pondérations de type TF-IDF (Term Frequency-Inverse Document Frequency). Désormais, les modèles de langage (LLM) et les réseaux neuronaux pilotent des moteurs d’indexation capables d’appréhender le contexte, l’autorité thématique globale et la granularité de l’intention de recherche.
« `
Plongements Vectoriels et Dense Passage Retrieval (DPR)
Les moteurs convertissent documents et requêtes en vecteurs numériques de dimension supérieure (généralement entre 768 et 1536 dimensions). Lorsqu’un utilisateur formule une demande, le système ne se contente pas de scruter des chaînes de caractères : il mesure la proximité géométrique entre le vecteur de la requête et les vecteurs des documents au sein d’un même espace mathématique, à l’aide de la similarité cosinus :
$$text{Similarité Cosinus}(A, B) = frac{A cdot B}{|A| |B|} = frac{sum_{i=1}^{n} A_i B_i}{sqrt{sum_{i=1}^{n} A_i^2} sqrt{sum_{i=1}^{n} B_i^2}}$$
Si un texte n’entretient pas une proximité contextuelle directe avec les concepts fondamentaux, les sous-entités et les attributs associés à son sujet, il restera invisible lors de la phase de Dense Passage Retrieval (DPR). Évaluer la couverture sémantique via des modèles d’IA permet d’identifier immédiatement les lacunes conceptuelles qu’un rédacteur humain omet fréquemment.
Extraction d’Entités et Alignement sur le Knowledge Graph
Les moteurs de recherche structurent le web via d’immenses bases de connaissances : des réseaux d’entités (personnes, lieux, concepts, technologies) reliées par des propriétés formelles. Leurs algorithmes analysent le code HTML via le traitement automatique du langage naturel (NLP) et la reconnaissance d’entités nommées (NER) pour isoler :
* **L’Entité Principale :** Le sujet central du document ou de l’URI.
Établir explicitement ces relations à l’aide d’une syntaxe chirurgicale et de données structurées neutralise toute ambiguïté algorithmique. Cette rigueur sémantique répond aux exigences documentées dans les Google Search Central guidelines relatives à l’autorité thématique et à l’indexation de contenus à forte valeur ajoutée.
—
2. Ingénierie On-Page Dynamique par Analyse Algorithmique
Exploiter l’IA pour optimiser un texte ne se résume pas à générer des blocs de texte en continu. Il s’agit d’analyser la densité d’information, d’éliminer le bruit sémantique et d’apporter une réponse structurée à l’intention de l’internaute avec un minimum de friction cognitive.
« `
Expansion Thématique et Maillage en Clusters
Pour asseoir son autorité sur un secteur concurrentiel, un contenu isolé ne suffit plus. La performance repose sur un ensemble interconnecté de pages sémantiquement cohérentes. Des algorithmes de partitionnement de données non supervisés (comme k-means ou le clustering hiérarchique) peuvent ingérer des milliers de résultats de recherche pour les segmenter selon leur intention réelle :
1. **Intention Informationnelle :** Contenus pédagogiques d’amont décortiquant les mécanismes fondamentaux.
Construire des cocons sémantiques assistés par IA élimine le risque d’auto-cannibalisation lexicale. Chaque URL cible un sous-espace vectoriel dédié tout en renforçant le domaine parent par un maillage interne bidirectionnel. Pour comprendre l’articulation entre facteurs de classement sémantiques et architecture de navigation, consultez Ai-crafted content: the future of seo and web design mastery .
Métadonnées Systémiques : Précision Programmatique
La couche de métadonnées constitue le premier point de contact entre l’algorithme, l’internaute et votre infrastructure de marque. La rédaction manuelle de balises sur des milliers de fiches produits ou d’URL programmatiques entraîne irrémédiablement des disparités stylistiques, des longueurs approximatives et des taux de clic dégradés.
Déployer des modèles affinés pour concevoir ces éléments garantit le strict respect des contraintes d’affichage (150 à 158 caractères, soit 960 pixels sur mobile), l’intégration fluide des mots-clés clés et des incitations à l’action percutantes. Retrouvez des cas d’usage concrets dans l’article Ai-crafted meta descriptors: the secret sauce for instant visibility boost .
Ingénierie des Titres et Maximisation du Taux de Clic (CTR)
Les balises `
` et les titres `</p>
<h1>` déterminent à la fois la pertinence thématique perçue par le robot et l’engagement effectif sur la SERP. L’ingénierie algorithmique de titres étudie l’historique de performance des clics, la tonalité émotionnelle et les biais cognitifs face aux résultats concurrents en direct.</p>
<p>« `<br />
Titre Standard Générique :<br />
« Comment optimiser le contenu de son site avec des outils »</p>
<p>Titre Algorithmique à Forte Saillance :<br />
« Optimisation Algorithmique de Contenu : 7 Frameworks d’Ingénierie pour Dominer la Recherche Sémantique »<br />
« `</p>
<p>Cette formulation optimisée isole immédiatement l’entité centrale (« Optimisation Algorithmique de Contenu »), avance une promesse technique tangible (« 7 Frameworks d’Ingénierie ») et s’aligne directement sur les requêtes à forte valeur ajoutée. Développez cette méthode grâce aux protocoles détaillés dans <a href="https://www.lowcostwebagency.com/?p=50430">Ai-created headlines: boost your clicks with automated news titles</a>.</p>
<p>—</p>
<h2>3. Synergie Rédactionnelle, Schémas Structurés et Cadres Visuels</h2>
<p>Le travail textuel ne représente qu’un des piliers de la visibilité organique. Les algorithmes récompensent la cohérence technique globale : la rédaction doit s’articuler étroitement avec les données structurées, l’ergonomie visuelle et les tunnels de conversion.</p>
<h3>Composition Algorithmique et Montée en Charge Éditoriale</h3>
<p>Les modèles génératifs, encadrés par des pipelines de prompts programmatiques et des règles système déterministes, produisent des ébauches complètes, des présentations de catégories techniques et des synthèses analytiques avec une efficacité inédite. Livrée sans contrôle, une génération brute engendre cependant une faible variété lexicale, des tournures stéréotypées et des inexactitudes factuelles.</p>
<p>« `python<br />
# Architecture Conceptuelle : Pipeline de Contrôle Qualité Automatisé<br />
def evaluate_content_quality(draft_text, target_entities, corpus_embeddings):<br />
# Étape 1 : Calcul de la couverture d’entités<br />
extracted_entities = run_ner_model(draft_text)<br />
entity_coverage = len(set(extracted_entities) & set(target_entities)) / len(target_entities)</p>
<p> # Étape 2 : Distance vectorielle sémantique<br />
draft_vector = generate_embeddings(draft_text)<br />
relevance_score = cosine_similarity(draft_vector, corpus_embeddings.mean_vector)</p>
<p> # Étape 3 : Détection d’incohérences factuelles / hallucinations<br />
fact_check_flags = cross_reference_knowledge_base(draft_text)</p>
<p> return {<br />
« entity_coverage »: entity_coverage,<br />
« semantic_relevance »: relevance_score,<br />
« review_required »: len(fact_check_flags) > 0<br />
}<br />
« `</p>
<p>En structurant un pipeline éditorial qui associe rédaction assistée et validation par des tests d’évaluation automatisés, une organisation peut élargir son empreinte d’indexation tout en maintenant une exigence technique sans faille. Découvrez l’implémentation de ces outils dans <a href="https://www.lowcostwebagency.com/ai-writing-magic-instantly-boost/">Ai-powered content magic: instantly boost your website’s visibility with automated copywriting wizards</a>.</p>
<h3>Adaptation de l’Interface et Architectures Orientées Conversion</h3>
<p>Un contenu performant dans les classements mais délaissé par ses visiteurs détériore rapidement ses métriques comportementales et augmente son taux de rebond. L’IA permet d’analyser l’expérience utilisateur par l’intermédiaire de cartes de chaleur prédictives, d’analyses de profondeur de défilement et de recompositions dynamiques du DOM.</p>
<p>Il devient alors possible d’adapter l’affichage selon le segment d’intention détecté :</p>
<p>* **Profils Techniques :** Arborescences documentaires denses, sommaires interactifs débrayables et blocs de code immédiatement exécutables.<br />
* **Décideurs d’Entreprise :** Encadrés récapitulatifs à forte valeur ajoutée, simulateurs directs de ROI et boutons d’action visibles dès le premier écran.</p>
<p>Pour analyser ces interfaces calculées qui maximisent directement le rendement transactionnel, étudiez le dossier <a href="https://www.lowcostwebagency.com/fr/revolutionizing-web-design-aipowered-layouts-2/">Revolutionizing web design: ai-powered layouts that convert visits into sales</a>.</p>
<p>—</p>
<h2>4. Protocole de Déploiement : Bâtir un Pipeline Algorithmique</h2>
<p>Intégrer l’IA dans une stratégie de contenu de niveau entreprise exige de rompre avec l’utilisation informelle d’interfaces conversationnelles. Il convient de déployer une véritable architecture logicielle industrielle.</p>
<p>« `<br />
┌─────────────────────────────────────────────────────────────┐<br />
│ PIPELINE D’OPTIMISATION DE CONTENU PAR IA │<br />
└─────────────────────────────────────────────────────────────┘<br />
│<br />
├─ Phase 1 : Extraction du Corpus & Analyse des Écarts<br />
│ ├─ Scraping des 20 premiers résultats positionnés sur la cible<br />
│ ├─ Exécution de la Reconnaissance d’Entités Nommées (NER)<br />
│ └─ Calcul du différentiel sémantique (concepts manquants)<br />
│<br />
├─ Phase 2 : Synthèse de Données & Gain d’Information<br />
│ ├─ Agrégation de métriques internes, données propriétaires, retours d’expérience<br />
│ ├─ Conception de gabarits de prompts aux paramètres d’encadrement stricts<br />
│ └─ Rédaction de modules axés exclusivement sur la donnée non dupliquée<br />
│<br />
├─ Phase 3 : Formatage Technique & Intégration Schema.org<br />
│ ├─ Génération automatisée des données JSON-LD (Article, FAQ, TechArticle)<br />
│ ├─ Structuration des niveaux de titres (H1 -> H2 -> H3) calée sur les intentions<br />
│ └─ Validation de la sémantique HTML5 selon les normes W3C<br />
│<br />
└─ Phase 4 : Monitoring Vectoriel Continu & Actualisation<br />
├─ Suivi du positionnement des mots-clés et des fonctionnalités SERP<br />
├─ Mesure de la dérive vectorielle à 90 jours vs nouvelles pages positionnées<br />
└─ Déclenchement de micro-mises à jour programmées pour contrer l’obsolescence<br />
« `</p>
<h3>Phase 1 : Extraction du Corpus et Détection des Écarts Sémantiques</h3>
<p>Le processus démarre par l’interrogation méthodique de la SERP. Après extraction des 20 premières URL concurrentes sur votre requête cible, transformez ce corpus textuel brut en matrice d’entités :</p>
<p>1. **Isolation des Entités Clés :** Appliquez un modèle de traitement du langage (tel que spaCy, Google Cloud Natural Language ou une architecture Transformer custom) pour identifier les entités saillantes et leurs triplets grammaticaux (*sujet-prédicat-objet*).<br />
2. **Calcul du Centroïde Vectoriel :** Calculez la position vectorielle moyenne (le barycentre mathématique) occupée par les 3 premiers résultats positionnés.<br />
3. **Cartographie du Delta :** Isolez précisément les concepts systématiquement présents chez les leaders mais absents de votre page en cours de rédaction.</p>
<h3>Phase 2 : Gain d’Information et Injection de Valeur Exclusif</h3>
<p>Les brevets relatifs à l’Information Gain déposés par Google confirment que les algorithmes pondèrent désormais les pages selon leur capacité à apporter des *informations inédites* par rapport aux documents déjà consultés par l’internaute. Recycler les contenus existants via une simple reformulation lexicale mène inévitablement au déclassement.</p>
<p>* **Métriques Propriétaires :** Intégrez des données de conversion réelles, des retours d’ingénierie internes et des statistiques inédites directement dans vos démonstrations.<br />
* **Contre-Analyses Techniques :** Utilisez l’IA pour identifier les cas limites et les écueils d’implémentation délaissés par les guides superficiels.<br />
* **Structuration Didactique :** Traduisez les flux de travail complexes sous forme de tableaux comparatifs, d’arbres décisionnels et de scripts immédiatement exploitables.</p>
<h3>Phase 3 : Parsing Technique et Implémentation Schema</h3>
<p>Encadrez vos contenus dans une structure de balisage explicite. Les moteurs d’indexation ne doivent formuler aucune supposition quant à l’identité d’un auteur, le déroulement d’une procédure ou la nature d’une définition :</p>
<p>« `json<br />
{<br />
« @context »: « https://schema.org »,<br />
« @type »: « TechArticle »,<br />
« headline »: « Optimisation Avancée de Contenu : Architecture Algorithmique et Recherche Sémantique »,<br />
« description »: « Guide technique d’ingénierie de contenu : optimisation pour la recherche vectorielle, enrichissement d’entités et performance éditoriale programmatique. »,<br />
« author »: {<br />
« @type »: « Organization »,<br />
« name »: « Low Cost Web Agency »,<br />
« url »: « https://www.lowcostwebagency.com »<br />
},<br />
« keywords »: « IA, optimisation de contenu, recherche vectorielle, SEO sémantique, dense passage retrieval »,<br />
« about »: [<br />
{<br />
« @type »: « Thing »,<br />
« name »: « Artificial Intelligence »<br />
},<br />
{<br />
« @type »: « Thing »,<br />
« name »: « Natural Language Processing »<br />
},<br />
{<br />
« @type »: « Thing »,<br />
« name »: « Search Engine Optimization »<br />
}<br />
]<br />
}<br />
« `</p>
<p>En reliant vos concepts aux identifiants normalisés de Wikidata ou du vocabulaire Schema.org, vous éliminez les ambiguïtés et simplifiez votre intégration au Knowledge Graph ainsi qu’aux encarts d’information zéro-clic.</p>
<h3>Phase 4 : Monitoring Vectoriel Continu et Maintenance</h3>
<p>Le positionnement dans les moteurs de recherche n’est pas un état figé. De nouvelles pages sont indexées quotidiennement et les modèles de classement réajustent continuellement leurs pondérations. Un article statique perd inévitablement en compétitivité.</p>
<p>Automatisez la veille technique :</p>
<p>* **Audit Trimestriel des Embeddings :** Mesurez tous les 90 jours la distance cosinus entre le vecteur de votre page et le nouveau barycentre de la SERP.<br />
* **Détection du Glissement des Requêtes :** Interrogez l’API Google Search Console pour repérer l’émergence de nouvelles requêtes associées pour lesquelles votre document manque de sous-titres dédiés.<br />
* **Enrichissement Incrémental :** Intégrez des sections ciblées traitant directement ces nouveaux angles pour maintenir le statut de référence absolue de votre page sur son cluster d’autorité.</p>
<p>—</p>
<h2>5. Évaluation Comparative : Optimisation Manuelle vs Workflows Algorithmiques</h2>
<p>L’analyse objective des deux approches met en lumière les gains stratégiques associés à l’automatisation par l’IA :</p>
<p>| Paramètre Opérationnel | Optimisation Manuelle Traditionnelle | Optimisation Algorithmique Pilotée par l’IA |<br />
| :— | :— | :— |<br />
| **Méthodologie de Recherche** | Lecture subjective des SERP, ciblage axé sur un mot-clé unique | Audits de similarité vectorielle, extraction d’entités, détection algorithmique des manques |<br />
| **Vitesse d’Exécution** | 10 à 15 heures par ressource technique approfondie | 2 à 3 heures (génération guidée par IA avec validation par un expert métier) |<br />
| **Couverture Sémantique** | Restreinte aux connaissances directes du rédacteur | Cartographie exhaustive d’entités extraites de millions de documents de référence |<br />
| **Score de Gain d’Information** | Irrégulier ; forte tendance à la reformulation d’idées préexistantes | Élevé ; ciblage systématique des angles morts et des données absentes du web |<br />
| **Capacité de Passage à l’Échelle** | Faible ; progression linéaire des coûts avec l’augmentation du volume | Maximale ; déploiements programmatiques massifs sous plafonds de coûts maîtrisés |<br />
| **Gestion des Métadonnées** | Remplissage artisanal, souvent délaissé sur les sous-pages profondes | Génération dynamique, calibration au pixel près, tests d’impact continus |</p>
<p>—</p>
<h2>6. Mesurer la Performance Algorithmique : Indicateurs Clés</h2>
<p>Suivre l’efficacité d’un contenu optimisé par IA impose de mesurer des indicateurs directement corrélés aux nouveaux signaux de qualité algorithmiques :</p>
<h3>Score de Gain d’Information (Information Gain Score – IGS)<br />
Bien qu’aucun outil ne fournisse ce score via une API publique, vous pouvez en mesurer l’impact direct : analysez la capacité d’une page à se positionner sur des variantes d’intention secondaires et des requêtes de longue traîne avant même l’acquisition de backlinks externes. Une URL neuve se classant sur des dizaines d’expressions connexes dès sa première indexation démontre un gain d’information et une amplitude thématique optimaux.</h3>
<h3>Saillance d’Entité et Profondeur Thématique<br />
Utilisez des scripts de NLP pour cartographier vos contenus en production. Visez une distribution où l’entité centrale affiche un score de saillance supérieur à 0,30, soutenu par des entités secondaires pondérées entre 0,05 et 0,15. Ce schéma reproduit exactement la distribution d’entités observée dans les publications scientifiques de référence.</h3>
<p>« `<br />
[Concept Central : Optimisation par IA] (Saillance : 0.38)<br />
│<br />
├─ [Traitement Automatique du Langage] (Saillance : 0.14)<br />
├─ [Plongements Vectoriels] (Saillance : 0.11)<br />
├─ [Recherche d’Information] (Saillance : 0.09)<br />
└─ [Graphes de Connaissances] (Saillance : 0.08)<br />
« `</p>
<h3>Lisibilité Cognitive et Parcours de Lecture<br />
Un taux d’abandon précoce neutralise les signaux positifs de positionnement. Le contenu généré et optimisé par IA doit préserver un équilibre stylistique rigoureux, à l’écart de deux dérives :<br />
* Une syntaxe académique lourde qui décourage la lecture rapide.<br />
* Des formulations robotiques et redondantes trahissant une génération automatique non remaniée.</h3>
<p>Alternez déclarations concises, protocoles d’application directe, blocs de code prêts à l’emploi et schémas synthétiques.</p>
<p>—</p>
<h2>7. Synthèse Stratégique : L’Avenir de l’Optimisation Web Autonome</h2>
<p>L’optimisation du contenu en ligne ne relève plus de recettes stylistiques subjectives. Les moteurs de recherche fonctionnent désormais comme des réseaux de calcul vectoriel, capables d’arpenter des espaces géométriques denses, d’évaluer la cohérence de graphes d’autorité et de mesurer l’interaction utilisateur en temps réel.</p>
<p>Adopter une méthodologie pilotée par l’intelligence artificielle permet d’aligner vos contenus sur la manière dont les algorithmes ingèrent, décodent et classent le savoir numérique. En articulant :<br />
* L’analyse vectorielle avancée,<br />
* L’adaptation structurelle de l’expérience utilisateur,<br />
* L’ingénierie programmatique des métadonnées,<br />
* La production de contenus denses en données exclusives,</p>
<p>votre organisation déploie des actifs numériques résilients face aux mises à jour algorithmiques, surpasse les positions historiques de concurrents établis et capte durablement une audience qualifiée à forte valeur ajoutée.</p>
<p>Faites évoluer vos équipes vers l’ingénierie de contenu algorithmique. Quittez les réflexes rédactionnels obsolètes, bâtissez des architectures éditoriales scientifiquement modélisées et assurez votre souveraineté sur les nouveaux territoires de la recherche sémantique.</p>
<div class="lowcost-cta-box" style="background: #f8fafc;border-left: 4px solid #0f172a;padding: 25px;margin: 40px 0;border-radius: 0 8px 8px 0">
<h3 style="margin-top: 0;color: #0f172a;font-size: 1.3em">Prêt à propulser votre infrastructure digitale ?</h3>
<p style="color: #334155;line-height: 1.6">Ne laissez pas les freins techniques ralentir votre croissance. Discutez de votre projet autour de <strong>Revolutionizing your website with ai-powered content optimization techniques</strong> directement avec nos experts seniors chez Low Cost Web Agency.</p>
<p style="margin-bottom: 0"><a href="https://wa.me/919786495150" target="_blank" style="display: inline-block;background: #25D366;color: white;padding: 12px 24px;border-radius: 6px;text-decoration: none;font-weight: bold" rel="noopener">💬 Contactez-nous sur WhatsApp (Message uniquement : +919786495150)</a></p>
</p></div>
</div>
<span class="vcard rich-snippet-hidden"><span class="fn"><a href="https://www.lowcostwebagency.com/fr/author/alex/" rel="author">Alexandre MENINI</a></span></span><span class="updated rich-snippet-hidden">2026-10-12T17:51:34+05:30</span> <section class="related-posts single-related-posts">
<div class="fusion-title fusion-title-size-two sep-single sep-solid" style="margin-top:0px;margin-bottom:30px;">
<h2 class="title-heading-left" style="margin:0;">
Articles similaires </h2>
<span class="awb-title-spacer"></span>
<div class="title-sep-container">
<div class="title-sep sep-single sep-solid"></div>
</div>
</div>
<div class="awb-carousel awb-swiper awb-swiper-carousel fusion-carousel-title-below-image" data-imagesize="fixed" data-metacontent="yes" data-autoplay="yes" data-touchscroll="no" data-columns="3" data-itemmargin="20px" data-itemwidth="180" data-scrollitems="1">
<div class="swiper-wrapper">
<div class="swiper-slide">
<div class="fusion-carousel-item-wrapper">
<div class="fusion-image-wrapper fusion-image-size-fixed" aria-haspopup="true">
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-500x383.webp" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-500x383.webp 1x, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-500x383@2x.webp 2x" width="500" height="383" alt="Magie du contenu ai : amplify la visibilité de votre site avec des scribes automatiques" />
<div class="fusion-rollover">
<div class="fusion-rollover-content">
<a class="fusion-rollover-link" href="https://www.lowcostwebagency.com/fr/redaction-ia-boostez-la-visibilite/">Magie du contenu ai : amplify la visibilité de votre site avec des scribes automatiques</a>
<a class="fusion-link-wrapper" href="https://www.lowcostwebagency.com/fr/redaction-ia-boostez-la-visibilite/" aria-label="Magie du contenu ai : amplify la visibilité de votre site avec des scribes automatiques"></a>
</div>
</div>
</div>
<h4 class="fusion-carousel-title">
<a class="fusion-related-posts-title-link" href="https://www.lowcostwebagency.com/fr/redaction-ia-boostez-la-visibilite/" target="_self" title="Magie du contenu ai : amplify la visibilité de votre site avec des scribes automatiques">Magie du contenu ai : amplify la visibilité de votre site avec des scribes automatiques</a>
</h4>
<div class="fusion-carousel-meta">
<span class="fusion-date">octobre 11th, 2026</span>
<span class="fusion-inline-sep">|</span>
<span><a href="https://www.lowcostwebagency.com/fr/redaction-ia-boostez-la-visibilite/#respond">0 Comments</a></span>
</div><!-- fusion-carousel-meta -->
</div><!-- fusion-carousel-item-wrapper -->
</div>
<div class="swiper-slide">
<div class="fusion-carousel-item-wrapper">
<div class="fusion-image-wrapper fusion-image-size-fixed" aria-haspopup="true">
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-500x383.webp" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-500x383.webp 1x, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-500x383@2x.webp 2x" width="500" height="383" alt="Descripteurs métas conçus par ia : le secret pour une visibilité immédiate" />
<div class="fusion-rollover">
<div class="fusion-rollover-content">
<a class="fusion-rollover-link" href="https://www.lowcostwebagency.com/fr/meta-descriptions-ia-le-secret/">Descripteurs métas conçus par ia : le secret pour une visibilité immédiate</a>
<a class="fusion-link-wrapper" href="https://www.lowcostwebagency.com/fr/meta-descriptions-ia-le-secret/" aria-label="Descripteurs métas conçus par ia : le secret pour une visibilité immédiate"></a>
</div>
</div>
</div>
<h4 class="fusion-carousel-title">
<a class="fusion-related-posts-title-link" href="https://www.lowcostwebagency.com/fr/meta-descriptions-ia-le-secret/" target="_self" title="Descripteurs métas conçus par ia : le secret pour une visibilité immédiate">Descripteurs métas conçus par ia : le secret pour une visibilité immédiate</a>
</h4>
<div class="fusion-carousel-meta">
<span class="fusion-date">octobre 10th, 2026</span>
<span class="fusion-inline-sep">|</span>
<span><a href="https://www.lowcostwebagency.com/fr/meta-descriptions-ia-le-secret/#respond">0 Comments</a></span>
</div><!-- fusion-carousel-meta -->
</div><!-- fusion-carousel-item-wrapper -->
</div>
<div class="swiper-slide">
<div class="fusion-carousel-item-wrapper">
<div class="fusion-image-wrapper fusion-image-size-fixed" aria-haspopup="true">
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-500x383.webp" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-500x383.webp 1x, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-500x383@2x.webp 2x" width="500" height="383" alt="Contenu ai : l’avenir de la référencement et de la maîtrise du design web" />
<div class="fusion-rollover">
<div class="fusion-rollover-content">
<a class="fusion-rollover-link" href="https://www.lowcostwebagency.com/fr/contenu-ia-lavenir-du-seo/">Contenu ai : l’avenir de la référencement et de la maîtrise du design web</a>
<a class="fusion-link-wrapper" href="https://www.lowcostwebagency.com/fr/contenu-ia-lavenir-du-seo/" aria-label="Contenu ai : l’avenir de la référencement et de la maîtrise du design web"></a>
</div>
</div>
</div>
<h4 class="fusion-carousel-title">
<a class="fusion-related-posts-title-link" href="https://www.lowcostwebagency.com/fr/contenu-ia-lavenir-du-seo/" target="_self" title="Contenu ai : l’avenir de la référencement et de la maîtrise du design web">Contenu ai : l’avenir de la référencement et de la maîtrise du design web</a>
</h4>
<div class="fusion-carousel-meta">
<span class="fusion-date">octobre 9th, 2026</span>
<span class="fusion-inline-sep">|</span>
<span><a href="https://www.lowcostwebagency.com/fr/contenu-ia-lavenir-du-seo/#respond">0 Comments</a></span>
</div><!-- fusion-carousel-meta -->
</div><!-- fusion-carousel-item-wrapper -->
</div>
<div class="swiper-slide">
<div class="fusion-carousel-item-wrapper">
<div class="fusion-image-wrapper fusion-image-size-fixed" aria-haspopup="true">
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-500x383.webp" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-500x383.webp 1x, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-500x383@2x.webp 2x" width="500" height="383" alt="Révolutionnant le design web : des maquettes ia pour convertir les visiteurs en clients" />
<div class="fusion-rollover">
<div class="fusion-rollover-content">
<a class="fusion-rollover-link" href="https://www.lowcostwebagency.com/fr/web-design-ia-des-layouts/">Révolutionnant le design web : des maquettes ia pour convertir les visiteurs en clients</a>
<a class="fusion-link-wrapper" href="https://www.lowcostwebagency.com/fr/web-design-ia-des-layouts/" aria-label="Révolutionnant le design web : des maquettes ia pour convertir les visiteurs en clients"></a>
</div>
</div>
</div>
<h4 class="fusion-carousel-title">
<a class="fusion-related-posts-title-link" href="https://www.lowcostwebagency.com/fr/web-design-ia-des-layouts/" target="_self" title="Révolutionnant le design web : des maquettes ia pour convertir les visiteurs en clients">Révolutionnant le design web : des maquettes ia pour convertir les visiteurs en clients</a>
</h4>
<div class="fusion-carousel-meta">
<span class="fusion-date">octobre 9th, 2026</span>
<span class="fusion-inline-sep">|</span>
<span><a href="https://www.lowcostwebagency.com/fr/web-design-ia-des-layouts/#respond">0 Comments</a></span>
</div><!-- fusion-carousel-meta -->
</div><!-- fusion-carousel-item-wrapper -->
</div>
<div class="swiper-slide">
<div class="fusion-carousel-item-wrapper">
<div class="fusion-image-wrapper fusion-image-size-fixed" aria-haspopup="true">
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-500x383.webp" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-500x383.webp 1x, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-500x383@2x.webp 2x" width="500" height="383" alt="L’optimisation seo alimentée par l’intelligence artificielle : automatisez l’optimisation des mots-clés pour maximiser la visibilité" />
<div class="fusion-rollover">
<div class="fusion-rollover-content">
<a class="fusion-rollover-link" href="https://www.lowcostwebagency.com/fr/loptimisation-seo-alimentee-par-lintelligence-artificielle-automatisez-loptimisation-des-motscles-pour-maximiser-la-visibilite/">L’optimisation seo alimentée par l’intelligence artificielle : automatisez l’optimisation des mots-clés pour maximiser la visibilité</a>
<a class="fusion-link-wrapper" href="https://www.lowcostwebagency.com/fr/loptimisation-seo-alimentee-par-lintelligence-artificielle-automatisez-loptimisation-des-motscles-pour-maximiser-la-visibilite/" aria-label="L’optimisation seo alimentée par l’intelligence artificielle : automatisez l’optimisation des mots-clés pour maximiser la visibilité"></a>
</div>
</div>
</div>
<h4 class="fusion-carousel-title">
<a class="fusion-related-posts-title-link" href="https://www.lowcostwebagency.com/fr/loptimisation-seo-alimentee-par-lintelligence-artificielle-automatisez-loptimisation-des-motscles-pour-maximiser-la-visibilite/" target="_self" title="L’optimisation seo alimentée par l’intelligence artificielle : automatisez l’optimisation des mots-clés pour maximiser la visibilité">L’optimisation seo alimentée par l’intelligence artificielle : automatisez l’optimisation des mots-clés pour maximiser la visibilité</a>
</h4>
<div class="fusion-carousel-meta">
<span class="fusion-date">octobre 8th, 2026</span>
<span class="fusion-inline-sep">|</span>
<span><a href="https://www.lowcostwebagency.com/fr/loptimisation-seo-alimentee-par-lintelligence-artificielle-automatisez-loptimisation-des-motscles-pour-maximiser-la-visibilite/#respond">0 Comments</a></span>
</div><!-- fusion-carousel-meta -->
</div><!-- fusion-carousel-item-wrapper -->
</div>
</div><!-- swiper-wrapper -->
</div><!-- fusion-carousel -->
</section><!-- related-posts -->
</article>
</section>
<aside id="sidebar" class="sidebar fusion-widget-area fusion-content-widget-area fusion-sidebar-right fusion-blogsidebar" style="float: right;" data="">
<section id="custom_html-7" class="widget_text widget widget_custom_html" style="border-style: solid;border-color:transparent;border-width:0px;"><div class="textwidget custom-html-widget"><div style="text-align: center; padding: 20px; border: 1px solid #e2e2e2; border-radius: 12px; background: #ffffff; box-shadow: 0 2px 8px rgba(0,0,0,0.05); margin-bottom: 25px;">
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/04/alexandre-menini-digital-entrepreneur-low-cost-web-agency.webp" alt="Alexandre Menini" style="width: 130px; height: 130px; border-radius: 50%; object-fit: cover; border: 4px solid #f0f0f0; margin-bottom: 15px; display: inline-block;" width="200" height="200" />
<h3 style="margin: 0 0 5px 0; color: #333; font-size: 19px; font-family: sans-serif;">Alexandre Menini</h3>
<p style="margin: 0 0 15px 0; font-weight: 600; color: #d94141; font-style: italic; font-size: 14px; font-family: sans-serif;">Fondateur & Stratège Global</p>
<p style="line-height: 1.6; color: #444; font-size: 14px; text-align: left; font-family: sans-serif; border-top: 1px solid #eee; padding-top: 15px; margin-top: 10px;">
<strong>Entrepreneur Polyglotte.</strong> Fort d'une carrière de 34 ans bâtie dans les achats internationaux et l'expatriation globale, Alexandre met à profit son expertise stratégique pour diriger <strong>Low Cost Web Agency</strong> et offrir des solutions digitales haute performance.
</p>
</div></div></section>
<section id="recent-posts-2" class="widget widget_recent_entries" style="border-style: solid;border-color:transparent;border-width:0px;">
<div class="heading"><h4 class="widget-title">Articles récents</h4></div>
<ul>
<li>
<a href="https://www.lowcostwebagency.com/fr/redaction-ia-boostez-la-visibilite/">Magie du contenu ai : amplify la visibilité de votre site avec des scribes automatiques</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/meta-descriptions-ia-le-secret/">Descripteurs métas conçus par ia : le secret pour une visibilité immédiate</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/contenu-ia-lavenir-du-seo/">Contenu ai : l’avenir de la référencement et de la maîtrise du design web</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/descripteurs-metas-powered-ai-pour/">Descripteurs métas powered ai pour une visibilité immédiate</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/web-design-ia-des-layouts/">Révolutionnant le design web : des maquettes ia pour convertir les visiteurs en clients</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/revolutionnez-votre-site-web-grace/" aria-current="page">Révolutionnez votre site web avec des techniques d’optimisation du contenu basées sur l’intelligence artificielle</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/loptimisation-seo-alimentee-par-lintelligence-artificielle-automatisez-loptimisation-des-motscles-pour-maximiser-la-visibilite/">L’optimisation seo alimentée par l’intelligence artificielle : automatisez l’optimisation des mots-clés pour maximiser la visibilité</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/comment-lia-revolutionne-la-creation/">Comment l’IA transforme la création de contenu dans divers secteurs industriels</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/nouveau-bmw-ix5-lelectrique-defie/">Le nouveau ix5 de bmw met l’accent sur le conduite électrique face aux rivaux chinois</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/ia-la-nouvelle-politique-de/">Un Changement De Politique En Matière d’IA Chez Google Suscite Un Débat</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/amazon-fin-des-nda-pour/">Amazon Abandonne Les Ndas Pour Plus De Transparence Sur Ses Centres De Données</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/artistes-ia-en-roue-libre/">Les Artistes Ai Se Livrent : Peintures Issues Du Code</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/lia-vocale-fait-revivre-les/">Des Interprètes Vocaux Alimentés Par L’intelligence Artificielle Donnent Vie Aux Classiques Du Cinéma</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/play-dos-fait-revivre-les-grands-classiques-du-jeu-video-des-annees-90-pour-des-experimentations-modernes-en-intelligence-artificielle/">Play-dos fait revivre les grands classiques du jeu vidéo des années 90 pour des expérimentations modernes en intelligence artificielle</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/failles-nextcloud-comment-tuta-contourne/">Tuta contourne IMAP pour exploiter les failles de sécurité de Nextcloud</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/la-nouvelle-fonctionnalite-de-securite-dapple-pour-mac-bloque-lacces-a-lia/">La nouvelle fonctionnalité de sécurité d’Apple pour Mac bloque l’accès à l’IA</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/les-gadgets-ia-de-meta-arrivent-bientot-dans-un-magasin-pres-de-chez-vous/">Les gadgets IA de Meta arrivent bientôt dans un magasin près de chez vous</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/le-nouvel-algorithme-de-netflix-pourrait-revolutionner-votre-experience-de-visionnage/">Le nouvel algorithme de Netflix pourrait révolutionner votre expérience de visionnage</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/letat-de-lagence-web-aujourdhui-une-plongee-globale-dans-la-strategie-lia-et-la-croissance/">L’état de l’agence Web aujourd’hui – Une plongée globale dans la stratégie, l’IA et la croissance</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/comment-bien-choisir-son-hebergement/">Comment bien choisir son hébergement ?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/pondicherry-je-taime-la-collection-des-amoureux-de-pondicherry/">Pondicherry je t’aime – La collection des amoureux de Pondicherry</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/comment-preparer-sa-societe-pour-le-metaverse/">Comment préparer son entreprise au Metaverse ?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/23-outils-de-referencement-puissants-pour-les-petites-et-moyennes-entreprises-en-2026/">23 outils de référencement puissants pour les petites et moyennes entreprises</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/seo-tips-for-google/">Conseils Seo pour Google</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/creer-son-site-internet/">Comment créer son site Internet : Votre guide complet</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/est-ce-que-chatgpt-va-changer-le-seo-pour-toujours/">Est-ce que ChatGPT va changer le SEO pour toujours ?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/20-plugins-wordpress/">20 plugins WordPress à utiliser</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/penurie-informatique-ukraine-russie-pas-cher/">Pénurie de profils informatiques | Guerre entre l’Ukraine et la Russie | Low Cost Web Agency vous aide !</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/quelles-sont-les-couleurs-qui-conviennent-le-mieux-a-votre-entreprise/">Quelles sont les couleurs qui conviennent le mieux à votre entreprise?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/comment-fonctionnent-les-escroqueries-en-ligne-et-8-etapes-pour-les-eviter/">Comment fonctionnent les escroqueries en ligne et 8 étapes pour les éviter</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/comment-lautomatisation-du-marketing-peut-aider-votre-entreprise-a-se-developper/">Comment l’automatisation du marketing peut aider votre entreprise à se développer</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/10-themes-wordpress-populaires-en-2026/">10 thèmes WordPress populaires</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/21-etapes-reussir-marketing-entreprise/">Liste de contrôle marketing en 21 étapes pour les nouvelles entreprises</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/5-meilleurs-themes-wordpress-de-themeforest/">5 meilleurs thèmes WordPress de ThemeForest</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/6-meilleurs-builders-wordpress/">6 meilleurs constructeurs de pages WordPress</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/tout-ce-que-vous-devez-savoir-sur-les-serp/">Tout ce que vous devez savoir sur les SERP</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/quels-sont-les-outils-et-les-techniques-doptimisation-des-couts-et-de-la-valeur/">Quels sont les outils et les techniques d’optimisation des coûts et de la valeur ?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/low-cost-web-agency-canada-le-plagiat-et-le-cybersquatting/">Low Cost Web agency Canada, le plagiat et le cybersquatting</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/site-web-entreprise/">Pourquoi avez-vous besoin d’un site Web pour votre activité ?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/comment-les-medias-sociaux-sont-ils-utilises-pour-le-marketing-et-les-affaires/">Comment les médias sociaux sont-ils utilisés pour le marketing et les affaires ?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/quel-est-limpact-de-la-typographie-sur-le-design-et-le-marketing/">Quel est l’impact de la typographie sur le design et le marketing ?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/joli-logo/">Qu’est-ce qu’un joli logo ?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/pourquoi-wix-nest-pas-une-bonne-idee/">Pourquoi WIX n’est pas une bonne idée?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/top-7-plugins-sauvegarde-restauration-wordpress/">Les 7 meilleurs plugins de sauvegarde et restauration WordPress</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/e-commerce-14-etapes-pour-vous-lancer/">E-commerce : 14 étapes pour vous lancer</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/decouvrez-combien-coute-un-nom-de-domaine/">Combien coûte un nom de domaine ?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/wpml-est-il-le-meilleur-plugin-wordpress-pour-les-sites-web-multilingues/">WPML est-il le meilleur plugin WordPress pour les sites Web multilingues ?</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/impacts-du-rgpd-sur-le-seo/">Impacts du RGPD sur le SEO</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/top-des-solutions-lms-wordpress/">Top des solutions LMS WordPress</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/donnez-un-nouveau-souffle-a-votre-entreprise-avec-un-rebranding/">Donnez un nouveau souffle à votre entreprise avec un rebranding</a>
</li>
<li>
<a href="https://www.lowcostwebagency.com/fr/rank-math-ou-yoast-seo-2026-gagnant/">Rank Math ou Yoast SEO ? Quel plugin WordPress pour le SEO de votre site Web en 2026 ?</a>
</li>
</ul>
</section><section id="woocommerce_product_categories-2" class="widget woocommerce widget_product_categories" style="border-style: solid;border-color:transparent;border-width:0px;"><div class="heading"><h4 class="widget-title">Categories</h4></div><ul class="product-categories"><li class="cat-item cat-item-1145"><a href="https://www.lowcostwebagency.com/fr/low-cost/impression/affiche/">Affiche</a></li>
<li class="cat-item cat-item-1161"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/audit-analyse/">Audit & Analyse</a></li>
<li class="cat-item cat-item-1164"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/audit-analyse/audit-seo/">Audit SEO</a></li>
<li class="cat-item cat-item-1181"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/design-fr/bannieres/">Bannières</a></li>
<li class="cat-item cat-item-1167"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-de-contenu/blog-redaction-darticles/">Blog - Rédaction d'articles</a></li>
<li class="cat-item cat-item-1137"><a href="https://www.lowcostwebagency.com/fr/low-cost/impression/brochure-fr/">Brochure</a></li>
<li class="cat-item cat-item-1175"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/sem-fr/campagne-facebook/">Campagne Facebook</a></li>
<li class="cat-item cat-item-1176"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/sem-fr/campagne-google-adwords/">Campagne Google Adwords</a></li>
<li class="cat-item cat-item-1177"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/sem-fr/campagne-linkedin/">Campagne LinkedIn</a></li>
<li class="cat-item cat-item-1138"><a href="https://www.lowcostwebagency.com/fr/low-cost/impression/cartes-de-visite/">Cartes de visite</a></li>
<li class="cat-item cat-item-1140"><a href="https://www.lowcostwebagency.com/fr/low-cost/impression/papeterie-pour-votre-entreprise/certificats/">Certificats</a></li>
<li class="cat-item cat-item-1159"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/site-web-et-page/cms-site-web-dynamique-wordpress-joomla-drupal/">CMS - Site Web dynamique | Wordpress | Joomla | Drupal</a></li>
<li class="cat-item cat-item-1168"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-de-contenu/communique-de-presse/">Communiqué de presse</a></li>
<li class="cat-item cat-item-1169"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-de-contenu/correction/">Correction</a></li>
<li class="cat-item cat-item-1152"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/design-fr/design-de-diaporama/">Création de Diaporama</a></li>
<li class="cat-item cat-item-1155"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/site-web-et-page/crm-fr/">CRM</a></li>
<li class="cat-item cat-item-1170"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-de-contenu/cv-lettre-de-presentation-bio-linkedin/">CV - Lettre de présentation - Bio Linkedin</a></li>
<li class="cat-item cat-item-1131"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/design-fr/">Design</a></li>
<li class="cat-item cat-item-1151"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/design-fr/design-de-logo/">Design de Logo</a></li>
<li class="cat-item cat-item-1130"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/">Design Web</a></li>
<li class="cat-item cat-item-1156"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/site-web-et-page/developpement-debugging/">Développement & Debugging</a></li>
<li class="cat-item cat-item-1149"><a href="https://www.lowcostwebagency.com/fr/low-cost/digital-signature-fr/">Digital Signature</a></li>
<li class="cat-item cat-item-1134"><a href="https://www.lowcostwebagency.com/fr/low-cost/hosting-and-domain-fr/domains-fr/">Domains</a></li>
<li class="cat-item cat-item-1157"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/site-web-et-page/website-ecommerce/">E-Commerce</a></li>
<li class="cat-item cat-item-1150"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/design-fr/edition-dimages-docs/">Édition d'Images & Docs</a></li>
<li class="cat-item cat-item-1153"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/design-fr/edition-de-videos/">Édition de vidéos</a></li>
<li class="cat-item cat-item-1172"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-email/">Email Marketing</a></li>
<li class="cat-item cat-item-1141"><a href="https://www.lowcostwebagency.com/fr/low-cost/impression/papeterie-pour-votre-entreprise/enveloppes/">Enveloppes</a></li>
<li class="cat-item cat-item-1142"><a href="https://www.lowcostwebagency.com/fr/low-cost/impression/papeterie-pour-votre-entreprise/factures/">Factures</a></li>
<li class="cat-item cat-item-1144"><a href="https://www.lowcostwebagency.com/fr/low-cost/impression/flyers-depliants/">Flyers / Dépliants</a></li>
<li class="cat-item cat-item-1179"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-des-reseaux-sociaux/gestion-des-comptes-de-reseaux-sociaux/">Gestion de vos réseaux sociaux</a></li>
<li class="cat-item cat-item-1162"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/audit-analyse/analytics-google/">Google Analytics</a></li>
<li class="cat-item cat-item-1135"><a href="https://www.lowcostwebagency.com/fr/low-cost/hosting-and-domain-fr/hosting-fr/">Hébergement</a></li>
<li class="cat-item cat-item-1132"><a href="https://www.lowcostwebagency.com/fr/low-cost/hosting-and-domain-fr/">Hébergement & Domaines</a></li>
<li class="cat-item cat-item-1158"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/site-web-et-page/html-design-statique/">HTML & Design statique</a></li>
<li class="cat-item cat-item-1136"><a href="https://www.lowcostwebagency.com/fr/low-cost/impression/">Impression</a></li>
<li class="cat-item cat-item-1166"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-de-contenu/">Marketing de contenu</a></li>
<li class="cat-item cat-item-1178"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-des-reseaux-sociaux/">Marketing des Réseaux sociaux</a></li>
<li class="cat-item cat-item-1160"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/">Marketing Web</a></li>
<li class="cat-item cat-item-1795"><a href="https://www.lowcostwebagency.com/fr/low-cost/non-classe/">Non classé</a></li>
<li class="cat-item cat-item-1139"><a href="https://www.lowcostwebagency.com/fr/low-cost/impression/papeterie-pour-votre-entreprise/">Papeterie d'entreprise</a></li>
<li class="cat-item cat-item-1143"><a href="https://www.lowcostwebagency.com/fr/low-cost/impression/papeterie-pour-votre-entreprise/papier-a-en-tete/">Papier à en-tête</a></li>
<li class="cat-item cat-item-1174"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/sem-fr/plan-personnalise/">Plan de Com' personnalisé</a></li>
<li class="cat-item cat-item-1133"><a href="https://www.lowcostwebagency.com/fr/low-cost/composite-products-fr/">Produits composites</a></li>
<li class="cat-item cat-item-1163"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/audit-analyse/recherche-de-mots-cles/">Recherche de mots-clés</a></li>
<li class="cat-item cat-item-1148"><a href="https://www.lowcostwebagency.com/fr/low-cost/securite/sauvegarde-de-site-web/">Sauvegarde de site Web</a></li>
<li class="cat-item cat-item-1173"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/sem-fr/">Search Engine Marketing</a></li>
<li class="cat-item cat-item-1146"><a href="https://www.lowcostwebagency.com/fr/low-cost/securite/">Sécurité</a></li>
<li class="cat-item cat-item-1147"><a href="https://www.lowcostwebagency.com/fr/low-cost/securite/securite-et-elimination-des-logiciels-malveillants/">Sécurité et élimination des logiciels malveillants</a></li>
<li class="cat-item cat-item-1154"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/site-web-et-page/">Sites Web et pages Html</a></li>
<li class="cat-item cat-item-1180"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-des-reseaux-sociaux/social-media-promotion-fr/">Social Media Promotion</a></li>
<li class="cat-item cat-item-1165"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/audit-analyse/strategie-de-marketing-web/">Stratégie de marketing Web</a></li>
<li class="cat-item cat-item-1171"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-de-contenu/traduction/">Traduction</a></li>
<li class="cat-item cat-item-1194"><a href="https://www.lowcostwebagency.com/fr/low-cost/uncategorized-fr/">Uncategorized @fr</a></li>
</ul></section><section id="text-7" class="widget widget_text"> <div class="textwidget"><div class="fusion-image-element" style="text-align:center;--awb-liftup-border-radius:0px;--awb-caption-title-font-family:var(--h2_typography-font-family);--awb-caption-title-font-weight:var(--h2_typography-font-weight);--awb-caption-title-font-style:var(--h2_typography-font-style);--awb-caption-title-size:var(--h2_typography-font-size);--awb-caption-title-transform:var(--h2_typography-text-transform);--awb-caption-title-line-height:var(--h2_typography-line-height);--awb-caption-title-letter-spacing:var(--h2_typography-letter-spacing);"><div class="awb-image-frame awb-image-frame-1 imageframe-liftup"><span class="fusion-imageframe imageframe-none imageframe-1"><a class="fusion-no-lightbox" href="http://avada.theme-fusion.com/classic-shop/women/" target="_self"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" decoding="async" data-src="http://avada.theme-fusion.com/classic-shop/wp-content/uploads/sites/48/2015/12/promotion_women_img.jpg" alt class="img-responsive"/></a></span></div></div></div>
</section> </aside>
</div> <!-- fusion-row -->
</main> <!-- #main -->
<div class="fusion-footer">
<footer class="fusion-footer-widget-area fusion-widget-area">
<div class="fusion-row">
<div class="fusion-columns fusion-columns-5 fusion-widget-area">
<div class="fusion-column col-lg-2 col-md-2 col-sm-2">
<section id="pyre_tabs-widget-2" class="fusion-footer-widget-column widget fusion-tabs-widget" style="border-style: solid;border-color:transparent;border-width:0px;"> <div class="fusion-tabs-widget-wrapper fusion-tabs-widget-2 fusion-tabs-clean fusion-tabs-image-circle tab-holder">
<nav class="fusion-tabs-nav">
<ul class="tabset tabs">
<li class="active"><a href="#" data-link="fusion-tab-popular">En vedette</a></li>
<li><a href="#" data-link="fusion-tab-recent">Récent</a></li>
</ul>
</nav>
<div class="fusion-tabs-widget-content tab-box tabs-container">
<div class="fusion-tab-popular fusion-tab-content tab tab_content" data-name="fusion-tab-popular">
<ul class="fusion-tabs-widget-items news-list">
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/wpml-est-il-le-meilleur-plugin-wordpress-pour-les-sites-web-multilingues/" aria-label="WPML est-il le meilleur plugin WordPress pour les sites Web multilingues ?"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2022/06/WPML-Image-Redesign1200-600-66x66.png" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="Refonte de l'image WPML" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2022/06/WPML-Image-Redesign1200-600-66x66.png 66w, https://www.lowcostwebagency.com/wp-content/uploads/2022/06/WPML-Image-Redesign1200-600-100x100.png 100w, https://www.lowcostwebagency.com/wp-content/uploads/2022/06/WPML-Image-Redesign1200-600-150x150.png 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="WPML est-il le meilleur plugin WordPress pour les sites Web multilingues ?"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/wpml-est-il-le-meilleur-plugin-wordpress-pour-les-sites-web-multilingues/">WPML est-il le meilleur plugin WordPress pour les sites Web multilingues ?</a>
<div class="fusion-meta">
décembre 29th, 2024 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/e-commerce-14-etapes-pour-vous-lancer/" aria-label="E-commerce : 14 étapes pour vous lancer"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2022/09/Sans-titre-2-66x66.png" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="e-commerce" decoding="async" title="E-commerce : 14 étapes pour vous lancer"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/e-commerce-14-etapes-pour-vous-lancer/">E-commerce : 14 étapes pour vous lancer</a>
<div class="fusion-meta">
janvier 9th, 2025 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/site-web-entreprise/" aria-label="Pourquoi avez-vous besoin d’un site Web pour votre activité ?"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2025/06/why-your-business-needs-a-website-2026-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="Un affichage holographique futuriste montrant l'IA et la croissance des entreprises, illustrant pourquoi votre entreprise a besoin d'un site web en 2026." decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2025/06/why-your-business-needs-a-website-2026-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2025/06/why-your-business-needs-a-website-2026-scaled-100x100.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2025/06/why-your-business-needs-a-website-2026-150x150.webp 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="Pourquoi avez-vous besoin d'un site Web pour votre activité ?"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/site-web-entreprise/">Pourquoi avez-vous besoin d’un site Web pour votre activité ?</a>
<div class="fusion-meta">
mars 30th, 2025 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/21-etapes-reussir-marketing-entreprise/" aria-label="Liste de contrôle marketing en 21 étapes pour les nouvelles entreprises"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2022/07/firmbee-com-gcsNOsPEXfs-unsplash-66x66.jpg" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="marketing checklist" decoding="async" title="Liste de contrôle marketing en 21 étapes pour les nouvelles entreprises"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/21-etapes-reussir-marketing-entreprise/">Liste de contrôle marketing en 21 étapes pour les nouvelles entreprises</a>
<div class="fusion-meta">
mai 11th, 2025 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/rank-math-ou-yoast-seo-2026-gagnant/" aria-label="Rank Math ou Yoast SEO ? Quel plugin WordPress pour le SEO de votre site Web en 2026 ?"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2022/05/Image-Rank-Math-ou-Yoast-SEO-Quel-plugin-Worpress-choisir-pour-le-SEO-de-votre-site-Web-2-66x66.png" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="Rank Math ou Yoast SEO Quel plugin Worpress choisir pour le SEO de votre site Web" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2022/05/Image-Rank-Math-ou-Yoast-SEO-Quel-plugin-Worpress-choisir-pour-le-SEO-de-votre-site-Web-2-66x66.png 66w, https://www.lowcostwebagency.com/wp-content/uploads/2022/05/Image-Rank-Math-ou-Yoast-SEO-Quel-plugin-Worpress-choisir-pour-le-SEO-de-votre-site-Web-2-100x100.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2022/05/Image-Rank-Math-ou-Yoast-SEO-Quel-plugin-Worpress-choisir-pour-le-SEO-de-votre-site-Web-2-150x150.png 150w, https://www.lowcostwebagency.com/wp-content/uploads/2022/05/Image-Rank-Math-ou-Yoast-SEO-Quel-plugin-Worpress-choisir-pour-le-SEO-de-votre-site-Web-2-200x200.png 200w" data-sizes="(max-width: 66px) 100vw, 66px" title="Rank Math ou Yoast SEO ? Quel plugin Wordpress pour le SEO de votre site Web en 2026 ?"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/rank-math-ou-yoast-seo-2026-gagnant/">Rank Math ou Yoast SEO ? Quel plugin WordPress pour le SEO de votre site Web en 2026 ?</a>
<div class="fusion-meta">
octobre 9th, 2024 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/seo-tips-for-google/" aria-label="Conseils Seo pour Google"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2017/12/Google-SEO-700-x-441-66x66.jpg" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="Google SEO - Low Cost Web Agency" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2017/12/Google-SEO-700-x-441-66x66.jpg 66w, https://www.lowcostwebagency.com/wp-content/uploads/2017/12/Google-SEO-700-x-441-100x100.jpg 100w, https://www.lowcostwebagency.com/wp-content/uploads/2017/12/Google-SEO-700-x-441-150x150.jpg 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="Conseils Seo pour Google"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/seo-tips-for-google/">Conseils Seo pour Google</a>
<div class="fusion-meta">
juin 30th, 2025 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/23-outils-de-referencement-puissants-pour-les-petites-et-moyennes-entreprises-en-2026/" aria-label="23 outils de référencement puissants pour les petites et moyennes entreprises"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2022/11/Best-SEO-plugins-for-WP-66x66.png" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="Meilleurs plugins SEO pour WP" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2022/11/Best-SEO-plugins-for-WP-66x66.png 66w, https://www.lowcostwebagency.com/wp-content/uploads/2022/11/Best-SEO-plugins-for-WP-100x100.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2022/11/Best-SEO-plugins-for-WP-150x150.png 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="23 outils de référencement puissants pour les petites et moyennes entreprises"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/23-outils-de-referencement-puissants-pour-les-petites-et-moyennes-entreprises-en-2026/">23 outils de référencement puissants pour les petites et moyennes entreprises</a>
<div class="fusion-meta">
juillet 20th, 2025 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/donnez-un-nouveau-souffle-a-votre-entreprise-avec-un-rebranding/" aria-label="Donnez un nouveau souffle à votre entreprise avec un rebranding"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2022/05/tutorial-redesign-page-lcwa1200-600-66x66.png" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="tutorial redesign page lcwa" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2022/05/tutorial-redesign-page-lcwa1200-600-66x66.png 66w, https://www.lowcostwebagency.com/wp-content/uploads/2022/05/tutorial-redesign-page-lcwa1200-600-100x100.png 100w, https://www.lowcostwebagency.com/wp-content/uploads/2022/05/tutorial-redesign-page-lcwa1200-600-150x150.png 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="Donnez un nouveau souffle à votre entreprise avec un rebranding"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/donnez-un-nouveau-souffle-a-votre-entreprise-avec-un-rebranding/">Donnez un nouveau souffle à votre entreprise avec un rebranding</a>
<div class="fusion-meta">
octobre 29th, 2024 </div>
</div>
</li>
</ul>
</div>
<div class="fusion-tab-recent fusion-tab-content tab tab_content" data-name="fusion-tab-recent" style="display: none;">
<ul class="fusion-tabs-widget-items news-list">
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/redaction-ia-boostez-la-visibilite/" aria-label="Magie du contenu ai : amplify la visibilité de votre site avec des scribes automatiques"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="AI-driven copywriter wizard increases site visibility rapidly" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-150x150.webp 150w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-content-magic-instantly-boost-200x200.webp 200w" data-sizes="(max-width: 66px) 100vw, 66px" title="Magie du contenu ai : amplify la visibilité de votre site avec des scribes automatiques"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/redaction-ia-boostez-la-visibilite/">Magie du contenu ai : amplify la visibilité de votre site avec des scribes automatiques</a>
<div class="fusion-meta">
octobre 11th, 2026 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/meta-descriptions-ia-le-secret/" aria-label="Descripteurs métas conçus par ia : le secret pour une visibilité immédiate"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="AI-generated metadata for enhanced online visibility" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-100x100.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-meta-descriptors-the-secret-150x150.webp 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="Descripteurs métas conçus par ia : le secret pour une visibilité immédiate"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/meta-descriptions-ia-le-secret/">Descripteurs métas conçus par ia : le secret pour une visibilité immédiate</a>
<div class="fusion-meta">
octobre 10th, 2026 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/contenu-ia-lavenir-du-seo/" aria-label="Contenu ai : l’avenir de la référencement et de la maîtrise du design web"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="AI-generated content for SEO and web design success" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-150x150.webp 150w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aicrafted-content-the-future-of-200x200.webp 200w" data-sizes="(max-width: 66px) 100vw, 66px" title="Contenu ai : l'avenir de la référencement et de la maîtrise du design web"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/contenu-ia-lavenir-du-seo/">Contenu ai : l’avenir de la référencement et de la maîtrise du design web</a>
<div class="fusion-meta">
octobre 9th, 2026 </div>
</div>
</li>
<li>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/descripteurs-metas-powered-ai-pour/">Descripteurs métas powered ai pour une visibilité immédiate</a>
<div class="fusion-meta">
octobre 9th, 2026 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/web-design-ia-des-layouts/" aria-label="Révolutionnant le design web : des maquettes ia pour convertir les visiteurs en clients"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="AI-driven web layouts increasing conversions and sales" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-150x150.webp 150w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-web-design-aipowered-layouts-200x200.webp 200w" data-sizes="(max-width: 66px) 100vw, 66px" title="Révolutionnant le design web : des maquettes ia pour convertir les visiteurs en clients"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/web-design-ia-des-layouts/">Révolutionnant le design web : des maquettes ia pour convertir les visiteurs en clients</a>
<div class="fusion-meta">
octobre 9th, 2026 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/revolutionnez-votre-site-web-grace/" aria-label="Révolutionnez votre site web avec des techniques d’optimisation du contenu basées sur l’intelligence artificielle"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-your-website-with-aipowered-content-optimization-techniques-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="AI-driven content优化提升网站效率示意图" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-your-website-with-aipowered-content-optimization-techniques-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-your-website-with-aipowered-content-optimization-techniques-100x100.webp 100w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/revolutionizing-your-website-with-aipowered-content-optimization-techniques-150x150.webp 150w" data-sizes="(max-width: 66px) 100vw, 66px" title="Révolutionnez votre site web avec des techniques d'optimisation du contenu basées sur l'intelligence artificielle"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/revolutionnez-votre-site-web-grace/">Révolutionnez votre site web avec des techniques d’optimisation du contenu basées sur l’intelligence artificielle</a>
<div class="fusion-meta">
octobre 9th, 2026 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/loptimisation-seo-alimentee-par-lintelligence-artificielle-automatisez-loptimisation-des-motscles-pour-maximiser-la-visibilite/" aria-label="L’optimisation seo alimentée par l’intelligence artificielle : automatisez l’optimisation des mots-clés pour maximiser la visibilité"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="AI-driven SEO tool optimizing keywords for better visibility" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-150x150.webp 150w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/aipowered-seo-automating-keyword-optimization-for-maximum-visibility-200x200.webp 200w" data-sizes="(max-width: 66px) 100vw, 66px" title="L'optimisation seo alimentée par l'intelligence artificielle : automatisez l'optimisation des mots-clés pour maximiser la visibilité"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/loptimisation-seo-alimentee-par-lintelligence-artificielle-automatisez-loptimisation-des-motscles-pour-maximiser-la-visibilite/">L’optimisation seo alimentée par l’intelligence artificielle : automatisez l’optimisation des mots-clés pour maximiser la visibilité</a>
<div class="fusion-meta">
octobre 8th, 2026 </div>
</div>
</li>
<li>
<div class="image">
<a href="https://www.lowcostwebagency.com/fr/comment-lia-revolutionne-la-creation/" aria-label="Comment l’IA transforme la création de contenu dans divers secteurs industriels"><img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" width="66" height="66" data-src="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/how-ai-is-transforming-content-creation-across-industries-66x66.webp" class="attachment-recent-works-thumbnail size-recent-works-thumbnail wp-post-image" alt="AI-driven content creation across industries illustrated" decoding="async" data-srcset="https://www.lowcostwebagency.com/wp-content/uploads/2026/10/how-ai-is-transforming-content-creation-across-industries-66x66.webp 66w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/how-ai-is-transforming-content-creation-across-industries-150x150.webp 150w, https://www.lowcostwebagency.com/wp-content/uploads/2026/10/how-ai-is-transforming-content-creation-across-industries-200x200.webp 200w" data-sizes="(max-width: 66px) 100vw, 66px" title="Comment l'IA transforme la création de contenu dans divers secteurs industriels"></a>
</div>
<div class="post-holder">
<a href="https://www.lowcostwebagency.com/fr/comment-lia-revolutionne-la-creation/">Comment l’IA transforme la création de contenu dans divers secteurs industriels</a>
<div class="fusion-meta">
octobre 8th, 2026 </div>
</div>
</li>
</ul>
</div>
</div>
</div>
<div style="clear:both;"></div></section> </div>
<div class="fusion-column col-lg-2 col-md-2 col-sm-2">
<section id="nav_menu-5" class="fusion-footer-widget-column widget widget_nav_menu" style="border-style: solid;border-color:transparent;border-width:0px;"><h4 class="widget-title">ACHETEZ EN LIGNE</h4><div class="menu-seo-menu-fr-container"><ul id="menu-seo-menu-fr" class="menu"><li id="menu-item-42049" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-42049"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/site-web-et-page/" title="Création de sites Web et développement de pages HTML sur mesure">Sites Web et pages Html</a></li>
<li id="menu-item-48510" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-48510"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/design-fr/" title="Services de design professionnel pour votre présence en ligne">Design</a></li>
<li id="menu-item-30871" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-30871"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/site-web-et-page/" title="Découvrez nos services de design pour sites vitrines, e-commerce et blogs">Design Site Internet | E-commerce | Blog</a></li>
<li id="menu-item-30872" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-30872"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/design-fr/" title="Création d’identité visuelle, conception de logos et bannières web">Design visuel | Logo | Bannières</a></li>
<li id="menu-item-43749" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-43749"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/" title="Solutions complètes de marketing web pour booster votre visibilité">Marketing Web</a></li>
<li id="menu-item-48511" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-48511"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-de-contenu/" title="Stratégies de marketing de contenu pour engager votre audience">Marketing de contenu</a></li>
<li id="menu-item-30873" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-30873"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/" title="Optimisez votre trafic avec nos services de marketing web, SEO et publicité en ligne">Marketing Web | SEO | Publicité</a></li>
<li id="menu-item-48512" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-48512"><a href="https://www.lowcostwebagency.com/fr/low-cost/securite/" title="Protégez votre site internet avec nos solutions de sécurité web avancées">Sécurité</a></li>
<li id="menu-item-31749" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-31749"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-de-contenu/" title="Rédaction d’articles, traductions professionnelles, communiqués de presse et création de CV">Posts / Traductions / Revues de presse / CV / Biographies</a></li>
<li id="menu-item-43750" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-43750"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/audit-analyse/strategie-de-marketing-web/" title="Élaboration de stratégies de marketing web sur mesure pour votre croissance">Stratégie de marketing Web</a></li>
<li id="menu-item-43751" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-43751"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-email/" title="Création et gestion de campagnes d’email marketing performantes">Email Marketing</a></li>
<li id="menu-item-48513" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-48513"><a href="https://www.lowcostwebagency.com/fr/low-cost/marketing-web/marketing-des-reseaux-sociaux/" title="Développez votre communauté avec notre expertise en marketing des réseaux sociaux">Marketing des Réseaux sociaux</a></li>
<li id="menu-item-43758" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-43758"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/site-web-et-page/developpement-debugging/" title="Services d’experts en développement web et résolution de bugs (debugging)">Développement & Debugging</a></li>
<li id="menu-item-43759" class="menu-item menu-item-type-taxonomy menu-item-object-product_cat menu-item-43759"><a href="https://www.lowcostwebagency.com/fr/low-cost/design-web/site-web-et-page/website-ecommerce/" title="Création et optimisation de boutiques en ligne e-commerce performantes">E-Commerce</a></li>
</ul></div><div style="clear:both;"></div></section> </div>
<div class="fusion-column col-lg-2 col-md-2 col-sm-2">
<section id="nav_menu-6" class="fusion-footer-widget-column widget widget_nav_menu" style="border-style: solid;border-color:transparent;border-width:0px;"><h4 class="widget-title">NOTRE DIFFÉRENCE</h4><div class="menu-notre-difference-container"><ul id="menu-notre-difference" class="menu"><li id="menu-item-43309" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43309"><a href="https://www.lowcostwebagency.com/fr/faqs/qui-est-low-cost-web-agency/">Qui est Low Cost Web Agency ?</a></li>
<li id="menu-item-48514" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48514"><a href="https://www.lowcostwebagency.com/fr/faqs/qui-est-low-cost-web-agency/">Qui est Low Cost Web Agency ?</a></li>
<li id="menu-item-43761" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43761"><a href="https://www.lowcostwebagency.com/fr/faqs/garantie-du-meilleur-prix-vraiment-comment-ca-marche/">Garantie du meilleur prix…. Vraiment ? Comment ça marche ?</a></li>
<li id="menu-item-43762" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43762"><a href="https://www.lowcostwebagency.com/fr/faqs/puis-je-savoir-ce-qui-est-inclus-dans-votre-garantie-vie/">Puis-je savoir ce qui est inclus dans votre garantie à vie ?</a></li>
<li id="menu-item-43312" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43312"><a href="https://www.lowcostwebagency.com/fr/faqs/est-ce-que-je-serai-proprietaire-du-produit-fini/">Pas de surcoûts, pas de mauvaise surprise</a></li>
<li id="menu-item-48515" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48515"><a href="https://www.lowcostwebagency.com/fr/faqs/est-ce-que-vos-prix-incluent-les-taxes-y-t-il-des-surcouts/">Vos prix incluent-ils les taxes? Y a-t-il des frais cachés ?</a></li>
<li id="menu-item-43809" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43809"><a href="https://www.lowcostwebagency.com/fr/faqs/pourquoi-ai-je-besoin-dun-hebergeur-et-quelles-sont-vos-propositions/">Pourquoi ai-je besoin d’un hébergeur et quelles sont vos propositions ?</a></li>
<li id="menu-item-48516" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48516"><a href="https://www.lowcostwebagency.com/fr/faqs/est-ce-que-je-serai-proprietaire-du-produit-fini/">Est-ce que je serai propriétaire du produit fini ?</a></li>
<li id="menu-item-43314" class="menu-item menu-item-type-post_type menu-item-object-page menu-item-43314"><a href="https://www.lowcostwebagency.com/fr/portfolio/">Portfolio & Témoignages</a></li>
<li id="menu-item-43810" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43810"><a href="https://www.lowcostwebagency.com/fr/faqs/quel-type-dassistance-de-maintenance-et-de-garantie-donnez-vous-avec-vos-services-dhebergement/">Assistance, maintenance, garantie à vie avec votre hébrgement</a></li>
<li id="menu-item-43313" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43313"><a href="https://www.lowcostwebagency.com/fr/faqs/que-se-passe-t-il-apres-ma-commande/">Que se passe-t-il après ma commande ?</a></li>
<li id="menu-item-48517" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48517"><a href="https://www.lowcostwebagency.com/fr/faqs/puis-je-voir-des-exemples-de-modeles-de-sites-web/">Puis-je voir des exemples de modèles de sites Web ?</a></li>
<li id="menu-item-48518" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48518"><a href="https://www.lowcostwebagency.com/fr/faqs/wordpress-vs-joomla-vs-drupal-quel-cms-est-le-meilleur/">WordPress Vs. Joomla Vs. Drupal ? Quel CMS est le meilleur ?</a></li>
<li id="menu-item-48519" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48519"><a href="https://www.lowcostwebagency.com/fr/faqs/garantie-du-meilleur-prix-vraiment-comment-ca-marche/">Garantie du meilleur prix…. Vraiment ? Comment ça marche ?</a></li>
<li id="menu-item-48520" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48520"><a href="https://www.lowcostwebagency.com/fr/faqs/puis-je-savoir-ce-qui-est-inclus-dans-votre-garantie-vie/">Puis-je savoir ce qui est inclus dans votre garantie à vie ?</a></li>
</ul></div><div style="clear:both;"></div></section> </div>
<div class="fusion-column col-lg-2 col-md-2 col-sm-2">
<section id="nav_menu-7" class="fusion-footer-widget-column widget widget_nav_menu" style="border-style: solid;border-color:transparent;border-width:0px;"><h4 class="widget-title">INFORMATIONS / FAQS</h4><div class="menu-info-menu-fr-container"><ul id="menu-info-menu-fr" class="menu"><li id="menu-item-42164" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-42164"><a href="https://www.lowcostwebagency.com/fr/faqs/ou-puis-je-trouver-vos-conditions-generales/">Nos conditions générales de vente ?</a></li>
<li id="menu-item-43769" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43769"><a href="https://www.lowcostwebagency.com/fr/faqs/comment-et-quand-dois-je-payer-vos-services-faites-vous-des-remboursements/">Comment puis-je payer vos services ?</a></li>
<li id="menu-item-32429" class="menu-item menu-item-type-post_type menu-item-object-page menu-item-32429"><a href="https://www.lowcostwebagency.com/fr/conditions-dutilisation/">Nos conditions d’utilisation</a></li>
<li id="menu-item-30899" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-30899"><a href="https://www.lowcostwebagency.com/fr/faqs/avez-vous-une-politique-dutilisation-equitable-de-vos-services-dhebergement/">Politique d’hébérgement</a></li>
<li id="menu-item-43770" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43770"><a href="https://www.lowcostwebagency.com/fr/faqs/avez-vous-une-politique-dutilisation-equitable-de-vos-services-dhebergement/">Utilisation “raisonnable” de l’hébergement ?</a></li>
<li id="menu-item-48544" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48544"><a href="https://www.lowcostwebagency.com/fr/faqs/utilisez-vous-des-modeles-premium/">Utilisez-vous des modèles premium ?</a></li>
<li id="menu-item-48545" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48545"><a href="https://www.lowcostwebagency.com/fr/faqs/combien-de-contenu-vous-allez-ajouter-dans-mon-site-web-articles-posts-produits-photos/">Est-ce que les contenus sont compris avec mon site Web ? Articles, Posts, Produits, Photos ?</a></li>
<li id="menu-item-43811" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43811"><a href="https://www.lowcostwebagency.com/fr/faqs/pourquoi-low-cost-web-agency-est-il-le-choix-intelligent/">Agence web pas chère et sites à petits prix</a></li>
<li id="menu-item-48546" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48546"><a href="https://www.lowcostwebagency.com/fr/faqs/quest-ce-quune-ip-dediee-est-ce-que-jen-ai-besoin/">Qu’est-ce qu’une IP dédiée ? Est-ce que j’en ai besoin ?</a></li>
<li id="menu-item-43812" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43812"><a href="https://www.lowcostwebagency.com/fr/faqs/pourquoi-ai-je-besoin-dun-nom-de-domaine-et-comment-puis-je-en-enregistrer-un/">Noms de domaine</a></li>
<li id="menu-item-48547" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-48547"><a href="https://www.lowcostwebagency.com/fr/faqs/quel-type-dassistance-de-maintenance-et-de-garantie-donnez-vous-avec-vos-services-dhebergement/">Quel type d’assistance, de maintenance et de garantie donnez-vous avec vos services d’hébergement ?</a></li>
<li id="menu-item-43813" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43813"><a href="https://www.lowcostwebagency.com/fr/faqs/ai-je-besoin-dun-certificat-ssl-quest-ce-que-cest/">Certificats SSL</a></li>
<li id="menu-item-30901" class="menu-item menu-item-type-post_type menu-item-object-page menu-item-30901"><a href="https://www.lowcostwebagency.com/fr/contactez-nous/">Contactez-nous</a></li>
<li id="menu-item-43814" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43814"><a href="https://www.lowcostwebagency.com/fr/faqs/quest-ce-quune-ip-dediee-est-ce-que-jen-ai-besoin/">Adresse IP dédiée</a></li>
<li id="menu-item-43815" class="menu-item menu-item-type-post_type menu-item-object-ufaq menu-item-43815"><a href="https://www.lowcostwebagency.com/fr/faqs/quels-sont-les-elements-que-je-dois-vous-donner-pour-mon-site-web-et-comment-les-soumettre/">Les éléments pour la réalisation de votre site web</a></li>
</ul></div><div style="clear:both;"></div></section> </div>
<div class="fusion-column fusion-column-last col-lg-2 col-md-2 col-sm-2">
<section id="custom_html-4" class="widget_text fusion-footer-widget-column widget widget_custom_html" style="border-style: solid;border-color:transparent;border-width:0px;"><h4 class="widget-title">VOTRE DEVIS GRATUIT SOUS 24H</h4><div class="textwidget custom-html-widget"><div class="footer-form-intro" style="margin-bottom:20px;font-size:14px;line-height:1.6;color:#dddddd;">
<p>Prêt à dynamiser votre présence en ligne ? Parlez-nous de votre projet ci-dessous. Notre équipe conçoit des solutions web d'excellence à des tarifs compétitifs pour propulser votre activité. Réponse garantie sous 24h.</p>
<p style="margin-top:10px;font-size:13px;">
<span style="color:#aaaaaa;">Une urgence ?</span>
<a href="https://wa.me/919786495150?text=Bonjour%20Alex,%20je%20souhaite%20discuter%20d'un%20projet..." target="_blank" rel="noopener noreferrer" style="color:#25D366;font-weight:bold;text-decoration:none;margin-left:5px;">
Contactez-nous sur WhatsApp
</a>
</p>
</div>
<div class="wpcf7 no-js" id="wpcf7-f49834-o1" lang="fr-FR" dir="ltr" data-wpcf7-id="49834">
<div class="screen-reader-response"><p role="status" aria-live="polite" aria-atomic="true"></p> <ul></ul></div>
<form action="/fr/revolutionnez-votre-site-web-grace/#wpcf7-f49834-o1" method="post" class="wpcf7-form init" aria-label="Formulaire de contact" novalidate="novalidate" data-status="init">
<fieldset class="hidden-fields-container"><input type="hidden" name="_wpcf7" value="49834" /><input type="hidden" name="_wpcf7_version" value="6.1.7" /><input type="hidden" name="_wpcf7_locale" value="fr_FR" /><input type="hidden" name="_wpcf7_unit_tag" value="wpcf7-f49834-o1" /><input type="hidden" name="_wpcf7_container_post" value="0" /><input type="hidden" name="_wpcf7_posted_data_hash" value="" /><input type="hidden" name="_wpcf7cf_hidden_group_fields" value="[]" /><input type="hidden" name="_wpcf7cf_hidden_groups" value="[]" /><input type="hidden" name="_wpcf7cf_visible_groups" value="[]" /><input type="hidden" name="_wpcf7cf_repeaters" value="[]" /><input type="hidden" name="_wpcf7cf_steps" value="{}" /><input type="hidden" name="_wpcf7cf_options" value="{"form_id":49834,"conditions":[],"settings":{"animation":"yes","animation_intime":200,"animation_outtime":200,"conditions_ui":"normal","notice_dismissed":false,"repeater_remove_button":"bottom","notice_dismissed_rollback-cf7-5.8.1":true,"notice_dismissed_update-cf7-6.2":true}}" />
</fieldset>
<div class="wpcf7-turnstile cf-turnstile" data-sitekey="0x4AAAAAADHHp2OLRckyMy7w" data-response-field-name="_wpcf7_turnstile_response"></div>
<style>
.footer-contact-form input,
.footer-contact-form textarea {
background-color: #ffffff !important;
color: #333333 !important;
border: 1px solid #cccccc !important;
width: 100% !important;
border-radius: 4px !important;
}
.footer-contact-form input { height: 45px !important; margin-bottom: 10px !important; padding: 0 15px !important; }
.footer-contact-form textarea { height: 100px !important; margin-bottom: 15px !important; padding: 10px 15px !important; }
.footer-contact-form .wpcf7-submit {
background-color: #FFD810 !important;
color: #000000 !important;
font-weight: bold !important;
width: 100% !important;
height: 50px !important;
border: none !important;
border-radius: 4px !important;
cursor: pointer !important;
}
</style>
<div class="footer-contact-form">
<p><span class="wpcf7-form-control-wrap" data-name="your-name"><input size="40" maxlength="400" class="wpcf7-form-control wpcf7-text wpcf7-validates-as-required" aria-required="true" aria-invalid="false" placeholder="*Nom complet" value="" type="text" name="your-name" /></span><br />
<span class="wpcf7-form-control-wrap" data-name="your-email"><input size="40" maxlength="400" class="wpcf7-form-control wpcf7-email wpcf7-validates-as-required wpcf7-text wpcf7-validates-as-email" aria-required="true" aria-invalid="false" placeholder="*Adresse électronique" value="" type="email" name="your-email" /></span><br />
<span class="wpcf7-form-control-wrap" data-name="tel-837"><input size="40" maxlength="400" class="wpcf7-form-control wpcf7-tel wpcf7-validates-as-required wpcf7-text wpcf7-validates-as-tel" aria-required="true" aria-invalid="false" placeholder="*Téléphone (ex : +33 6... / +91...)" value="" type="tel" name="tel-837" /></span><br />
<span class="wpcf7-form-control-wrap" data-name="your-message"><textarea cols="40" rows="2" maxlength="2000" class="wpcf7-form-control wpcf7-textarea" aria-invalid="false" placeholder="Les détails de votre projet..." name="your-message"></textarea></span><br />
<div class="cf7-cf-turnstile" style="margin-top: 0px; margin-bottom: -15px;"> <div id="cf-turnstile-cf7-1051939272" class="cf-turnstile" data-sitekey="0x4AAAAAADHHp2OLRckyMy7w" data-theme="auto" data-language="auto" data-size="flexible" data-retry="auto" data-retry-interval="1000" data-refresh-expired="auto" data-refresh-timeout="auto" data-action="contact-form-7" data-callback="turnstileCF7Callback" data-appearance="always"></div> <style>.wpcf7-submit { pointer-events: none; opacity: 0.5; }</style> <br class="cf-turnstile-br cf-turnstile-br-cf7-1051939272"> </div><br/><input class="wpcf7-form-control wpcf7-submit has-spinner" type="submit" value="Obtenir un devis" />
</p>
</div><p style="display: none !important;" class="akismet-fields-container" data-prefix="_wpcf7_ak_"><label>Δ<textarea name="_wpcf7_ak_hp_textarea" cols="45" rows="8" maxlength="100"></textarea></label><input type="hidden" id="ak_js_1" name="_wpcf7_ak_js" value="59"/><script src="data:text/javascript;base64,ZG9jdW1lbnQuZ2V0RWxlbWVudEJ5SWQoImFrX2pzXzEiKS5zZXRBdHRyaWJ1dGUoInZhbHVlIiwobmV3IERhdGUoKSkuZ2V0VGltZSgpKQ==" defer></script>
</p><div class="fusion-alert alert custom alert-custom fusion-alert-center wpcf7-response-output awb-alert-native-link-color alert-dismissable awb-alert-close-boxed" style="--awb-border-size:1px;--awb-border-top-left-radius:0px;--awb-border-top-right-radius:0px;--awb-border-bottom-left-radius:0px;--awb-border-bottom-right-radius:0px;" role="alert"><div class="fusion-alert-content-wrapper"><span class="fusion-alert-content"></span></div><button type="button" class="close toggle-alert" data-dismiss="alert" aria-label="Close">×</button></div>
</form>
</div>
</div><div style="clear:both;"></div></section> </div>
<div class="fusion-clearfix"></div>
</div> <!-- fusion-columns -->
</div> <!-- fusion-row -->
</footer> <!-- fusion-footer-widget-area -->
<footer id="footer" class="fusion-footer-copyright-area fusion-footer-copyright-center">
<div class="fusion-row">
<div class="fusion-copyright-content">
<div class="fusion-copyright-notice">
<div>
Nous acceptons toutes les principales cartes de crédit : <img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" data-src="/wp-content/uploads/2017/09/paypal_accept.png" width="271" height="27" />
<div style="margin-top: 1%;">
<a href='https://www.lowcostwebagency.com' target='_blank'>
<img data-lazyloaded="1" src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" data-src="/wp-content/uploads/2016/10/footerlcwalogo.png" style="width: 17px;" width="22" height="25" /> Low Cost Web Agency Pvt. Ltd.
</a>
© Copyright 2026 | Tous droits réservés |
<a href="/terms-use" target="_blank">Conditions d'utilisation | </a>
<a href=' https://www.icann.org/fr/contracted-parties/accredited-registrars/registrar-accreditation-agreement/registrant-rights-and-responsibilities-under-the-2009-registrar-accreditation-agreement-27-06-2011-fr ' target='_blank'> ICANN ➔</a>
<a href=' https://www.icann.org/resources/pages/benefits-2017-10-27-fr ' target='_blank'> Conditions</a>
</div> </div>
</div>
<div class="fusion-social-links-footer">
<div class="fusion-social-networks"><div class="fusion-social-networks-wrapper"><a class="fusion-social-network-icon fusion-tooltip fusion-facebook awb-icon-facebook" style data-placement="top" data-title="Facebook" data-toggle="tooltip" title="Facebook" href="https://www.facebook.com/lowcostwebagency" target="_blank" rel="noreferrer nofollow"><span class="screen-reader-text">Facebook</span></a><a class="fusion-social-network-icon fusion-tooltip fusion-linkedin awb-icon-linkedin" style data-placement="top" data-title="LinkedIn" data-toggle="tooltip" title="LinkedIn" href="http://www.linkedin.com/company/low-cost-web-agency-ltd-" target="_blank" rel="noopener noreferrer nofollow"><span class="screen-reader-text">LinkedIn</span></a><a class="fusion-social-network-icon fusion-tooltip fusion-twitter awb-icon-twitter" style data-placement="top" data-title="X" data-toggle="tooltip" title="X" href="https://twitter.com/LOWCOSTCONCEPT" target="_blank" rel="noopener noreferrer nofollow"><span class="screen-reader-text">X</span></a><a class="fusion-social-network-icon fusion-tooltip fusion-youtube awb-icon-youtube" style data-placement="top" data-title="YouTube" data-toggle="tooltip" title="YouTube" href="https://www.youtube.com/user/easyrome73" target="_blank" rel="noopener noreferrer nofollow"><span class="screen-reader-text">YouTube</span></a></div></div></div>
</div> <!-- fusion-fusion-copyright-content -->
</div> <!-- fusion-row -->
</footer> <!-- #footer -->
</div> <!-- fusion-footer -->
<div class="fusion-sliding-bar-wrapper">
<div id="slidingbar-area" class="slidingbar-area fusion-sliding-bar-area fusion-widget-area fusion-sliding-bar-position-right fusion-sliding-bar-text-align-left fusion-sliding-bar-toggle-circle fusion-sliding-bar-sticky fusion-sliding-bar-columns-stacked" data-breakpoint="800" data-toggle="circle">
<div class="fusion-sb-toggle-wrapper">
<a class="fusion-sb-toggle" href="#"><span class="screen-reader-text">Toggle Sliding Bar Area</span></a>
</div>
<div id="slidingbar" class="fusion-sliding-bar">
<div class="fusion-sliding-bar-content-wrapper">
<div class="fusion-sliding-bar-content">
<div class="fusion-column">
<section id="custom_html-10" class="widget_text fusion-slidingbar-widget-column widget widget_custom_html" style="border-style: solid;border-color:transparent;border-width:0px;"><h4 class="widget-title">Rosy Bot</h4><div class="textwidget custom-html-widget"><div class='mwai-chatbot-container' data-params='{"aiName":"AI: ","userName":"User: ","guestName":"Guest:","textSend":"Send","textClear":"Clear","imageUpload":false,"fileUpload":false,"multiUpload":false,"maxUploads":1,"fileUploads":0,"mode":"chat","textInputPlaceholder":"Type your message...","textEmptyHint":"","textInputMaxLength":512,"textCompliance":"","startSentence":"Hi! How can I help you?","localMemory":true,"themeId":"chatgpt","window":false,"icon":"","iconText":"","iconTextDelay":1,"iconTextDuration":0,"iconTextOnce":"session","iconAlt":"AI Engine Chatbot","iconPosition":"bottom-right","centerOpen":false,"width":"","openDelay":"","iconBubble":false,"windowAnimation":"zoom","fullscreen":false,"copyButton":false,"pdfButton":false,"headerSubtitle":"Discuss with","containerType":"standard","headerType":"standard","messagesType":"standard","inputType":"standard","footerType":"standard"}' data-system='{"botId":"default","customId":null,"userData":null,"sessionId":null,"restNonce":null,"contextId":50314,"pluginUrl":"https:\/\/www.lowcostwebagency.com\/wp-content\/plugins\/ai-engine","restUrl":"https:\/\/www.lowcostwebagency.com\/fr\/wp-json","stream":true,"debugMode":false,"eventLogs":false,"speech_recognition":false,"speech_synthesis":false,"typewriter":false,"crossSite":false,"texts":{"Ask me anything!":"Ask me anything!","Jump to the latest message":"Jump to the latest message","Try again":"Try again","Conversation cleared.":"Conversation cleared.","Undo":"Undo","Done!":"Done!","New Chat":"Nouvelle discussion","No messages yet":"Aucun message pour l\u2019instant","Rename":"Renommer","Delete":"Supprimer","Your text was cut at %d characters.":"Your text was cut at %d characters.","Hold to Talk":"Maintenir pour parler","Release to Send":"Release to Send","Press Space to talk":"Press Space to talk","Start session to upload images":"Start session to upload images","Usage limit exceeded":"Usage limit exceeded","Connection failed":"Connection failed","Connection failed. Please check your network and try again.":"Connection failed. Please check your network and try again.","Connection lost. Reconnecting...":"Connection lost. Reconnecting...","Connection lost while uploading image. Please try again.":"Connection lost while uploading image. Please try again.","Connection timeout: The server took too long to respond.":"D\u00e9lai de connexion\u00a0: Le serveur a mis trop de temps \u00e0 r\u00e9pondre.","Could not start realtime session.":"Could not start realtime session.","An error occurred while starting the realtime session.":"An error occurred while starting the realtime session.","An error occurred while processing your request. Please try again.":"Une erreur s\u2019est produite lors du traitement de votre demande. Veuillez r\u00e9essayer.","An error occurred while committing the stats.":"Une erreur s\u2019est produite lors de la validation des statistiques.","An error occurred while committing the discussion.":"Une erreur s\u2019est produite lors de la validation de la discussion.","An error occurred while executing the function.":"Une erreur s\u2019est produite lors de l\u2019ex\u00e9cution de la fonction.","Authentication failed: Your session has expired. Please refresh the page.":"\u00c9chec de l\u2019authentification\u00a0: votre session a expir\u00e9. Veuillez actualiser la page.","Error uploading image. Please try again.":"Error uploading image. Please try again.","Failed to access microphone: ":"Failed to access microphone: ","Failed to access microphone. Please ensure microphone permissions are granted and try again.":"\u00c9chec de l\u2019acc\u00e8s au microphone. Veuillez vous assurer que les droits d\u2019acc\u00e8s au microphone sont accord\u00e9s et r\u00e9essayer.","Failed to establish connection with OpenAI servers. Please try again.":"\u00c9chec de l\u2019\u00e9tablissement de la connexion avec les serveurs OpenAI. Veuillez r\u00e9essayer.","Failed to read image file.":"Failed to read image file.","Failed to send image. Please try again.":"Failed to send image. Please try again.","Failed to upload image.":"Failed to upload image.","Image file size must be less than 20MB.":"Image file size must be less than 20MB.","Internal server error: An unexpected error occurred. Please try again.":"Erreur interne du serveur\u00a0: Une erreur inattendue s\u2019est produite. Veuillez r\u00e9essayer.","Invalid API key: Please check your OpenAI API key in settings.":"Cl\u00e9 de l\u2019API invalide\u00a0: Veuillez v\u00e9rifier votre cl\u00e9 de l\u2019API OpenAI dans les r\u00e9glages.","Invalid request: The message format was not recognized by the server.":"Requ\u00eate invalide\u00a0: Le format du message n\u2019a pas \u00e9t\u00e9 reconnu par le serveur.","MediaDevices API not available. Please ensure you are using HTTPS and a modern browser.":"L\u2019API MediaDevices n\u2019est pas disponible. Veuillez vous assurer que vous utilisez HTTPS et un navigateur moderne.","Model overloaded: The AI model is currently experiencing high demand.":"Surcharge du mod\u00e8le\u00a0: Le mod\u00e8le d\u2019IA conna\u00eet actuellement une forte demande.","Network error: Failed to establish connection to the AI service.":"Erreur de r\u00e9seau\u00a0: \u00c9chec de l\u2019\u00e9tablissement de la connexion au service IA.","Please select an image file.":"Please select an image file.","Please start a session before uploading images.":"Please start a session before uploading images.","Quota exceeded: You have reached your usage limit for this period.":"Quota d\u00e9pass\u00e9\u00a0: Vous avez atteint votre limite d\u2019utilisation pour cette p\u00e9riode.","Rate limit exceeded: Too many requests. Please try again later.":"Limite de taux d\u00e9pass\u00e9e\u00a0: Trop de demandes. Veuillez r\u00e9essayer ult\u00e9rieurement.","Service unavailable: The AI service is temporarily down for maintenance.":"Service indisponible\u00a0: Le service IA est temporairement indisponible pour cause de maintenance."},"actions":[],"blocks":[],"shortcuts":[]}' data-theme='{"type":"internal","name":"ChatGPT","themeId":"chatgpt","settings":{"headerButtonsColor":"#434D58"},"style":"","cssUrl":"https:\/\/www.lowcostwebagency.com\/wp-content\/plugins\/ai-engine\/themes\/chatgpt.css"}'></div></div><div style="clear:both;"></div></section> </div>
<div class="fusion-clearfix"></div>
</div>
</div>
</div>
</div>
</div>
</div> <!-- wrapper -->
</div> <!-- #boxed-wrapper -->
<a class="fusion-one-page-text-link fusion-page-load-link" tabindex="-1" href="#" aria-hidden="true">Page load link</a>
<div class="avada-footer-scripts">
<script type="speculationrules">
{"prefetch":[{"source":"document","where":{"and":[{"href_matches":"/fr/*"},{"not":{"href_matches":["/wp-*.php","/wp-admin/*","/wp-content/uploads/*","/wp-content/*","/wp-content/plugins/*","/wp-content/themes/Avada-Child-Theme/*","/wp-content/themes/Avada/*","/fr/*\\?(.+)"]}},{"not":{"selector_matches":"a[rel~=\"nofollow\"]"}},{"not":{"selector_matches":".no-prefetch, .no-prefetch a"}}]},"eagerness":"conservative"}]}
</script>
<script type="text/javascript" src="data:text/javascript;base64,alF1ZXJ5KGRvY3VtZW50KS5yZWFkeShmdW5jdGlvbigpe2Z1bmN0aW9uIHdjX3F2X2dldFdpZHRoKCl7eFdpZHRoPW51bGw7aWYod2luZG93LnNjcmVlbiE9bnVsbCkKeFdpZHRoPXdpbmRvdy5zY3JlZW4uYXZhaWxXaWR0aDtpZih3aW5kb3cuaW5uZXJXaWR0aCE9bnVsbCkKeFdpZHRoPXdpbmRvdy5pbm5lcldpZHRoO2lmKGRvY3VtZW50LmJvZHkhPW51bGwpCnhXaWR0aD1kb2N1bWVudC5ib2R5LmNsaWVudFdpZHRoO3JldHVybiB4V2lkdGh9CmZ1bmN0aW9uIHdjX3F2X2dldF9jdXN0b21fdGVtcGxhdGUocHJvZHVjdF9pZCxleHRyYV9wYXJhbWV0ZXJzPScnKXt2YXIgaXNfc2hvcD0nbm8nO3ZhciBpc19jYXRlZ29yeT0nbm8nO3ZhciBvcmRlcmJ5PWpRdWVyeSgnLndvb2NvbW1lcmNlLW9yZGVyaW5nJykuZmluZCgnc2VsZWN0W25hbWU9b3JkZXJieV0nKS52YWwoKTt2YXIgdXJsPScvd3AtYWRtaW4vYWRtaW4tYWpheC5waHAnKyc/YWN0aW9uPXF1aWNrX3ZpZXdfY3VzdG9tX3RlbXBsYXRlX2xvYWQmcHJvZHVjdF9pZD0nK3Byb2R1Y3RfaWQrJyZpc19zaG9wPScraXNfc2hvcCsnJmlzX2NhdGVnb3J5PScraXNfY2F0ZWdvcnkrJyZvcmRlcmJ5PScrb3JkZXJieSsnJnNlY3VyaXR5PWYwNTg2ZThhZjUnO2lmKCcnIT09ZXh0cmFfcGFyYW1ldGVycyl7dXJsKz1leHRyYV9wYXJhbWV0ZXJzfQpyZXR1cm4gdXJsfQpqUXVlcnkoZG9jdW1lbnQpLm9uKCdxdWlja192aWV3X2Nsb3NlX3BvcHVwJyxmdW5jdGlvbigpe2lmKGpRdWVyeSgnZGl2LnBwX292ZXJsYXknKS5sZW5ndGg+MCl7alF1ZXJ5LnByZXR0eVBob3RvLmNsb3NlKCl9fSk7alF1ZXJ5KCIuaW5pdF9wcmV0dHlwaG90byIpLnByZXR0eVBob3RvKHthbmltYXRpb25fc3BlZWQ6MCxzb2NpYWxfdG9vbHM6ITEsdGhlbWU6J3BwX3dvb2NvbW1lcmNlJyxob3Jpem9udGFsX3BhZGRpbmc6MjAsb3BhY2l0eTowLjgsYWpheGNhbGxiYWNrOmZ1bmN0aW9uKCl7alF1ZXJ5KGRvY3VtZW50KS5maW5kKCcucHBfY29udGVudCcpLmFwcGVuZCgnPGRpdiBjbGFzcz0icXVpY2tfdmlld19wb3B1cF9sb2FkaW5nIj48L2Rpdj4nKTtqUXVlcnkoJy5xdWlja192aWV3X3BvcHVwX2xvYWRpbmcnKS5zaG93KCk7alF1ZXJ5KCcucHBfbG9hZGVySWNvbicpLnNob3coKX0sY2hhbmdlcGljdHVyZWNhbGxiYWNrOmZ1bmN0aW9uKCl7dmFyIHBvcHVwX2NvbnRhaW5lcj1qUXVlcnkoJy5xdWlja192aWV3X3BvcHVwX2NvbnRhaW5lcicpO3ZhciBwcm9kdWN0X2lkPXBvcHVwX2NvbnRhaW5lci5kYXRhKCdwcm9kdWN0X2lkJyk7dmFyIG9yZGVyYnk9cG9wdXBfY29udGFpbmVyLmRhdGEoJ29yZGVyYnknKTt2YXIgaXNfc2hvcD1wb3B1cF9jb250YWluZXIuZGF0YSgnaXNfc2hvcCcpO3ZhciBpc19jYXRlZ29yeT1wb3B1cF9jb250YWluZXIuZGF0YSgnaXNfY2F0ZWdvcnknKTt2YXIgcXZfZGF0YT17YWN0aW9uOiJxdWlja192aWV3X3ByZXR0eXBob3RvX2N1c3RvbV90ZW1wbGF0ZV9sb2FkIixwcm9kdWN0X2lkOnByb2R1Y3RfaWQsb3JkZXJieTpvcmRlcmJ5LGlzX3Nob3A6aXNfc2hvcCxpc19jYXRlZ29yeTppc19jYXRlZ29yeSxzZWN1cml0eTonNjNlZTM1NjI0OCd9O2pRdWVyeS5wb3N0KCcvd3AtYWRtaW4vYWRtaW4tYWpheC5waHAnLHF2X2RhdGEsZnVuY3Rpb24ocmVzcG9uc3ZlKXtwb3B1cF9jb250YWluZXIuaHRtbChyZXNwb25zdmUpO2pRdWVyeSgnLnF1aWNrX3ZpZXdfcG9wdXBfbG9hZGluZycpLmhpZGUoKTtqUXVlcnkoJy5wcF9sb2FkZXJJY29uJykuaGlkZSgpfSl9fSk7alF1ZXJ5KGRvY3VtZW50KS5vbigiY2xpY2siLCIucXVpY2tfdmlld191bHRpbWF0ZV9jbGljay5wcmV0dHlwaG90byIsZnVuY3Rpb24oKXt2YXIgcHJvZHVjdF9pZD1qUXVlcnkodGhpcykuYXR0cignaWQnKTt2YXIgcHJvZHVjdF91cmw9alF1ZXJ5KHRoaXMpLmF0dHIoJ2RhdGEtbGluaycpO3ZhciB1cmw9d2NfcXZfZ2V0X2N1c3RvbV90ZW1wbGF0ZShwcm9kdWN0X2lkLCcmYWpheD10cnVlJyk7dmFyIHBvcHVwX3RhbGw9MzAwO3ZhciBwb3B1cF93aWRlPTgwMDtpZih3Y19xdl9nZXRXaWR0aCgpPD02MDApe3BvcHVwX3dpZGU9JzkwJSc7cG9wdXBfdGFsbD0nOTAlJ30KalF1ZXJ5LnByZXR0eVBob3RvLm9wZW4odXJsKycmd2lkdGg9Jytwb3B1cF93aWRlKycmaGVpZ2h0PScrcG9wdXBfdGFsbCwnJywnJyk7cmV0dXJuITF9KX0p" defer></script>
<style type="text/css">
#cboxOverlay{ background-color: #666666 !important ; }
body .pp_overlay { background-color: #666666 !important ; }
</style>
<style type="text/css">
.quick_view_ultimate_content_under{text-align:center;clear:both;display:block;width:100%;padding:10px 0px;}
.quick_view_ultimate_content_under .quick_view_ultimate_under_link{
font:bold 12px/1.4em Arial, sans-serif !important;color:#000000 !important; text-align:center !important;
}
.quick_view_ultimate_content_under .quick_view_ultimate_under_link:hover{
color:#999999 !important;
}
.quick_view_ultimate_content_under .quick_view_ultimate_under_button{
font:bold 12px/1.4em Arial, sans-serif !important;color:#FFFFFF !important; border: 1px solid #000000 !important;border-radius: 3px 3px 3px 3px !important;-moz-border-radius: 3px 3px 3px 3px !important;-webkit-border-radius: 3px 3px 3px 3px !important; text-align:center !important;
padding: 7px 8px !important;
background: #000000 !important;
background: -webkit-gradient(linear, left top, left bottom, from(#000000), to(#000000)) !important;
background: -webkit-linear-gradient(#000000, #000000) !important;
background: -moz-linear-gradient(center top, #000000 0%, #000000 100%) !important;
background: -moz-gradient(center top, #000000 0%, #000000 100%) !important;
}
</style>
<style type="text/css">
.quick_view_ultimate_container{text-align:center;clear:both;display:block;width:100%;}
.quick_view_ultimate_container span{
font:normal 14px/1.4em Arial, sans-serif !important;color:#FFFFFF !important; text-align:center !important;
padding: 7px 17px !important;
}
.product_hover .quick_view_ultimate_container span.quick_view_ultimate_button{
color:#FFFFFF;
border: 1px solid #FFFFFF !important;border-radius: 3px 3px 3px 3px !important;-moz-border-radius: 3px 3px 3px 3px !important;-webkit-border-radius: 3px 3px 3px 3px !important; background: #999999;
background: -webkit-gradient(linear, left top, left bottom, from(#999999), to(#999999));
background: -webkit-linear-gradient(#999999, #999999);
background: -moz-linear-gradient(center top, #999999 0%, #999999 100%);
background: -moz-gradient(center top, #999999 0%, #999999 100%);
box-shadow: none !important ;-moz-box-shadow: none !important ;-webkit-box-shadow: none !important ; opacity:0.5;
filter:alpha(opacity=50);
}
</style>
<span class="awb-cart-count-data" data-cart-count="0" hidden></span><span class="awb-cart-count-live screen-reader-text" role="status" aria-live="polite" aria-atomic="true" data-singular="%s item in cart" data-plural="%s items in cart"></span><div class="woocommerce-cart-tab-container woocommerce-cart-tab-container--right"> <div class="woocommerce-cart-tab woocommerce-cart-tab--empty">
<svg xmlns="http://www.w3.org/2000/svg" viewbox="0 0 86 104.5" class="woocommerce-cart-tab__icon">
<path class="woocommerce-cart-tab__icon-bag" d="M67.2,26.7C64.6,11.5,54.8,0.2,43.1,0.2C31.4,0.2,21.6,11.5,19,26.7H0.1v77.6h86V26.7H67.2z M43.1,4.2 c9.6,0,17.7,9.6,20,22.6H23C25.4,13.8,33.5,4.2,43.1,4.2z M82.1,100.4h-78V30.7h14.4c-0.1,1.3-0.2,2.6-0.2,3.9c0,1.1,0,2.2,0.1,3.3 c-0.8,0.6-1.4,1.6-1.4,2.8c0,1.9,1.6,3.5,3.5,3.5s3.5-1.6,3.5-3.5c0-1.2-0.6-2.3-1.6-2.9c-0.1-1-0.1-2-0.1-3.1 c0-1.3,0.1-2.6,0.2-3.9h41.2c0.1,1.3,0.2,2.6,0.2,3.9c0,1,0,2.1-0.1,3.1c-1,0.6-1.6,1.7-1.6,2.9c0,1.9,1.6,3.5,3.5,3.5 c1.9,0,3.5-1.6,3.5-3.5c0-1.1-0.5-2.1-1.4-2.8c0.1-1.1,0.1-2.2,0.1-3.3c0-1.3-0.1-2.6-0.2-3.9h14.4V100.4z"/>
</svg>
<span class="woocommerce-cart-tab__contents">0</span>
<script type="text/javascript" src="data:text/javascript;base64,alF1ZXJ5KCcud29vY29tbWVyY2UtY2FydC10YWInKS5jbGljayhmdW5jdGlvbigpe2pRdWVyeSgnLndvb2NvbW1lcmNlLWNhcnQtdGFiLWNvbnRhaW5lcicpLnRvZ2dsZUNsYXNzKCd3b29jb21tZXJjZS1jYXJ0LXRhYi1jb250YWluZXItLXZpc2libGUnKTtqUXVlcnkoJ2JvZHknKS50b2dnbGVDbGFzcygnd29vY29tbWVyY2UtY2FydC10YWItaXMtdmlzaWJsZScpfSk=" defer></script>
</div>
<div class="widget woocommerce widget_shopping_cart"><h2 class="widgettitle">Votre panier</h2><div class="widget_shopping_cart_content"></div></div></div><!-- PayPal Checkout: Gateway not available for block theme injection --><div class='mwai-chatbot-container' data-params='{"aiName":"AI: ","userName":"User: ","guestName":"Guest:","textSend":"Send","textClear":"Clear","imageUpload":false,"fileUpload":false,"multiUpload":false,"maxUploads":1,"fileUploads":0,"mode":"chat","textInputPlaceholder":"Type your message...","textEmptyHint":"","textInputMaxLength":512,"textCompliance":"","startSentence":"Hi! How can I help you?","localMemory":true,"themeId":"chatgpt","window":true,"icon":"","iconText":"","iconTextDelay":1,"iconTextDuration":0,"iconTextOnce":"session","iconAlt":"AI Engine Chatbot","iconPosition":"bottom-right","centerOpen":false,"width":"","openDelay":"","iconBubble":false,"windowAnimation":"zoom","fullscreen":false,"copyButton":false,"pdfButton":false,"headerSubtitle":"Discuss with","containerType":"standard","headerType":"standard","messagesType":"standard","inputType":"standard","footerType":"standard"}' data-system='{"botId":"default","customId":null,"userData":null,"sessionId":null,"restNonce":null,"contextId":50314,"pluginUrl":"https:\/\/www.lowcostwebagency.com\/wp-content\/plugins\/ai-engine","restUrl":"https:\/\/www.lowcostwebagency.com\/fr\/wp-json","stream":true,"debugMode":false,"eventLogs":false,"speech_recognition":false,"speech_synthesis":false,"typewriter":false,"crossSite":false,"texts":{"Ask me anything!":"Ask me anything!","Jump to the latest message":"Jump to the latest message","Try again":"Try again","Conversation cleared.":"Conversation cleared.","Undo":"Undo","Done!":"Done!","New Chat":"Nouvelle discussion","No messages yet":"Aucun message pour l\u2019instant","Rename":"Renommer","Delete":"Supprimer","Your text was cut at %d characters.":"Your text was cut at %d characters.","Hold to Talk":"Maintenir pour parler","Release to Send":"Release to Send","Press Space to talk":"Press Space to talk","Start session to upload images":"Start session to upload images","Usage limit exceeded":"Usage limit exceeded","Connection failed":"Connection failed","Connection failed. Please check your network and try again.":"Connection failed. Please check your network and try again.","Connection lost. Reconnecting...":"Connection lost. Reconnecting...","Connection lost while uploading image. Please try again.":"Connection lost while uploading image. Please try again.","Connection timeout: The server took too long to respond.":"D\u00e9lai de connexion\u00a0: Le serveur a mis trop de temps \u00e0 r\u00e9pondre.","Could not start realtime session.":"Could not start realtime session.","An error occurred while starting the realtime session.":"An error occurred while starting the realtime session.","An error occurred while processing your request. Please try again.":"Une erreur s\u2019est produite lors du traitement de votre demande. Veuillez r\u00e9essayer.","An error occurred while committing the stats.":"Une erreur s\u2019est produite lors de la validation des statistiques.","An error occurred while committing the discussion.":"Une erreur s\u2019est produite lors de la validation de la discussion.","An error occurred while executing the function.":"Une erreur s\u2019est produite lors de l\u2019ex\u00e9cution de la fonction.","Authentication failed: Your session has expired. Please refresh the page.":"\u00c9chec de l\u2019authentification\u00a0: votre session a expir\u00e9. Veuillez actualiser la page.","Error uploading image. Please try again.":"Error uploading image. Please try again.","Failed to access microphone: ":"Failed to access microphone: ","Failed to access microphone. Please ensure microphone permissions are granted and try again.":"\u00c9chec de l\u2019acc\u00e8s au microphone. Veuillez vous assurer que les droits d\u2019acc\u00e8s au microphone sont accord\u00e9s et r\u00e9essayer.","Failed to establish connection with OpenAI servers. Please try again.":"\u00c9chec de l\u2019\u00e9tablissement de la connexion avec les serveurs OpenAI. Veuillez r\u00e9essayer.","Failed to read image file.":"Failed to read image file.","Failed to send image. Please try again.":"Failed to send image. Please try again.","Failed to upload image.":"Failed to upload image.","Image file size must be less than 20MB.":"Image file size must be less than 20MB.","Internal server error: An unexpected error occurred. Please try again.":"Erreur interne du serveur\u00a0: Une erreur inattendue s\u2019est produite. Veuillez r\u00e9essayer.","Invalid API key: Please check your OpenAI API key in settings.":"Cl\u00e9 de l\u2019API invalide\u00a0: Veuillez v\u00e9rifier votre cl\u00e9 de l\u2019API OpenAI dans les r\u00e9glages.","Invalid request: The message format was not recognized by the server.":"Requ\u00eate invalide\u00a0: Le format du message n\u2019a pas \u00e9t\u00e9 reconnu par le serveur.","MediaDevices API not available. Please ensure you are using HTTPS and a modern browser.":"L\u2019API MediaDevices n\u2019est pas disponible. Veuillez vous assurer que vous utilisez HTTPS et un navigateur moderne.","Model overloaded: The AI model is currently experiencing high demand.":"Surcharge du mod\u00e8le\u00a0: Le mod\u00e8le d\u2019IA conna\u00eet actuellement une forte demande.","Network error: Failed to establish connection to the AI service.":"Erreur de r\u00e9seau\u00a0: \u00c9chec de l\u2019\u00e9tablissement de la connexion au service IA.","Please select an image file.":"Please select an image file.","Please start a session before uploading images.":"Please start a session before uploading images.","Quota exceeded: You have reached your usage limit for this period.":"Quota d\u00e9pass\u00e9\u00a0: Vous avez atteint votre limite d\u2019utilisation pour cette p\u00e9riode.","Rate limit exceeded: Too many requests. Please try again later.":"Limite de taux d\u00e9pass\u00e9e\u00a0: Trop de demandes. Veuillez r\u00e9essayer ult\u00e9rieurement.","Service unavailable: The AI service is temporarily down for maintenance.":"Service indisponible\u00a0: Le service IA est temporairement indisponible pour cause de maintenance."},"actions":[],"blocks":[],"shortcuts":[]}' data-theme='{"type":"internal","name":"ChatGPT","themeId":"chatgpt","settings":{"headerButtonsColor":"#434D58"},"style":"","cssUrl":"https:\/\/www.lowcostwebagency.com\/wp-content\/plugins\/ai-engine\/themes\/chatgpt.css"}'></div> <script type='text/javascript' src="data:text/javascript;base64,KGZ1bmN0aW9uKCl7dmFyIGM9ZG9jdW1lbnQuYm9keS5jbGFzc05hbWU7Yz1jLnJlcGxhY2UoL3dvb2NvbW1lcmNlLW5vLWpzLywnd29vY29tbWVyY2UtanMnKTtkb2N1bWVudC5ib2R5LmNsYXNzTmFtZT1jfSkoKQ==" defer></script>
<script type="text/javascript" id="flying-scripts" src="data:text/javascript;base64,Y29uc3QgbG9hZFNjcmlwdHNUaW1lcj1zZXRUaW1lb3V0KGxvYWRTY3JpcHRzLDUqMTAwMCk7Y29uc3QgdXNlckludGVyYWN0aW9uRXZlbnRzPVsnY2xpY2snLCdtb3VzZW1vdmUnLCdrZXlkb3duJywndG91Y2hzdGFydCcsJ3RvdWNobW92ZScsJ3doZWVsJ107dXNlckludGVyYWN0aW9uRXZlbnRzLmZvckVhY2goZnVuY3Rpb24oZXZlbnQpe3dpbmRvdy5hZGRFdmVudExpc3RlbmVyKGV2ZW50LHRyaWdnZXJTY3JpcHRMb2FkZXIse3Bhc3NpdmU6ITB9KX0pO2Z1bmN0aW9uIHRyaWdnZXJTY3JpcHRMb2FkZXIoKXtsb2FkU2NyaXB0cygpO2NsZWFyVGltZW91dChsb2FkU2NyaXB0c1RpbWVyKTt1c2VySW50ZXJhY3Rpb25FdmVudHMuZm9yRWFjaChmdW5jdGlvbihldmVudCl7d2luZG93LnJlbW92ZUV2ZW50TGlzdGVuZXIoZXZlbnQsdHJpZ2dlclNjcmlwdExvYWRlcix7cGFzc2l2ZTohMH0pfSl9CmZ1bmN0aW9uIGxvYWRTY3JpcHRzKCl7ZG9jdW1lbnQucXVlcnlTZWxlY3RvckFsbCgic2NyaXB0W2RhdGEtdHlwZT0nbGF6eSddIikuZm9yRWFjaChmdW5jdGlvbihlbGVtKXtlbGVtLnNldEF0dHJpYnV0ZSgic3JjIixlbGVtLmdldEF0dHJpYnV0ZSgiZGF0YS1zcmMiKSl9KX0=" defer></script>
<script id="wcml-mc-scripts-js-extra" src="data:text/javascript;base64,dmFyIHdjbWxfbWNfc2V0dGluZ3M9eyJ3Y21sX3NwaW5uZXIiOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS93cC1jb250ZW50L3BsdWdpbnMvc2l0ZXByZXNzLW11bHRpbGluZ3VhbC1jbXMvcmVzL2ltZy9hamF4LWxvYWRlci5naWYiLCJjdXJyZW50X2N1cnJlbmN5Ijp7ImNvZGUiOiJVU0QiLCJzeW1ib2wiOiImIzM2OyJ9LCJjYWNoZV9lbmFibGVkIjoiIn0=" defer></script>
<script data-optimized="1" data-wp-strategy="defer" defer id="wcml-mc-scripts-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/864c22c53c3a1db500aef6628fdb72a7.js?ver=711be"></script>
<script id="thickbox-js-extra" src="data:text/javascript;base64,dmFyIHRoaWNrYm94TDEwbj17Im5leHQiOiJTdWl2Llx1MDBhMFx1MDAzRSIsInByZXYiOiJcdTAwM0NcdTAwYTBQclx1MDBlOWMuIiwiaW1hZ2UiOiJJbWFnZSIsIm9mIjoic3VyIiwiY2xvc2UiOiJGZXJtZXIiLCJub2lmcmFtZXMiOiJDZXR0ZSBmb25jdGlvbm5hbGl0XHUwMGU5IHJlcXVpZXJ0IGRlcyBpZnJhbWVzLiBMZXMgaWZyYW1lcyBzb250IGRcdTAwZTlzYWN0aXZcdTAwZTllcyBzdXIgdm90cmUgbmF2aWdhdGV1ciwgb3UgYWxvcnMgaWwgbmUgbGVzIGFjY2VwdGUgcGFzLiIsImxvYWRpbmdBbmltYXRpb24iOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS93cC1pbmNsdWRlcy9qcy90aGlja2JveC9sb2FkaW5nQW5pbWF0aW9uLmdpZiJ9" defer></script>
<script data-optimized="1" id="thickbox-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/7cd7b7f36836d52fd3e67198c204f882.js?ver=0cf4c" defer data-deferred="1"></script>
<script id="jquery-ui-core-js-before" src="data:text/javascript;base64,alF1ZXJ5LnVpQmFja0NvbXBhdD0hMA==" defer></script>
<script data-optimized="1" id="jquery-ui-core-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/7551c43cec1dfc51a17d7b78e3d79886.js?ver=74224" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-ui-tooltip-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/e81c4a7c39e0bc5ce67f8e99aea2af2e.js?ver=2de31" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-ui-mouse-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/4b979d0f99246060f63dc04090111a34.js?ver=305a0" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-ui-slider-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/1197abdc32ab83a69b14eec5b79e1f06.js?ver=5d95a" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-ui-datepicker-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/54a1a0f32168d1bef8faf19365f3581c.js?ver=cfbb8" defer data-deferred="1"></script>
<script id="jquery-ui-datepicker-js-after" src="data:text/javascript;base64,alF1ZXJ5KGZ1bmN0aW9uKGpRdWVyeSl7alF1ZXJ5LmRhdGVwaWNrZXIuc2V0RGVmYXVsdHMoeyJjbG9zZVRleHQiOiJGZXJtZXIiLCJjdXJyZW50VGV4dCI6IkF1am91cmRcdTIwMTlodWkiLCJtb250aE5hbWVzIjpbImphbnZpZXIiLCJmXHUwMGU5dnJpZXIiLCJtYXJzIiwiYXZyaWwiLCJtYWkiLCJqdWluIiwianVpbGxldCIsImFvXHUwMGZidCIsInNlcHRlbWJyZSIsIm9jdG9icmUiLCJub3ZlbWJyZSIsImRcdTAwZTljZW1icmUiXSwibW9udGhOYW1lc1Nob3J0IjpbIkphbiIsIkZcdTAwZTl2IiwiTWFyIiwiQXZyIiwiTWFpIiwiSnVpbiIsIkp1aWwiLCJBb1x1MDBmYnQiLCJTZXAiLCJPY3QiLCJOb3YiLCJEXHUwMGU5YyJdLCJuZXh0VGV4dCI6Ik5leHQiLCJwcmV2VGV4dCI6IlByZXZpb3VzIiwiZGF5TmFtZXMiOlsiZGltYW5jaGUiLCJsdW5kaSIsIm1hcmRpIiwibWVyY3JlZGkiLCJqZXVkaSIsInZlbmRyZWRpIiwic2FtZWRpIl0sImRheU5hbWVzU2hvcnQiOlsiZGltIiwibHVuIiwibWFyIiwibWVyIiwiamV1IiwidmVuIiwic2FtIl0sImRheU5hbWVzTWluIjpbIkQiLCJMIiwiTSIsIk0iLCJKIiwiViIsIlMiXSwiZGF0ZUZvcm1hdCI6ImQgTU0geXkiLCJmaXJzdERheSI6MSwiaXNSVEwiOiExfSl9KQ==" defer></script>
<script data-optimized="1" id="jquery-effects-core-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/d07791d93d8c6407cc425a952409b3be.js?ver=83a64" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-ui-menu-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/0690d10a10618ef2ef4020a1ee5bff47.js?ver=9a037" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-dom-ready-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/6492f64af2f74486bf7a70afc2260607.js?ver=27c8e" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-hooks-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/f84e88a6ddd53ef5cc5b24773a501bd0.js?ver=b5e9f" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-i18n-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/4b114ee18e22025b760f414c5b31b64a.js?ver=841dd" defer data-deferred="1"></script>
<script id="wp-i18n-js-after" src="data:text/javascript;base64,d3AuaTE4bi5zZXRMb2NhbGVEYXRhKHsndGV4dCBkaXJlY3Rpb25cdTAwMDRsdHInOlsnbHRyJ119KQ==" defer></script>
<script id="wp-a11y-js-translations" src="data:text/javascript;base64,KGZ1bmN0aW9uKGRvbWFpbix0cmFuc2xhdGlvbnMpe3ZhciBsb2NhbGVEYXRhPXRyYW5zbGF0aW9ucy5sb2NhbGVfZGF0YVtkb21haW5dfHx0cmFuc2xhdGlvbnMubG9jYWxlX2RhdGEubWVzc2FnZXM7bG9jYWxlRGF0YVsiIl0uZG9tYWluPWRvbWFpbjt3cC5pMThuLnNldExvY2FsZURhdGEobG9jYWxlRGF0YSxkb21haW4pfSkoImRlZmF1bHQiLHsidHJhbnNsYXRpb24tcmV2aXNpb24tZGF0ZSI6IjIwMjYtMDQtMjAgMDg6NTk6MTcrMDAwMCIsImdlbmVyYXRvciI6Ikdsb3RQcmVzc1wvNC4wLjMiLCJkb21haW4iOiJtZXNzYWdlcyIsImxvY2FsZV9kYXRhIjp7Im1lc3NhZ2VzIjp7IiI6eyJkb21haW4iOiJtZXNzYWdlcyIsInBsdXJhbC1mb3JtcyI6Im5wbHVyYWxzPTI7IHBsdXJhbD1uID4gMTsiLCJsYW5nIjoiZnIifSwiTm90aWZpY2F0aW9ucyI6WyJOb3RpZmljYXRpb25zIl19fSwiY29tbWVudCI6eyJyZWZlcmVuY2UiOiJ3cC1pbmNsdWRlc1wvanNcL2Rpc3RcL2ExMXkuanMifX0p" defer></script>
<script data-optimized="1" id="wp-a11y-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/82bff17ae976a1ca7cc0d1e3f9aff27c.js?ver=b069c" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-ui-autocomplete-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/df9349a78f452c6d7473faa72ead1e9b.js?ver=6717a" defer data-deferred="1"></script>
<script data-optimized="1" id="lfb_frontend-libs-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/dd3890664793f9ff51c7a20d2cd52a25.js?ver=76f2d" defer data-deferred="1"></script>
<script data-optimized="1" id="touchpunch-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/2acae1a02a1f6fbcca72af8a5610fed0.js?ver=c7dd6" defer data-deferred="1"></script>
<script id="lfb_frontend-js-extra" src="data:text/javascript;base64,dmFyIGxmYl9mb3Jtcz1beyJjdXJyZW50UmVmIjowLCJyZWZWYXJOYW1lIjoicmVmIiwiaG9tZVVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tIiwiYWpheHVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWFkbWluL2FkbWluLWFqYXgucGhwIiwiaW5pdGlhbFByaWNlIjoiMCIsIm1heF9wcmljZSI6IjAiLCJwZXJjZW50VG9QYXkiOiIxMDAiLCJmaXhlZFRvUGF5IjoiMTAwIiwicGF5TW9kZSI6IiIsImN1cnJlbmN5IjoiJCIsImN1cnJlbmN5UG9zaXRpb24iOiJsZWZ0IiwiaW50cm9fZW5hYmxlZCI6IjEiLCJzYXZlX3RvX2NhcnQiOiIwIiwic2F2ZV90b19jYXJ0X2VkZCI6IjAiLCJjb2xvckEiOiIjZjA3NjFmIiwiYW5pbWF0aW9uc1NwZWVkIjoiMC4zIiwiZW1haWxfdG9Vc2VyIjoiMSIsInNob3dTdGVwcyI6IjIiLCJmb3JtSUQiOiI4IiwiZ3Jhdml0eUZvcm1JRCI6IjAiLCJzaG93SW5pdGlhbFByaWNlIjoiMSIsImRpc2FibGVUaXBNb2JpbGUiOiIwIiwibGVnYWxOb3RpY2VFbmFibGUiOiIwIiwibGlua3MiOlt7ImlkIjoiOTU0NyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY0IiwiZGVzdGluYXRpb25JRCI6IjY2IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiNjRfNTIxXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU0OCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY0IiwiZGVzdGluYXRpb25JRCI6IjcwIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiNjRfNTIwXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU0OSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY0IiwiZGVzdGluYXRpb25JRCI6Ijg3IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiNjRfNTI2XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1MCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY0IiwiZGVzdGluYXRpb25JRCI6IjY5IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiNjRfNTIzXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1MSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY0IiwiZGVzdGluYXRpb25JRCI6IjY4IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiNjRfNTIyXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1MiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY0IiwiZGVzdGluYXRpb25JRCI6IjY1IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiNjRfNjE1XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1MyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY2IiwiZGVzdGluYXRpb25JRCI6Ijk0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1NCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijk0IiwiZGVzdGluYXRpb25JRCI6Ijg2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1NSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijg2IiwiZGVzdGluYXRpb25JRCI6IjkxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1NiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjcwIiwiZGVzdGluYXRpb25JRCI6Ijc3IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1NyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijc3IiwiZGVzdGluYXRpb25JRCI6IjkyIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1OCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijg3IiwiZGVzdGluYXRpb25JRCI6Ijg4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU1OSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijg4IiwiZGVzdGluYXRpb25JRCI6IjcxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU2MCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjczIiwiZGVzdGluYXRpb25JRCI6Ijg5IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU2MSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY5IiwiZGVzdGluYXRpb25JRCI6IjczIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU2MiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjY5IiwiZGVzdGluYXRpb25JRCI6IjE3OSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjY5XzQ0MFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1NjMiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI2OCIsImRlc3RpbmF0aW9uSUQiOiI5MCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1NjQiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI2NSIsImRlc3RpbmF0aW9uSUQiOiI5MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1NjUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzkiLCJkZXN0aW5hdGlvbklEIjoiOTEiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCI2OV80NDBcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTY2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTMiLCJkZXN0aW5hdGlvbklEIjoiOTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTY3IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTAiLCJkZXN0aW5hdGlvbklEIjoiOTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTY4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiODkiLCJkZXN0aW5hdGlvbklEIjoiOTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTY5IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiNzEiLCJkZXN0aW5hdGlvbklEIjoiOTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTcwIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTIiLCJkZXN0aW5hdGlvbklEIjoiOTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTcxIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTEiLCJkZXN0aW5hdGlvbklEIjoiOTUiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCI5MV83MzhcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTcyIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTEiLCJkZXN0aW5hdGlvbklEIjoiOTgiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCI5MV83MDhcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTczIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTEiLCJkZXN0aW5hdGlvbklEIjoiMTAxIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiOTFfNzAxXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU3NCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjkxIiwiZGVzdGluYXRpb25JRCI6IjEwNCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjkxXzcwMlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1NzUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI5MSIsImRlc3RpbmF0aW9uSUQiOiIxMDciLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCI5MV83MDNcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTc2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiOTEiLCJkZXN0aW5hdGlvbklEIjoiMTA5IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiOTFfNzA1XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU3NyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijk1IiwiZGVzdGluYXRpb25JRCI6Ijk2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU3OCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijk2IiwiZGVzdGluYXRpb25JRCI6Ijk3IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU3OSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijk4IiwiZGVzdGluYXRpb25JRCI6Ijk5IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU4MCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6Ijk5IiwiZGVzdGluYXRpb25JRCI6IjEwMCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1ODEiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMDEiLCJkZXN0aW5hdGlvbklEIjoiMTAyIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU4MiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEwMiIsImRlc3RpbmF0aW9uSUQiOiIxMDMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTgzIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTA0IiwiZGVzdGluYXRpb25JRCI6IjEwNSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1ODQiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMDUiLCJkZXN0aW5hdGlvbklEIjoiMTA2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU4NSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEwNyIsImRlc3RpbmF0aW9uSUQiOiIxMDgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTg2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTA5IiwiZGVzdGluYXRpb25JRCI6IjExMCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1ODciLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMDQiLCJkZXN0aW5hdGlvbklEIjoiMTgwIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTA0Xzg1N1wiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1ODgiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI5NyIsImRlc3RpbmF0aW9uSUQiOiIxMTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTg5IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTAwIiwiZGVzdGluYXRpb25JRCI6IjExMSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1OTAiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMDMiLCJkZXN0aW5hdGlvbklEIjoiMTExIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU5MSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEwNiIsImRlc3RpbmF0aW9uSUQiOiIxMTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTkyIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTA4IiwiZGVzdGluYXRpb25JRCI6IjExMSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk1OTMiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMTAiLCJkZXN0aW5hdGlvbklEIjoiMTExIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTU5NCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE4MCIsImRlc3RpbmF0aW9uSUQiOiIxMTEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTk1IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjEyNyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV85MDFcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTk2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjEyNCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV84OTlcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTk3IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjEyMSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV84OTJcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTk4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjExOCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV84OTNcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NTk5IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjExNSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV84OTRcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjAwIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjExMyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV84OTZcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjAyIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTEzIiwiZGVzdGluYXRpb25JRCI6IjExMiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MDMiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMTUiLCJkZXN0aW5hdGlvbklEIjoiMTE0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYwNCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjExOCIsImRlc3RpbmF0aW9uSUQiOiIxODEiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxMThfOTM3XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYwNSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjExOCIsImRlc3RpbmF0aW9uSUQiOiIxMTciLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjA2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTE3IiwiZGVzdGluYXRpb25JRCI6IjExNiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MDciLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMjEiLCJkZXN0aW5hdGlvbklEIjoiMTIwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYwOCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyMCIsImRlc3RpbmF0aW9uSUQiOiIxMTkiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjA5IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTI0IiwiZGVzdGluYXRpb25JRCI6IjEyMyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MTAiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMjMiLCJkZXN0aW5hdGlvbklEIjoiMTIyIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYxMiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyNiIsImRlc3RpbmF0aW9uSUQiOiIxMjciLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxMjdfMTAwMVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIxMjdfMTAwMlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTYxMyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyNiIsImRlc3RpbmF0aW9uSUQiOiIxMjUiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjE0IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTI1IiwiZGVzdGluYXRpb25JRCI6IjEyOCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MTUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMjIiLCJkZXN0aW5hdGlvbklEIjoiMTI4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYxNiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjExOSIsImRlc3RpbmF0aW9uSUQiOiIxMjgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjE3IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTE2IiwiZGVzdGluYXRpb25JRCI6IjEyOCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MTgiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMTQiLCJkZXN0aW5hdGlvbklEIjoiMTI4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYxOSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjExMiIsImRlc3RpbmF0aW9uSUQiOiIxMjgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjIwIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTI4IiwiZGVzdGluYXRpb25JRCI6IjEyOSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjEyOF8xMDE0XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYyMSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyOCIsImRlc3RpbmF0aW9uSUQiOiIxMzQiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxMjhfMTAxMlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MjIiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMjgiLCJkZXN0aW5hdGlvbklEIjoiMTM3IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTI4XzEwMDVcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjIzIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTI4IiwiZGVzdGluYXRpb25JRCI6IjE0MCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjEyOF8xMDA2XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYyNCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyOCIsImRlc3RpbmF0aW9uSUQiOiIxNDIiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxMjhfMTAwN1wiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MjUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMjgiLCJkZXN0aW5hdGlvbklEIjoiMTQ0IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTI4XzEwMDlcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjI2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTQwIiwiZGVzdGluYXRpb25JRCI6IjE4MiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE0MF8xMDk0XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYyNyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyOSIsImRlc3RpbmF0aW9uSUQiOiIxMzAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjI4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTM0IiwiZGVzdGluYXRpb25JRCI6IjEzMyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MjkiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMzciLCJkZXN0aW5hdGlvbklEIjoiMTM2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYzMCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE0MCIsImRlc3RpbmF0aW9uSUQiOiIxMzkiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjMxIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTQyIiwiZGVzdGluYXRpb25JRCI6IjE0MSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MzIiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNDQiLCJkZXN0aW5hdGlvbklEIjoiMTQzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYzMyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEzMCIsImRlc3RpbmF0aW9uSUQiOiIxMzEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjM0IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTMzIiwiZGVzdGluYXRpb25JRCI6IjEzMiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MzUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMzYiLCJkZXN0aW5hdGlvbklEIjoiMTM1IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYzNiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEzOSIsImRlc3RpbmF0aW9uSUQiOiIxMzgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjM3IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTMxIiwiZGVzdGluYXRpb25JRCI6IjE2MSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2MzgiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxMzIiLCJkZXN0aW5hdGlvbklEIjoiMTYxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTYzOSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEzNSIsImRlc3RpbmF0aW9uSUQiOiIxNjEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjQwIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTM4IiwiZGVzdGluYXRpb25JRCI6IjE2MSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NDEiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNDEiLCJkZXN0aW5hdGlvbklEIjoiMTYxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY0MiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE0MyIsImRlc3RpbmF0aW9uSUQiOiIxNjEiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjQzIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTgxIiwiZGVzdGluYXRpb25JRCI6IjEyOCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NDQiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxODIiLCJkZXN0aW5hdGlvbklEIjoiMTYxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY0NSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE1NiIsImRlc3RpbmF0aW9uSUQiOiIxODMiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxNTZfMTE5NlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NDYiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNjAiLCJkZXN0aW5hdGlvbklEIjoiMTU5IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY0NyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE1OCIsImRlc3RpbmF0aW9uSUQiOiIxNTciLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjQ4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTU2IiwiZGVzdGluYXRpb25JRCI6IjE1NSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NDkiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNTUiLCJkZXN0aW5hdGlvbklEIjoiMTU0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY1MCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE1MyIsImRlc3RpbmF0aW9uSUQiOiIxNTIiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjUxIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTUyIiwiZGVzdGluYXRpb25JRCI6IjE1MSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NTIiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNTAiLCJkZXN0aW5hdGlvbklEIjoiMTQ5IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY1MyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE0OSIsImRlc3RpbmF0aW9uSUQiOiIxNDgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjU0IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTYxIiwiZGVzdGluYXRpb25JRCI6IjE1MCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE2MV8xMjI3XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY1NSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE0NSIsImRlc3RpbmF0aW9uSUQiOiIxNDYiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjU2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTQ2IiwiZGVzdGluYXRpb25JRCI6IjE0NyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NTciLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNjEiLCJkZXN0aW5hdGlvbklEIjoiMTQ1IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTYxXzEyMjlcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjU4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTYxIiwiZGVzdGluYXRpb25JRCI6IjE1MyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE2MV8xMjIwXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY1OSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE2MSIsImRlc3RpbmF0aW9uSUQiOiIxNTYiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxNjFfMTIyMVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NjAiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNjEiLCJkZXN0aW5hdGlvbklEIjoiMTU4IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTYxXzEyMjJcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjYxIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTYxIiwiZGVzdGluYXRpb25JRCI6IjE2MCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE2MV8xMjI0XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY2MiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE0NyIsImRlc3RpbmF0aW9uSUQiOiIxNzgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjYzIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTQ4IiwiZGVzdGluYXRpb25JRCI6IjE3OCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NjQiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNTEiLCJkZXN0aW5hdGlvbklEIjoiMTc4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY2NSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE1NCIsImRlc3RpbmF0aW9uSUQiOiIxNzgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjY2IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTU3IiwiZGVzdGluYXRpb25JRCI6IjE3OCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NjciLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNTkiLCJkZXN0aW5hdGlvbklEIjoiMTc4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY2OCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE4MyIsImRlc3RpbmF0aW9uSUQiOiIxNzgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjY5IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTc4IiwiZGVzdGluYXRpb25JRCI6IjE2MiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE3OF8xMzQyXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY3MCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE3OCIsImRlc3RpbmF0aW9uSUQiOiIxNjUiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxNzhfMTM0MFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NzEiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzgiLCJkZXN0aW5hdGlvbklEIjoiMTY4IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTc4XzEzMzNcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjcyIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTc4IiwiZGVzdGluYXRpb25JRCI6IjE3MSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE3OF8xMzM0XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY3MyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE3OCIsImRlc3RpbmF0aW9uSUQiOiIxNzQiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxNzhfMTMzNVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NzQiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzgiLCJkZXN0aW5hdGlvbklEIjoiMTc2IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTc4XzEzMzdcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Njc1IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTYyIiwiZGVzdGluYXRpb25JRCI6IjE2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NzYiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNjMiLCJkZXN0aW5hdGlvbklEIjoiMTY0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY3NyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE2NSIsImRlc3RpbmF0aW9uSUQiOiIxNjYiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Njc4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTY2IiwiZGVzdGluYXRpb25JRCI6IjE2NyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2NzkiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNjgiLCJkZXN0aW5hdGlvbklEIjoiMTY5IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY4MCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE2OSIsImRlc3RpbmF0aW9uSUQiOiIxNzAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjgxIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTcxIiwiZGVzdGluYXRpb25JRCI6IjE3MiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2ODIiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzIiLCJkZXN0aW5hdGlvbklEIjoiMTczIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY4MyIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE3NCIsImRlc3RpbmF0aW9uSUQiOiIxNzUiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Njg0IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTc2IiwiZGVzdGluYXRpb25JRCI6IjE3NyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2ODUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzEiLCJkZXN0aW5hdGlvbklEIjoiMTg0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY4NiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE4NCIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2ODciLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzciLCJkZXN0aW5hdGlvbklEIjoiNjMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Njg4IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTc1IiwiZGVzdGluYXRpb25JRCI6IjYzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY4OSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE3MyIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2OTAiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNzAiLCJkZXN0aW5hdGlvbklEIjoiNjMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NjkxIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTY3IiwiZGVzdGluYXRpb25JRCI6IjYzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTY5MiIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE2NCIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2OTMiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI2MyIsImRlc3RpbmF0aW9uSUQiOiI1OSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2OTQiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI1OSIsImRlc3RpbmF0aW9uSUQiOiI2MSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2OTUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI2MSIsImRlc3RpbmF0aW9uSUQiOiI2MiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk2OTYiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI5MSIsImRlc3RpbmF0aW9uSUQiOiIxODAiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCI5MV83MDZcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifSx7XCJpbnRlcmFjdGlvblwiOlwiOTFfNzA0XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiJPUiJ9LHsiaWQiOiI5Njk3IiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTExIiwiZGVzdGluYXRpb25JRCI6IjE4MSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjExMV84OTdcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifSx7XCJpbnRlcmFjdGlvblwiOlwiMTExXzg5NVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTY5OCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjEyOCIsImRlc3RpbmF0aW9uSUQiOiIxODIiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxMjhfMTAxMFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIxMjhfMTAwOFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTY5OSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE2MSIsImRlc3RpbmF0aW9uSUQiOiIxODMiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxNjFfMTIyNVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIxNjFfMTIyM1wiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTcwMCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE3OCIsImRlc3RpbmF0aW9uSUQiOiIxODQiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxNzhfMTMzOFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIxNzhfMTMzNlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTcwMSIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjE3OCIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MDIiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiIxNjEiLCJkZXN0aW5hdGlvbklEIjoiNjMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzAzIiwiZm9ybUlEIjoiOCIsIm9yaWdpbklEIjoiMTI4IiwiZGVzdGluYXRpb25JRCI6IjYzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcwNCIsImZvcm1JRCI6IjgiLCJvcmlnaW5JRCI6IjExMSIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MDUiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI5MSIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MDYiLCJmb3JtSUQiOiI4Iiwib3JpZ2luSUQiOiI2NCIsImRlc3RpbmF0aW9uSUQiOiI2MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn1dLCJjbG9zZV91cmwiOiIjIiwicmVkaXJlY3Rpb25zIjpbeyJpZCI6IjEiLCJmb3JtSUQiOiI4IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn0seyJpZCI6IjIiLCJmb3JtSUQiOiI4IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn0seyJpZCI6IjMiLCJmb3JtSUQiOiI4IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn0seyJpZCI6IjQiLCJmb3JtSUQiOiI4IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn0seyJpZCI6IjUiLCJmb3JtSUQiOiI4IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn0seyJpZCI6IjYiLCJmb3JtSUQiOiI4IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn1dLCJ1c2VSZWRpcmVjdGlvbkNvbmRpdGlvbnMiOiIwIiwidXNlUGRmIjoxLCJ0eHRfeWVzIjoiT3VpIiwidHh0X25vIjoiTm9uIiwidHh0X2xhc3RCdG4iOiJTdWJtaXQiLCJ0eHRfYnRuU3RlcCI6Ik5leHQgIiwiZGF0ZUZvcm1hdCI6ImQgTU0geXl5eSIsImRhdGVQaWNrZXJMYW5ndWFnZSI6IiIsInRob3VzYW5kc1NlcGFyYXRvciI6IiIsImRlY2ltYWxzU2VwYXJhdG9yIjoiLiIsIm1pbGxpb25TZXBhcmF0b3IiOiIiLCJiaWxsaW9uc1NlcGFyYXRvciI6IiIsInN1bW1hcnlfaGlkZVF0IjoiMSIsInN1bW1hcnlfaGlkZVplcm8iOiIxIiwic3VtbWFyeV9oaWRlWmVyb1F0IjoiMSIsInN1bW1hcnlfaGlkZVByaWNlcyI6IjEiLCJzdW1tYXJ5X2hpZGVaZXJvRGVjaW1hbHMiOiIxIiwiZ3JvdXBBdXRvQ2xpY2siOiIxIiwiZmlsZXNVcGxvYWRfdGV4dCI6IkRyb3AgZmlsZXMgaGVyZSB0byB1cGxvYWQiLCJmaWxlc1VwbG9hZFNpemVfdGV4dCI6IkZpbGUgaXMgdG9vIGJpZyAobWF4IHNpemU6IHt7bWF4RmlsZXNpemV9fU1CKSIsImZpbGVzVXBsb2FkVHlwZV90ZXh0IjoiSW52YWxpZCBmaWxlIHR5cGUiLCJmaWxlc1VwbG9hZExpbWl0X3RleHQiOiJZb3UgY2FuIG5vdCB1cGxvYWQgYW55IG1vcmUgZmlsZXMiLCJzZW5kQ29udGFjdEFTQVAiOiIxIiwic2hvd1RvdGFsQm90dG9tIjoiMCIsInN0cmlwZVB1YktleSI6IiIsInNjcm9sbFRvcE1hcmdpbiI6IjAiLCJzY3JvbGxUb3BNYXJnaW5Nb2JpbGUiOiIwIiwicmVkaXJlY3Rpb25EZWxheSI6IjAiLCJnbWFwX2tleSI6IiIsInR4dERpc3RhbmNlRXJyb3IiOiJDYWxjdWxhdGluZyB0aGUgZGlzdGFuY2UgY291bGQgbm90IGJlIHBlcmZvcm1lZCwgcGxlYXNlIHZlcmlmeSB0aGUgaW5wdXQgYWRkcmVzc2VzIiwiY2FwdGNoYVVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWNvbnRlbnQvcGx1Z2lucy9XUF9Fc3RpbWF0aW9uX0Zvcm0vaW5jbHVkZXMvY2FwdGNoYS9nZXRfY2FwdGNoYS5waHAiLCJzdW1tYXJ5X25vRGVjaW1hbHMiOiIxIiwic2Nyb2xsVG9wUGFnZSI6IjEiLCJkaXNhYmxlRHJvcGRvd25zIjoiMSIsImltZ0ljb25TdHlsZSI6Inpvb20iLCJzdW1tYXJ5X2hpZGVGaW5hbFN0ZXAiOiIxIiwidGltZU1vZGVBTSI6IjAiLCJlbmFibGVTaGluZUZ4QnRuIjoiMSIsInN1bW1hcnlfc2hvd0FsbFByaWNlc0VtYWlsIjoiMCIsImltZ1RpdGxlc1N0eWxlIjoiIiwibGFzdFMiOiIxNjY2MDkzMTI1MjQxIiwiZW1wdHlXb29DYXJ0IjoiMCIsInNlbmRVcmxWYXJpYWJsZXMiOiIwIiwic2VuZFZhcmlhYmxlc01ldGhvZCI6IiIsImVuYWJsZVphcGllciI6IjAiLCJ6YXBpZXJXZWJIb29rIjoiIiwic3VtbWFyeV9zaG93RGVzY3JpcHRpb25zIjoiMSIsImltZ1ByZXZpZXciOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS93cC1jb250ZW50L3BsdWdpbnMvV1BfRXN0aW1hdGlvbl9Gb3JtL2Fzc2V0cy9pbWcvZmlsZS0zLTEyOC5wbmciLCJwcm9ncmVzc0JhclByaWNlVHlwZSI6IiIsInJhem9ycGF5X3B1Ymxpc2hLZXkiOiIiLCJyYXpvcnBheV9sb2dvSW1nIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vd3AtY29udGVudC91cGxvYWRzLzIwMjIvMTAvY3JlZGl0Q2FyZEAyeC5wbmciLCJ2YXJpYWJsZXMiOltdLCJ1c2VFbWFpbFZlcmlmaWNhdGlvbiI6IjAiLCJ0eHRfZW1haWxBY3RpdmF0aW9uQ29kZSI6IkZpbGwgeW91ciB2ZXJpZmljYXRpb24gY29kZSBoZXJlIiwidHh0X2VtYWlsQWN0aXZhdGlvbkluZm8iOiJBIHVuaXF1ZSB2ZXJpZmljYXRpb24gY29kZSBoYXMganVzdCBiZWVuIHNlbnQgdG8geW91IGJ5IGVtYWlsLCBwbGVhc2UgY29weSBpdCBpbiB0aGUgZmllbGQgYmVsb3cgdG8gdmFsaWRhdGUgeW91ciBlbWFpbCBhZGRyZXNzLiIsInVzZUNhcHRjaGEiOiIwIiwicmVjYXB0Y2hhM0tleSI6IiIsImRpc3RhbmNlc01vZGUiOiJyb3V0ZSIsImVuYWJsZUN1c3RvbWVyQWNjb3VudCI6IjAiLCJ0eHRDdXN0b21lcnNEYXRhRm9yZ290UGFzc1NlbnQiOiIiLCJ0eHRDdXN0b21lcnNEYXRhRm9yZ290UGFzc0xpbmsiOiIiLCJlbWFpbEN1c3RvbWVyTGlua3MiOiIxIiwiZW5hYmxlUGRmRG93bmxvYWQiOiIxIiwidXNlU2lnbmF0dXJlIjoiMCIsInVzZVZBVCI6IjAiLCJ2YXRBbW91bnQiOiIyMCIsInZhdExhYmVsIjoiVkFUIiwiYXV0b2Nsb3NlRGF0ZXBpY2tlciI6IjAiLCJmbG9hdFN1bW1hcnlfc2hvd0luZm8iOiIxIiwiaGlkZUZpbmFsYnRuIjoiMCIsImNhcnRQYWdlIjoiIiwiZGlzYWJsZVNjcm9sbCI6IjAifSx7ImN1cnJlbnRSZWYiOjAsInJlZlZhck5hbWUiOiJyZWYiLCJob21lVXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20iLCJhamF4dXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vd3AtYWRtaW4vYWRtaW4tYWpheC5waHAiLCJpbml0aWFsUHJpY2UiOiIwIiwibWF4X3ByaWNlIjoiMCIsInBlcmNlbnRUb1BheSI6IjEwMCIsImZpeGVkVG9QYXkiOiIxMDAiLCJwYXlNb2RlIjoiIiwiY3VycmVuY3kiOiIkIiwiY3VycmVuY3lQb3NpdGlvbiI6ImxlZnQiLCJpbnRyb19lbmFibGVkIjoiMSIsInNhdmVfdG9fY2FydCI6IjAiLCJzYXZlX3RvX2NhcnRfZWRkIjoiMCIsImNvbG9yQSI6IiNmMDc2MWYiLCJhbmltYXRpb25zU3BlZWQiOiIwLjMiLCJlbWFpbF90b1VzZXIiOiIxIiwic2hvd1N0ZXBzIjoiMiIsImZvcm1JRCI6IjkiLCJncmF2aXR5Rm9ybUlEIjoiMCIsInNob3dJbml0aWFsUHJpY2UiOiIxIiwiZGlzYWJsZVRpcE1vYmlsZSI6IjAiLCJsZWdhbE5vdGljZUVuYWJsZSI6IjAiLCJsaW5rcyI6W3siaWQiOiI5NzA3IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTg5IiwiZGVzdGluYXRpb25JRCI6IjE5MSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE4OV8xNDQ5XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcwOCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjE4OSIsImRlc3RpbmF0aW9uSUQiOiIxOTQiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxODlfMTQ0OFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MDkiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxODkiLCJkZXN0aW5hdGlvbklEIjoiMTk5IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTg5XzE0NTJcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzEwIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTg5IiwiZGVzdGluYXRpb25JRCI6IjE5MyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE4OV8xNDUxXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcxMSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjE4OSIsImRlc3RpbmF0aW9uSUQiOiIxOTIiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIxODlfMTQ1MFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MTIiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxODkiLCJkZXN0aW5hdGlvbklEIjoiMTkwIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTg5XzE0NTNcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzEzIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTkxIiwiZGVzdGluYXRpb25JRCI6IjIwNiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MTQiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMDYiLCJkZXN0aW5hdGlvbklEIjoiMTk4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcxNSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjE5OCIsImRlc3RpbmF0aW9uSUQiOiIyMDMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzE2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTk0IiwiZGVzdGluYXRpb25JRCI6IjE5NyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MTciLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxOTciLCJkZXN0aW5hdGlvbklEIjoiMjA0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcxOCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjE5OSIsImRlc3RpbmF0aW9uSUQiOiIyMDAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzE5IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjAwIiwiZGVzdGluYXRpb25JRCI6IjE5NSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MjAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxOTYiLCJkZXN0aW5hdGlvbklEIjoiMjAxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcyMSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjE5MyIsImRlc3RpbmF0aW9uSUQiOiIxOTYiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzIyIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTkzIiwiZGVzdGluYXRpb25JRCI6IjI5MSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjE5M18xNDc2XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcyMyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjE5MiIsImRlc3RpbmF0aW9uSUQiOiIyMDIiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzI0IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTkwIiwiZGVzdGluYXRpb25JRCI6IjIwNSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MjUiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyOTEiLCJkZXN0aW5hdGlvbklEIjoiMjAzIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMTkzXzE0NzZcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzI2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjA1IiwiZGVzdGluYXRpb25JRCI6IjIwMyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MjciLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMDIiLCJkZXN0aW5hdGlvbklEIjoiMjAzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTcyOCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIwMSIsImRlc3RpbmF0aW9uSUQiOiIyMDMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzI5IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTk1IiwiZGVzdGluYXRpb25JRCI6IjIwMyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MzAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMDQiLCJkZXN0aW5hdGlvbklEIjoiMjAzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTczMSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIwMyIsImRlc3RpbmF0aW9uSUQiOiIyMDciLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyMDNfMTU0NlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MzIiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMDMiLCJkZXN0aW5hdGlvbklEIjoiMjEwIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjAzXzE1NDRcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzMzIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjAzIiwiZGVzdGluYXRpb25JRCI6IjIxMyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjIwM18xNTM3XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTczNCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIwMyIsImRlc3RpbmF0aW9uSUQiOiIyMTYiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyMDNfMTUzOFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MzUiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMDMiLCJkZXN0aW5hdGlvbklEIjoiMjE5IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjAzXzE1MzlcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzM2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjAzIiwiZGVzdGluYXRpb25JRCI6IjIyMSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjIwM18xNTQxXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTczNyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIwNyIsImRlc3RpbmF0aW9uSUQiOiIyMDgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzM4IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjA4IiwiZGVzdGluYXRpb25JRCI6IjIwOSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3MzkiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMTAiLCJkZXN0aW5hdGlvbklEIjoiMjExIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc0MCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIxMSIsImRlc3RpbmF0aW9uSUQiOiIyMTIiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzQxIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjEzIiwiZGVzdGluYXRpb25JRCI6IjIxNCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NDIiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMTQiLCJkZXN0aW5hdGlvbklEIjoiMjE1IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc0MyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIxNiIsImRlc3RpbmF0aW9uSUQiOiIyMTciLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzQ0IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjE3IiwiZGVzdGluYXRpb25JRCI6IjIxOCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NDUiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMTkiLCJkZXN0aW5hdGlvbklEIjoiMjIwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc0NiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIyMSIsImRlc3RpbmF0aW9uSUQiOiIyMjIiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzQ3IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjE2IiwiZGVzdGluYXRpb25JRCI6IjI5MiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjIxNl8xNjI2XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc0OCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIwOSIsImRlc3RpbmF0aW9uSUQiOiIyMjMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzQ5IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjEyIiwiZGVzdGluYXRpb25JRCI6IjIyMyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NTAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMTUiLCJkZXN0aW5hdGlvbklEIjoiMjIzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc1MSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIxOCIsImRlc3RpbmF0aW9uSUQiOiIyMjMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzUyIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjIwIiwiZGVzdGluYXRpb25JRCI6IjIyMyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NTMiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMjIiLCJkZXN0aW5hdGlvbklEIjoiMjIzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc1NCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI5MiIsImRlc3RpbmF0aW9uSUQiOiIyMjMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzU1IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjIzIiwiZGVzdGluYXRpb25JRCI6IjIzOSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjIyM18xNjYzXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc1NiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIyMyIsImRlc3RpbmF0aW9uSUQiOiIyMzYiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyMjNfMTY2MVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NTciLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMjMiLCJkZXN0aW5hdGlvbklEIjoiMjMzIiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjIzXzE2NTRcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzU4IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjIzIiwiZGVzdGluYXRpb25JRCI6IjIzMCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjIyM18xNjU1XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc1OSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIyMyIsImRlc3RpbmF0aW9uSUQiOiIyMjciLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyMjNfMTY1NlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NjAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMjMiLCJkZXN0aW5hdGlvbklEIjoiMjI1IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjIzXzE2NThcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzYxIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjI1IiwiZGVzdGluYXRpb25JRCI6IjIyNCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NjIiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMjciLCJkZXN0aW5hdGlvbklEIjoiMjI2IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc2MyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIzMCIsImRlc3RpbmF0aW9uSUQiOiIyOTMiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyMzBfMTY5NFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NjQiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMzAiLCJkZXN0aW5hdGlvbklEIjoiMjI5IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc2NSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIyOSIsImRlc3RpbmF0aW9uSUQiOiIyMjgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzY2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjMzIiwiZGVzdGluYXRpb25JRCI6IjIzMiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NjciLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMzIiLCJkZXN0aW5hdGlvbklEIjoiMjMxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc2OCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIzNiIsImRlc3RpbmF0aW9uSUQiOiIyMzUiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzY5IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjM1IiwiZGVzdGluYXRpb25JRCI6IjIzNCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NzAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMzgiLCJkZXN0aW5hdGlvbklEIjoiMjM5IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjM5XzE3NTdcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifSx7XCJpbnRlcmFjdGlvblwiOlwiMjM5XzE3NThcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6Ik9SIn0seyJpZCI6Ijk3NzEiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMzgiLCJkZXN0aW5hdGlvbklEIjoiMjM3IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc3MiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIzNyIsImRlc3RpbmF0aW9uSUQiOiIyNDAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzczIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjM0IiwiZGVzdGluYXRpb25JRCI6IjI0MCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NzQiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMzEiLCJkZXN0aW5hdGlvbklEIjoiMjQwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc3NSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIyOCIsImRlc3RpbmF0aW9uSUQiOiIyNDAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Nzc2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjI2IiwiZGVzdGluYXRpb25JRCI6IjI0MCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NzciLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyMjQiLCJkZXN0aW5hdGlvbklEIjoiMjQwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc3OCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI0MCIsImRlc3RpbmF0aW9uSUQiOiIyNDEiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyNDBfMTc3MFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3NzkiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNDAiLCJkZXN0aW5hdGlvbklEIjoiMjQ2IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjQwXzE3NjhcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzgwIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjQwIiwiZGVzdGluYXRpb25JRCI6IjI0OSIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI0MF8xNzYxXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc4MSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI0MCIsImRlc3RpbmF0aW9uSUQiOiIyNTIiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyNDBfMTc2MlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3ODIiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNDAiLCJkZXN0aW5hdGlvbklEIjoiMjU0IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjQwXzE3NjNcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzgzIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjQwIiwiZGVzdGluYXRpb25JRCI6IjI1NiIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI0MF8xNzY1XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc4NCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI1MiIsImRlc3RpbmF0aW9uSUQiOiIyOTQiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyNTJfMTg0NVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3ODUiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNDEiLCJkZXN0aW5hdGlvbklEIjoiMjQyIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc4NiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI0NiIsImRlc3RpbmF0aW9uSUQiOiIyNDUiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Nzg3IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjQ5IiwiZGVzdGluYXRpb25JRCI6IjI0OCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3ODgiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNTIiLCJkZXN0aW5hdGlvbklEIjoiMjUxIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc4OSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI1NCIsImRlc3RpbmF0aW9uSUQiOiIyNTMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzkwIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjU2IiwiZGVzdGluYXRpb25JRCI6IjI1NSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3OTEiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNDIiLCJkZXN0aW5hdGlvbklEIjoiMjQzIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc5MiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI0NSIsImRlc3RpbmF0aW9uSUQiOiIyNDQiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5NzkzIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjQ4IiwiZGVzdGluYXRpb25JRCI6IjI0NyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3OTQiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNTEiLCJkZXN0aW5hdGlvbklEIjoiMjUwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc5NSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI0MyIsImRlc3RpbmF0aW9uSUQiOiIyNzMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Nzk2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjQ0IiwiZGVzdGluYXRpb25JRCI6IjI3MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk3OTciLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNDciLCJkZXN0aW5hdGlvbklEIjoiMjczIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTc5OCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI1MCIsImRlc3RpbmF0aW9uSUQiOiIyNzMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5Nzk5IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjUzIiwiZGVzdGluYXRpb25JRCI6IjI3MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MDAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNTUiLCJkZXN0aW5hdGlvbklEIjoiMjczIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgwMSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI5MyIsImRlc3RpbmF0aW9uSUQiOiIyNDAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODAyIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjk0IiwiZGVzdGluYXRpb25JRCI6IjI3MyIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MDMiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNjgiLCJkZXN0aW5hdGlvbklEIjoiMjk1IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjY4XzE5NDFcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODA0IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjcyIiwiZGVzdGluYXRpb25JRCI6IjI3MSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MDUiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNzAiLCJkZXN0aW5hdGlvbklEIjoiMjY5IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgwNiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI2OCIsImRlc3RpbmF0aW9uSUQiOiIyNjciLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODA3IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjY3IiwiZGVzdGluYXRpb25JRCI6IjI2NiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MDgiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNjUiLCJkZXN0aW5hdGlvbklEIjoiMjY0IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgwOSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI2NCIsImRlc3RpbmF0aW9uSUQiOiIyNjMiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODEwIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjYyIiwiZGVzdGluYXRpb25JRCI6IjI2MSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MTEiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNjEiLCJkZXN0aW5hdGlvbklEIjoiMjYwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgxMiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI3MyIsImRlc3RpbmF0aW9uSUQiOiIyNjIiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyNzNfMTk3MFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MTMiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNTciLCJkZXN0aW5hdGlvbklEIjoiMjU4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgxNCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI1OCIsImRlc3RpbmF0aW9uSUQiOiIyNTkiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODE1IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjczIiwiZGVzdGluYXRpb25JRCI6IjI1NyIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI3M18xOTcyXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgxNiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI3MyIsImRlc3RpbmF0aW9uSUQiOiIyNjUiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyNzNfMTk2M1wiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MTciLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNzMiLCJkZXN0aW5hdGlvbklEIjoiMjY4IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjczXzE5NjRcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODE4IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjczIiwiZGVzdGluYXRpb25JRCI6IjI3MCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI3M18xOTY1XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgxOSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI3MyIsImRlc3RpbmF0aW9uSUQiOiIyNzIiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyNzNfMTk2N1wiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MjAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNTkiLCJkZXN0aW5hdGlvbklEIjoiMjkwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgyMSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI2MCIsImRlc3RpbmF0aW9uSUQiOiIyOTAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODIyIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjYzIiwiZGVzdGluYXRpb25JRCI6IjI5MCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MjMiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNjYiLCJkZXN0aW5hdGlvbklEIjoiMjkwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgyNCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI2OSIsImRlc3RpbmF0aW9uSUQiOiIyOTAiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODI1IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjcxIiwiZGVzdGluYXRpb25JRCI6IjI5MCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MjYiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyOTUiLCJkZXN0aW5hdGlvbklEIjoiMjkwIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgyNyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI5MCIsImRlc3RpbmF0aW9uSUQiOiIyNzQiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyOTBfMjA3OFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MjgiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyOTAiLCJkZXN0aW5hdGlvbklEIjoiMjc3IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjkwXzIwNzZcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODI5IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjkwIiwiZGVzdGluYXRpb25JRCI6IjI4MCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI5MF8yMDY5XCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgzMCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI5MCIsImRlc3RpbmF0aW9uSUQiOiIyODMiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyOTBfMjA3MFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MzEiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyOTAiLCJkZXN0aW5hdGlvbklEIjoiMjg2IiwiY29uZGl0aW9ucyI6Ilt7XCJpbnRlcmFjdGlvblwiOlwiMjkwXzIwNzFcIixcImFjdGlvblwiOlwiY2xpY2tlZFwifV0iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODMyIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjkwIiwiZGVzdGluYXRpb25JRCI6IjI4OCIsImNvbmRpdGlvbnMiOiJbe1wiaW50ZXJhY3Rpb25cIjpcIjI5MF8yMDczXCIsXCJhY3Rpb25cIjpcImNsaWNrZWRcIn1dIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgzMyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI3NCIsImRlc3RpbmF0aW9uSUQiOiIyNzUiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODM0IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjc1IiwiZGVzdGluYXRpb25JRCI6IjI3NiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MzUiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNzciLCJkZXN0aW5hdGlvbklEIjoiMjc4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgzNiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI3OCIsImRlc3RpbmF0aW9uSUQiOiIyNzkiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODM3IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjgwIiwiZGVzdGluYXRpb25JRCI6IjI4MSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4MzgiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyODEiLCJkZXN0aW5hdGlvbklEIjoiMjgyIiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTgzOSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI4MyIsImRlc3RpbmF0aW9uSUQiOiIyODQiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODQwIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjg0IiwiZGVzdGluYXRpb25JRCI6IjI4NSIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NDEiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyODYiLCJkZXN0aW5hdGlvbklEIjoiMjg3IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTg0MiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI4OCIsImRlc3RpbmF0aW9uSUQiOiIyODkiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODQzIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjgzIiwiZGVzdGluYXRpb25JRCI6IjI5NiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NDQiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyOTYiLCJkZXN0aW5hdGlvbklEIjoiMTg4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTg0NSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI4OSIsImRlc3RpbmF0aW9uSUQiOiIxODgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODQ2IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjg3IiwiZGVzdGluYXRpb25JRCI6IjE4OCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NDciLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyODUiLCJkZXN0aW5hdGlvbklEIjoiMTg4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTg0OCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI4MiIsImRlc3RpbmF0aW9uSUQiOiIxODgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODQ5IiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjc5IiwiZGVzdGluYXRpb25JRCI6IjE4OCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NTAiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNzYiLCJkZXN0aW5hdGlvbklEIjoiMTg4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTg1MSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjE4OCIsImRlc3RpbmF0aW9uSUQiOiIxODUiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODUyIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMTg1IiwiZGVzdGluYXRpb25JRCI6IjE4NiIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NTMiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxODYiLCJkZXN0aW5hdGlvbklEIjoiMTg3IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTg1NCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIwMyIsImRlc3RpbmF0aW9uSUQiOiIyOTIiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyMDNfMTU0MlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIyMDNfMTU0MFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTg1NSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIyMyIsImRlc3RpbmF0aW9uSUQiOiIyOTMiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyMjNfMTY1OVwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIyMjNfMTY1N1wiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTg1NiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI0MCIsImRlc3RpbmF0aW9uSUQiOiIyOTQiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyNDBfMTc2NlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIyNDBfMTc2NFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTg1NyIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI3MyIsImRlc3RpbmF0aW9uSUQiOiIyOTUiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyNzNfMTk2OFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIyNzNfMTk2NlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTg1OCIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI5MCIsImRlc3RpbmF0aW9uSUQiOiIyOTYiLCJjb25kaXRpb25zIjoiW3tcImludGVyYWN0aW9uXCI6XCIyOTBfMjA3NFwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9LHtcImludGVyYWN0aW9uXCI6XCIyOTBfMjA3MlwiLFwiYWN0aW9uXCI6XCJjbGlja2VkXCJ9XSIsIm9wZXJhdG9yIjoiT1IifSx7ImlkIjoiOTg1OSIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjI5MCIsImRlc3RpbmF0aW9uSUQiOiIxODgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODYwIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjczIiwiZGVzdGluYXRpb25JRCI6IjE4OCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NjEiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIyNDAiLCJkZXN0aW5hdGlvbklEIjoiMTg4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifSx7ImlkIjoiOTg2MiIsImZvcm1JRCI6IjkiLCJvcmlnaW5JRCI6IjIyMyIsImRlc3RpbmF0aW9uSUQiOiIxODgiLCJjb25kaXRpb25zIjoiW10iLCJvcGVyYXRvciI6IiJ9LHsiaWQiOiI5ODYzIiwiZm9ybUlEIjoiOSIsIm9yaWdpbklEIjoiMjAzIiwiZGVzdGluYXRpb25JRCI6IjE4OCIsImNvbmRpdGlvbnMiOiJbXSIsIm9wZXJhdG9yIjoiIn0seyJpZCI6Ijk4NjQiLCJmb3JtSUQiOiI5Iiwib3JpZ2luSUQiOiIxODkiLCJkZXN0aW5hdGlvbklEIjoiMTg4IiwiY29uZGl0aW9ucyI6IltdIiwib3BlcmF0b3IiOiIifV0sImNsb3NlX3VybCI6IiMiLCJyZWRpcmVjdGlvbnMiOlt7ImlkIjoiNyIsImZvcm1JRCI6IjkiLCJjb25kaXRpb25zIjoiW10iLCJjb25kaXRpb25zT3BlcmF0b3IiOiIiLCJ1cmwiOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS8ifSx7ImlkIjoiOCIsImZvcm1JRCI6IjkiLCJjb25kaXRpb25zIjoiW10iLCJjb25kaXRpb25zT3BlcmF0b3IiOiIiLCJ1cmwiOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS8ifSx7ImlkIjoiOSIsImZvcm1JRCI6IjkiLCJjb25kaXRpb25zIjoiW10iLCJjb25kaXRpb25zT3BlcmF0b3IiOiIiLCJ1cmwiOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS8ifSx7ImlkIjoiMTAiLCJmb3JtSUQiOiI5IiwiY29uZGl0aW9ucyI6IltdIiwiY29uZGl0aW9uc09wZXJhdG9yIjoiIiwidXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vIn0seyJpZCI6IjExIiwiZm9ybUlEIjoiOSIsImNvbmRpdGlvbnMiOiJbXSIsImNvbmRpdGlvbnNPcGVyYXRvciI6IiIsInVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tLyJ9LHsiaWQiOiIxMiIsImZvcm1JRCI6IjkiLCJjb25kaXRpb25zIjoiW10iLCJjb25kaXRpb25zT3BlcmF0b3IiOiIiLCJ1cmwiOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS8ifV0sInVzZVJlZGlyZWN0aW9uQ29uZGl0aW9ucyI6IjAiLCJ1c2VQZGYiOjEsInR4dF95ZXMiOiJPdWkiLCJ0eHRfbm8iOiJOb24iLCJ0eHRfbGFzdEJ0biI6IlN1Ym1pdCIsInR4dF9idG5TdGVwIjoiTmV4dCAiLCJkYXRlRm9ybWF0IjoiZCBNTSB5eXl5IiwiZGF0ZVBpY2tlckxhbmd1YWdlIjoiIiwidGhvdXNhbmRzU2VwYXJhdG9yIjoiIiwiZGVjaW1hbHNTZXBhcmF0b3IiOiIuIiwibWlsbGlvblNlcGFyYXRvciI6IiIsImJpbGxpb25zU2VwYXJhdG9yIjoiIiwic3VtbWFyeV9oaWRlUXQiOiIxIiwic3VtbWFyeV9oaWRlWmVybyI6IjEiLCJzdW1tYXJ5X2hpZGVaZXJvUXQiOiIxIiwic3VtbWFyeV9oaWRlUHJpY2VzIjoiMSIsInN1bW1hcnlfaGlkZVplcm9EZWNpbWFscyI6IjEiLCJncm91cEF1dG9DbGljayI6IjEiLCJmaWxlc1VwbG9hZF90ZXh0IjoiRHJvcCBmaWxlcyBoZXJlIHRvIHVwbG9hZCIsImZpbGVzVXBsb2FkU2l6ZV90ZXh0IjoiRmlsZSBpcyB0b28gYmlnIChtYXggc2l6ZToge3ttYXhGaWxlc2l6ZX19TUIpIiwiZmlsZXNVcGxvYWRUeXBlX3RleHQiOiJJbnZhbGlkIGZpbGUgdHlwZSIsImZpbGVzVXBsb2FkTGltaXRfdGV4dCI6IllvdSBjYW4gbm90IHVwbG9hZCBhbnkgbW9yZSBmaWxlcyIsInNlbmRDb250YWN0QVNBUCI6IjEiLCJzaG93VG90YWxCb3R0b20iOiIwIiwic3RyaXBlUHViS2V5IjoiIiwic2Nyb2xsVG9wTWFyZ2luIjoiMCIsInNjcm9sbFRvcE1hcmdpbk1vYmlsZSI6IjAiLCJyZWRpcmVjdGlvbkRlbGF5IjoiMCIsImdtYXBfa2V5IjoiIiwidHh0RGlzdGFuY2VFcnJvciI6IkNhbGN1bGF0aW5nIHRoZSBkaXN0YW5jZSBjb3VsZCBub3QgYmUgcGVyZm9ybWVkLCBwbGVhc2UgdmVyaWZ5IHRoZSBpbnB1dCBhZGRyZXNzZXMiLCJjYXB0Y2hhVXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vd3AtY29udGVudC9wbHVnaW5zL1dQX0VzdGltYXRpb25fRm9ybS9pbmNsdWRlcy9jYXB0Y2hhL2dldF9jYXB0Y2hhLnBocCIsInN1bW1hcnlfbm9EZWNpbWFscyI6IjEiLCJzY3JvbGxUb3BQYWdlIjoiMCIsImRpc2FibGVEcm9wZG93bnMiOiIxIiwiaW1nSWNvblN0eWxlIjoiem9vbSIsInN1bW1hcnlfaGlkZUZpbmFsU3RlcCI6IjEiLCJ0aW1lTW9kZUFNIjoiMCIsImVuYWJsZVNoaW5lRnhCdG4iOiIxIiwic3VtbWFyeV9zaG93QWxsUHJpY2VzRW1haWwiOiIwIiwiaW1nVGl0bGVzU3R5bGUiOiIiLCJsYXN0UyI6IjE2NjU0Nzc4ODM5OTMiLCJlbXB0eVdvb0NhcnQiOiIwIiwic2VuZFVybFZhcmlhYmxlcyI6IjAiLCJzZW5kVmFyaWFibGVzTWV0aG9kIjoiIiwiZW5hYmxlWmFwaWVyIjoiMCIsInphcGllcldlYkhvb2siOiIiLCJzdW1tYXJ5X3Nob3dEZXNjcmlwdGlvbnMiOiIxIiwiaW1nUHJldmlldyI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWNvbnRlbnQvcGx1Z2lucy9XUF9Fc3RpbWF0aW9uX0Zvcm0vYXNzZXRzL2ltZy9maWxlLTMtMTI4LnBuZyIsInByb2dyZXNzQmFyUHJpY2VUeXBlIjoiIiwicmF6b3JwYXlfcHVibGlzaEtleSI6IiIsInJhem9ycGF5X2xvZ29JbWciOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS93cC1jb250ZW50L3VwbG9hZHMvMjAyMi8xMC9jcmVkaXRDYXJkQDJ4LnBuZyIsInZhcmlhYmxlcyI6W10sInVzZUVtYWlsVmVyaWZpY2F0aW9uIjoiMCIsInR4dF9lbWFpbEFjdGl2YXRpb25Db2RlIjoiRmlsbCB5b3VyIHZlcmlmaWF0aW9uIGNvZGUgaGVyZSIsInR4dF9lbWFpbEFjdGl2YXRpb25JbmZvIjoiQSB1bmlxdWUgdmVyaWZpY2F0aW9uIGNvZGUgaGFzIGp1c3QgYmVlbiBzZW50IHRvIHlvdSBieSBlbWFpbCwgcGxlYXNlIGNvcHkgaXQgaW4gdGhlIGZpZWxkIGJlbG93IHRvIHZhbGlkYXRlIHlvdXIgZW1haWwgYWRkcmVzcy4iLCJ1c2VDYXB0Y2hhIjoiMCIsInJlY2FwdGNoYTNLZXkiOiIiLCJkaXN0YW5jZXNNb2RlIjoicm91dGUiLCJlbmFibGVDdXN0b21lckFjY291bnQiOiIwIiwidHh0Q3VzdG9tZXJzRGF0YUZvcmdvdFBhc3NTZW50IjoiIiwidHh0Q3VzdG9tZXJzRGF0YUZvcmdvdFBhc3NMaW5rIjoiIiwiZW1haWxDdXN0b21lckxpbmtzIjoiMSIsImVuYWJsZVBkZkRvd25sb2FkIjoiMSIsInVzZVNpZ25hdHVyZSI6IjAiLCJ1c2VWQVQiOiIwIiwidmF0QW1vdW50IjoiMjAiLCJ2YXRMYWJlbCI6IlZBVCIsImF1dG9jbG9zZURhdGVwaWNrZXIiOiIwIiwiZmxvYXRTdW1tYXJ5X3Nob3dJbmZvIjoiMSIsImhpZGVGaW5hbGJ0biI6IjAiLCJjYXJ0UGFnZSI6IiIsImRpc2FibGVTY3JvbGwiOiIwIn1d" defer></script>
<script data-optimized="1" id="lfb_frontend-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/5c752d5e3cc9177fc9f2089b272f6953.js?ver=e2f1b" defer data-deferred="1"></script>
<script id="wc-cashfree-checkout-js-js" defer data-deferred="1" data-type="lazy" data-src="https://sdk.cashfree.com/js/v3/cashfree.js?ver=4.8.1"></script>
<script data-optimized="1" id="wc-cashfree-checkout-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/5f4daa15f48fb910879c5b1559eb3ddf.js?ver=39a39" defer data-deferred="1"></script>
<script data-optimized="1" id="swv-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/5c4746a16ccf2a303e2c2c557c3c7f76.js?ver=9d723"></script>
<script id="contact-form-7-js-translations" src="data:text/javascript;base64,KGZ1bmN0aW9uKGRvbWFpbix0cmFuc2xhdGlvbnMpe3ZhciBsb2NhbGVEYXRhPXRyYW5zbGF0aW9ucy5sb2NhbGVfZGF0YVtkb21haW5dfHx0cmFuc2xhdGlvbnMubG9jYWxlX2RhdGEubWVzc2FnZXM7bG9jYWxlRGF0YVsiIl0uZG9tYWluPWRvbWFpbjt3cC5pMThuLnNldExvY2FsZURhdGEobG9jYWxlRGF0YSxkb21haW4pfSkoImNvbnRhY3QtZm9ybS03Iix7InRyYW5zbGF0aW9uLXJldmlzaW9uLWRhdGUiOiIyMDI2LTA5LTI5IDA4OjIyOjQxKzAwMDAiLCJnZW5lcmF0b3IiOiJHbG90UHJlc3NcLzQuMS4wIiwiZG9tYWluIjoibWVzc2FnZXMiLCJsb2NhbGVfZGF0YSI6eyJtZXNzYWdlcyI6eyIiOnsiZG9tYWluIjoibWVzc2FnZXMiLCJwbHVyYWwtZm9ybXMiOiJucGx1cmFscz0yOyBwbHVyYWw9biA+IDE7IiwibGFuZyI6ImZyIn0sIlRoaXMgY29udGFjdCBmb3JtIGlzIHBsYWNlZCBpbiB0aGUgd3JvbmcgcGxhY2UuIjpbIkNlIGZvcm11bGFpcmUgZGUgY29udGFjdCBlc3QgcGxhY1x1MDBlOSBkYW5zIHVuIG1hdXZhaXMgZW5kcm9pdC4iXSwiRXJyb3I6IjpbIkVycmV1clx1MDBhMDoiXX19LCJjb21tZW50Ijp7InJlZmVyZW5jZSI6ImluY2x1ZGVzXC9qc1wvaW5kZXguanMifX0p" defer></script>
<script id="contact-form-7-js-before" src="data:text/javascript;base64,dmFyIHdwY2Y3PXsiYXBpIjp7InJvb3QiOiJodHRwczpcL1wvd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tXC9mclwvd3AtanNvblwvIiwibmFtZXNwYWNlIjoiY29udGFjdC1mb3JtLTdcL3YxIn0sImNhY2hlZCI6MX0=" defer></script>
<script data-optimized="1" id="contact-form-7-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/cd0cd797ad2fba059531badb3e355fa3.js?ver=00ef2"></script>
<script data-optimized="1" id="nbcpf-intlTelInput-script-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/330de25c30a33ebaf65f95c4ad2085f1.js?ver=4f662"></script>
<script id="nbcpf-countryFlag-script-js-extra" src="data:text/javascript;base64,dmFyIG5iY3BmPXsiYWpheHVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWFkbWluL2FkbWluLWFqYXgucGhwIn0=" defer></script>
<script data-optimized="1" id="nbcpf-countryFlag-script-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/993b5808baa02386ce86789f7da94679.js?ver=2db17"></script>
<script id="nbcpf-countryFlag-script-js-after" src="data:text/javascript;base64,KGZ1bmN0aW9uKCQpeyQoZnVuY3Rpb24oKXskKCIud3BjZjctY291bnRyeXRleHQiKS5jb3VudHJ5U2VsZWN0KHt9KTskKCIud3BjZjctcGhvbmV0ZXh0IikuaW50bFRlbElucHV0KHthdXRvSGlkZURpYWxDb2RlOiEwLGF1dG9QbGFjZWhvbGRlcjohMCxuYXRpb25hbE1vZGU6ITEsc2VwYXJhdGVEaWFsQ29kZTohMCxoaWRkZW5JbnB1dDoiZnVsbF9udW1iZXIiLH0pOyQoIi53cGNmNy1waG9uZXRleHQiKS5lYWNoKGZ1bmN0aW9uKCl7dmFyIGhpZGRlbklucHV0PSQodGhpcykuYXR0cignbmFtZScpO3ZhciBkaWFsX2NvZGU9JCh0aGlzKS5zaWJsaW5ncygiLmZsYWctY29udGFpbmVyIikuZmluZCgiLnNlbGVjdGVkLWZsYWcgLnNlbGVjdGVkLWRpYWwtY29kZSIpLnRleHQoKTskKCJpbnB1dFtuYW1lPSIraGlkZGVuSW5wdXQrIi1jb3VudHJ5LWNvZGVdIikudmFsKGRpYWxfY29kZSl9KTskKCIud3BjZjctcGhvbmV0ZXh0Iikub24oImNvdW50cnljaGFuZ2UiLGZ1bmN0aW9uKCl7dmFyIGhpZGRlbklucHV0PSQodGhpcykuYXR0cigibmFtZSIpO3ZhciBkaWFsX2NvZGU9JCh0aGlzKS5zaWJsaW5ncygiLmZsYWctY29udGFpbmVyIikuZmluZCgiLnNlbGVjdGVkLWZsYWcgLnNlbGVjdGVkLWRpYWwtY29kZSIpLnRleHQoKTskKCJpbnB1dFtuYW1lPSIraGlkZGVuSW5wdXQrIi1jb3VudHJ5LWNvZGVdIikudmFsKGRpYWxfY29kZSl9KTt2YXIgaXNNb2JpbGU9L0FuZHJvaWQuK01vYmlsZXx3ZWJPU3xpUGhvbmV8aVBvZHxCbGFja0JlcnJ5fElFTW9iaWxlfE9wZXJhIE1pbmkvaS50ZXN0KG5hdmlnYXRvci51c2VyQWdlbnQpOyQoIi53cGNmNy1waG9uZXRleHQiKS5vbigia2V5dXAiLGZ1bmN0aW9uKCl7dmFyIGRpYWxfY29kZT0kKHRoaXMpLnNpYmxpbmdzKCIuZmxhZy1jb250YWluZXIiKS5maW5kKCIuc2VsZWN0ZWQtZmxhZyAuc2VsZWN0ZWQtZGlhbC1jb2RlIikudGV4dCgpO3ZhciB2YWx1ZT0kKHRoaXMpLnZhbCgpO2lmKHZhbHVlPT0iKyIpCiQodGhpcykudmFsKCIiKTtlbHNlIGlmKHZhbHVlLmluZGV4T2YoIisiKT09Ii0xIikKJCh0aGlzKS52YWwoZGlhbF9jb2RlK3ZhbHVlKTtlbHNlIGlmKHZhbHVlLmluZGV4T2YoIisiKT4wKQokKHRoaXMpLnZhbChkaWFsX2NvZGUrdmFsdWUuc3Vic3RyaW5nKGRpYWxfY29kZS5sZW5ndGgpKTt9KTskKCIud3BjZjctY291bnRyeXRleHQiKS5vbigia2V5dXAiLGZ1bmN0aW9uKCl7dmFyIGNvdW50cnlfbmFtZT0kKHRoaXMpLnNpYmxpbmdzKCIuZmxhZy1kcm9wZG93biIpLmZpbmQoIi5jb3VudHJ5LWxpc3QgbGkuYWN0aXZlIHNwYW4uY291bnRyeS1uYW1lIikudGV4dCgpO2lmKGNvdW50cnlfbmFtZT09IiIpCnZhciBjb3VudHJ5X25hbWU9JCh0aGlzKS5zaWJsaW5ncygiLmZsYWctZHJvcGRvd24iKS5maW5kKCIuY291bnRyeS1saXN0IGxpLmhpZ2hsaWdodCBzcGFuLmNvdW50cnktbmFtZSIpLnRleHQoKTt2YXIgdmFsdWU9JCh0aGlzKS52YWwoKTskKHRoaXMpLnZhbChjb3VudHJ5X25hbWUrdmFsdWUuc3Vic3RyaW5nKGNvdW50cnlfbmFtZS5sZW5ndGgpKX0pfSl9KShqUXVlcnkp" defer></script>
<script id="eafl-public-js-extra" src="data:text/javascript;base64,dmFyIGVhZmxfcHVibGljPXsiaG9tZV91cmwiOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS9mci8iLCJhamF4X3VybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWFkbWluL2FkbWluLWFqYXgucGhwIiwibm9uY2UiOiI1NTA0NTc5ZmNiIn0=" defer></script>
<script data-optimized="1" id="eafl-public-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/72af9615f1bafb83a19f2c55bcb11008.js?ver=19bb9" defer data-deferred="1"></script>
<script data-optimized="1" id="underscore-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/656105ac6520e78e77d412aa1c9fdf5b.js?ver=0c53b" defer data-deferred="1"></script>
<script id="paypalplus-woocommerce-front-js-extra" src="data:text/javascript;base64,dmFyIHBwcEZyb250RGF0YUNvbGxlY3Rpb249eyJwYWdlaW5mbyI6eyJpc0NoZWNrb3V0IjohMSwiaXNDaGVja291dFBheVBhZ2UiOiExfSwiaXNDb25mbGljdFZlcnNpb24iOiIxIn0=" defer></script>
<script data-optimized="1" id="paypalplus-woocommerce-front-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/4d1068c96f7149addfc7f137ec517523.js?ver=85722" defer data-deferred="1"></script>
<script data-wp-strategy="async" id="cloudflare-turnstile-js" src="https://challenges.cloudflare.com/turnstile/v0/api.js"></script>
<script id="cloudflare-turnstile-js-after">
document.addEventListener( 'wpcf7submit', e => turnstile.reset() );
//# sourceURL=cloudflare-turnstile-js-after
</script>
<script id="daim-track-internal-links-js-before" src="data:text/javascript;base64,d2luZG93LkRBSU1fUEFSQU1FVEVSUz17YWpheF91cmw6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWFkbWluL2FkbWluLWFqYXgucGhwIixub25jZToiMjJlNzk3YmQ3YyJ9" defer></script>
<script data-optimized="1" id="daim-track-internal-links-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/6d01a6d028937b48180b1df8c62a5866.js?ver=90e80" defer data-deferred="1"></script>
<script data-optimized="1" data-wp-strategy="async" fetchpriority="low" id="comment-reply-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/30a5403410fa872b31989258af99a153.js?ver=1837e" defer data-deferred="1"></script>
<script id="cart-widget-js-extra" src="data:text/javascript;base64,dmFyIGFjdGlvbnM9eyJjdXJyZW50X2xhbmd1YWdlIjoiZnIiLCJmb3JjZV9yZXNldCI6IjAifQ==" defer></script>
<script data-optimized="1" data-wp-strategy="defer" defer id="cart-widget-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/b32ffb8fe1ef1b215581be0b17529bf4.js?ver=188b1"></script>
<script data-optimized="1" id="page-links-to-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/931848cb939a1246e892f804bed5222f.js?ver=abe0c" defer data-deferred="1"></script>
<script data-optimized="1" id="sourcebuster-js-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/33af9a69764a66dda4604a4bf93d71c5.js?ver=780b6" defer data-deferred="1"></script>
<script id="wc-order-attribution-js-extra" src="data:text/javascript;base64,dmFyIHdjX29yZGVyX2F0dHJpYnV0aW9uPXsicGFyYW1zIjp7ImxpZmV0aW1lIjoxLjBlLTUsInNlc3Npb24iOjMwLCJiYXNlNjQiOiExLCJhamF4dXJsIjoiaHR0cHM6Ly93d3cubG93Y29zdHdlYmFnZW5jeS5jb20vd3AtYWRtaW4vYWRtaW4tYWpheC5waHAiLCJwcmVmaXgiOiJ3Y19vcmRlcl9hdHRyaWJ1dGlvbl8iLCJhbGxvd1RyYWNraW5nIjohMH0sImZpZWxkcyI6eyJzb3VyY2VfdHlwZSI6ImN1cnJlbnQudHlwIiwicmVmZXJyZXIiOiJjdXJyZW50X2FkZC5yZiIsInV0bV9jYW1wYWlnbiI6ImN1cnJlbnQuY21wIiwidXRtX3NvdXJjZSI6ImN1cnJlbnQuc3JjIiwidXRtX21lZGl1bSI6ImN1cnJlbnQubWRtIiwidXRtX2NvbnRlbnQiOiJjdXJyZW50LmNudCIsInV0bV9pZCI6ImN1cnJlbnQuaWQiLCJ1dG1fdGVybSI6ImN1cnJlbnQudHJtIiwidXRtX3NvdXJjZV9wbGF0Zm9ybSI6ImN1cnJlbnQucGx0IiwidXRtX2NyZWF0aXZlX2Zvcm1hdCI6ImN1cnJlbnQuZm10IiwidXRtX21hcmtldGluZ190YWN0aWMiOiJjdXJyZW50LnRjdCIsInNlc3Npb25fZW50cnkiOiJjdXJyZW50X2FkZC5lcCIsInNlc3Npb25fc3RhcnRfdGltZSI6ImN1cnJlbnRfYWRkLmZkIiwic2Vzc2lvbl9wYWdlcyI6InNlc3Npb24ucGdzIiwic2Vzc2lvbl9jb3VudCI6InVkYXRhLnZzdCIsInVzZXJfYWdlbnQiOiJ1ZGF0YS51YWcifX0=" defer></script>
<script id="wc-order-attribution-js" src="https://www.lowcostwebagency.com/wp-content/plugins/woocommerce/assets/js/frontend/order-attribution.min.js?ver=11.2.1" defer data-deferred="1"></script>
<script data-optimized="1" id="backbone-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/4f41f71788dbefe3fb7cf9f6b9d59b7c.js?ver=2e6ab" defer data-deferred="1"></script>
<script data-optimized="1" id="backbone.localStorage-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/66d95051c677839d60ceca75f6e17adb.js?ver=54627" defer data-deferred="1"></script>
<script data-optimized="1" id="wc-predictive-search-autocomplete-script-js" defer data-deferred="1" data-type="lazy" data-src="https://www.lowcostwebagency.com/wp-content/litespeed/js/2d67b5bd7ea86fa8800d159f92f51b16.js?ver=e81f0"></script>
<script data-optimized="1" id="wc-predictive-search-backbone-js" defer data-deferred="1" data-type="lazy" data-src="https://www.lowcostwebagency.com/wp-content/litespeed/js/28ceb0cade6f6a1c3c502d50abe6fcbb.js?ver=66e0a"></script>
<script id="wc-predictive-search-popup-backbone-js-extra" defer data-type="lazy" data-src="data:text/javascript;base64,dmFyIHdjX3BzX3ZhcnM9eyJtaW5DaGFycyI6IjEiLCJkZWxheSI6IjYwMCIsImNhY2hlX3RpbWVvdXQiOiIxIiwiaXNfZGVidWciOiJ5ZXMiLCJsZWdhY3lfYXBpX3VybCI6Ii8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL2ZyL3djLWFwaS93Y19wc19sZWdhY3lfYXBpLz9hY3Rpb249Z2V0X3Jlc3VsdF9wb3B1cCIsInNlYXJjaF9wYWdlX3VybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL2ZyL3NlYXJjaC8iLCJwZXJtYWxpbmtfc3RydWN0dXJlIjoiLyVwb3N0bmFtZSUvIiwiaXNfcnRsIjoiIn0="></script>
<script data-optimized="1" id="wc-predictive-search-popup-backbone-js" defer data-deferred="1" data-type="lazy" data-src="https://www.lowcostwebagency.com/wp-content/litespeed/js/d12c9de4ced65974cbd788b88f8c2d8b.js?ver=11c6d"></script>
<script id="quick-view-popup-script-js-extra" src="data:text/javascript;base64,dmFyIHdjX3F2X3ZhcnM9eyJhamF4X3VybCI6Ii93cC1hZG1pbi9hZG1pbi1hamF4LnBocCJ9" defer></script>
<script data-optimized="1" id="quick-view-popup-script-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/f12aca297f2405c74d6f21c8f03a6504.js?ver=65ef2" defer data-deferred="1"></script>
<script id="wpcf7cf-scripts-js-extra" src="data:text/javascript;base64,dmFyIHdwY2Y3Y2ZfZ2xvYmFsX3NldHRpbmdzPXsiYWpheHVybCI6Imh0dHBzOi8vd3d3Lmxvd2Nvc3R3ZWJhZ2VuY3kuY29tL3dwLWFkbWluL2FkbWluLWFqYXgucGhwIn0=" defer></script>
<script data-optimized="1" id="wpcf7cf-scripts-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/f425293af6a8f84ad6e449675dc73a3b.js?ver=a6647" defer data-deferred="1"></script>
<script data-cfasync="false" id="cfturnstile-js-before">
(function(w,d){var q=w.cfturnstileQueue=w.cfturnstileQueue||[];if(w.cfturnstileRender)return;var ready=false,hooked=false,ticks=0,timer=null;var cbs=["callback","error-callback","expired-callback","timeout-callback","unsupported-callback","before-interactive-callback","after-interactive-callback"];function opts(e){var p={};for(var i=0;i<cbs.length;i++){(function(n){var v=e.getAttribute("data-"+n);if(!v)return;p[n]=function(){var f=w[v];if(typeof f==="function")return f.apply(w,arguments);};})(cbs[i]);}return p;}w.cfturnstileOpts=function(e){if(typeof e==="string")e=d.querySelector(e);return e&&e.getAttribute?opts(e):{};};function one(id){var n="cf-turnstile"+id,e=d.getElementById(n);if(e&&e.cfturnstileQueued){e=null;var l=d.querySelectorAll(".cf-turnstile");for(var i=0;i<l.length;i++){if(l[i].id===n&&!l[i].cfturnstileQueued){e=l[i];break;}}}if(!e)return false;if(!e.firstElementChild){try{w.turnstile.render(e,opts(e));}catch(_){return false;}}e.cfturnstileQueued=1;return true;}function drain(){if(!ready)return;for(var i=q.length-1;i>=0;i--){if(one(q[i]))q.splice(i,1);}if(q.length&&!hooked&&d.readyState==="loading"){hooked=true;d.addEventListener("DOMContentLoaded",function(){hooked=false;drain();});}}function watch(){timer=null;if(!q.length)return;if(!ready&&w.turnstile&&typeof w.turnstile.render==="function")ready=true;drain();if(q.length&&++ticks<170)timer=setTimeout(watch,ticks<20?100:2000);}w.cfturnstileRender=function(){drain();if(q.length&&!timer)timer=setTimeout(watch,100);};w.cfturnstileOnload=function(){ready=true;w.cfturnstileRender();};w.cfturnstileRender();})(window,document);
(function(w,d){if(w.cfturnstileRefresh)return;w.cfturnstileRefresh=1;var F="input[name=cf-turnstile-response]",S="form.checkout, form.woocommerce-checkout, form.wc-block-checkout__form",u=false;function go(){u=true;}w.addEventListener("pagehide",go);w.addEventListener("beforeunload",go);d.addEventListener("submit",function(e){var f=e.target,s=[];if(!f||!f.querySelectorAll)return;try{if(S&&f.matches&&f.matches(S))return;}catch(_){}f.querySelectorAll(".cf-turnstile").forEach(function(el){var i=el.querySelector(F);if(i&&i.value)s.push([el,i.value]);});if(!s.length)return;setTimeout(function(){if(u||!w.turnstile||d.querySelector("#wfls-prompt-overlay,#wfls-token,#fls_2fa_form,.fls_2fs"))return;s.forEach(function(x){var i=x[0].querySelector(F);if(i&&i.value===x[1]){try{w.turnstile.reset(x[0]);}catch(_){}}});},2000);},true);})(window,document);
//# sourceURL=cfturnstile-js-before
</script>
<script id="cfturnstile-js" src="https://challenges.cloudflare.com/turnstile/v0/api.js?render=explicit&onload=cfturnstileOnload"></script>
<script data-cfasync="false" id="cfturnstile-js-after">
function turnstileCF7Callback() {
document.querySelectorAll('.wpcf7-submit').forEach(function(el) {
el.style.pointerEvents = 'auto';
el.style.opacity = '1';
});
}
//# sourceURL=cfturnstile-js-after
</script>
<script id="cfturnstile-js-js" src="https://www.lowcostwebagency.com/wp-content/plugins/simple-cloudflare-turnstile/js/disable-submit.js?ver=5.3"></script>
<script data-optimized="1" id="react-jsx-runtime-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/09d93c2c5be72e7a3fed7907b0c459ae.js?ver=25c38" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-deprecated-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/a572d0e79161dad01d3707f87f7ba723.js?ver=37a1b" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-dom-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/98ccef882ba8a3be5661723ab8b7dd51.js?ver=3392f" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-is-shallow-equal-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/0bd3a4bc3720e0ec30ebad3d32827068.js?ver=a184e" defer data-deferred="1"></script>
<script id="wp-keycodes-js-translations" src="data:text/javascript;base64,KGZ1bmN0aW9uKGRvbWFpbix0cmFuc2xhdGlvbnMpe3ZhciBsb2NhbGVEYXRhPXRyYW5zbGF0aW9ucy5sb2NhbGVfZGF0YVtkb21haW5dfHx0cmFuc2xhdGlvbnMubG9jYWxlX2RhdGEubWVzc2FnZXM7bG9jYWxlRGF0YVsiIl0uZG9tYWluPWRvbWFpbjt3cC5pMThuLnNldExvY2FsZURhdGEobG9jYWxlRGF0YSxkb21haW4pfSkoImRlZmF1bHQiLHsidHJhbnNsYXRpb24tcmV2aXNpb24tZGF0ZSI6IjIwMjYtMDQtMjIgMTc6Mzk6MjUrMDAwMCIsImdlbmVyYXRvciI6IldQTUwgU3RyaW5nIFRyYW5zbGF0aW9uIDMuMC4xMiIsImRvbWFpbiI6Im1lc3NhZ2VzIiwibG9jYWxlX2RhdGEiOnsibWVzc2FnZXMiOnsiIjp7ImRvbWFpbiI6Im1lc3NhZ2VzIiwicGx1cmFsLWZvcm1zIjoibnBsdXJhbHM9MjsgcGx1cmFsPW4gIT0gMTsiLCJsYW5nIjoiZnJfRlIifSwiQmFja3RpY2siOlsiUmV0b3VyIGFycmlcdTAwZThyZSJdLCJQZXJpb2QiOlsiUFx1MDBlOXJpb2RlIl0sIkNvbW1hIjpbIlZpcmd1bGUiXSwiVGlsZGUiOlsiVGlsZGUiXX19fSk=" defer></script>
<script data-optimized="1" id="wp-keycodes-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/2927d2da040f2068c3cbd993b0f55145.js?ver=655a1" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-priority-queue-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/51bb0191b650ef22716f1eaf4c8554e7.js?ver=14b9d" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-private-apis-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/495f9a7e99b9c301e8e31f1a5dc4d250.js?ver=71beb" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-undo-manager-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/d0df5071163c01073456e9b251e45001.js?ver=4514b" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-compose-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/81117f563da4dfc95496dba8b863bca7.js?ver=36fc0" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-redux-routine-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/9e9c3f9d09f508e1cac1ecc7a68a34b7.js?ver=54a51" defer data-deferred="1"></script>
<script data-optimized="1" id="wp-data-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/415b285dcba0872c0ec639161c17c80a.js?ver=ced99" defer data-deferred="1"></script>
<script id="wp-data-js-after" src="data:text/javascript;base64,KGZ1bmN0aW9uKCl7dmFyIHVzZXJJZD0wO3ZhciBzdG9yYWdlS2V5PSJXUF9EQVRBX1VTRVJfIit1c2VySWQ7d3AuZGF0YS51c2Uod3AuZGF0YS5wbHVnaW5zLnBlcnNpc3RlbmNlLHtzdG9yYWdlS2V5OnN0b3JhZ2VLZXl9KX0pKCk=" defer></script>
<script id="cfturnstile-woo-js-js" src="https://www.lowcostwebagency.com/wp-content/plugins/simple-cloudflare-turnstile/js/integrations/woocommerce.js?ver=2.2"></script>
<script data-cfasync="false" id="cfturnstile-render-js-after">
(window.cfturnstileQueue=window.cfturnstileQueue||[]).push("-cf7-1051939272");if(window.cfturnstileRender)window.cfturnstileRender();
//# sourceURL=cfturnstile-render-js-after
</script>
<script data-optimized="1" id="gsap-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/fb56464d155d0d850b928f04635dbe45.js?ver=340a8" defer data-deferred="1"></script>
<script data-optimized="1" id="gsap-scroll-trigger-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/8a578a608a8a925086d309c93f3bc9f5.js?ver=862ad" defer data-deferred="1"></script>
<script data-optimized="1" id="awb-tabs-widget-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/ee29fb7c9a47d6c1e1f7be2d5a3c1f40.js?ver=f4c32" defer data-deferred="1"></script>
<script data-optimized="1" id="awb-vertical-menu-widget-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/07bd413d4338894ab9180be6356f7ac5.js?ver=683fd" defer data-deferred="1"></script>
<script data-optimized="1" id="cssua-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/c0c29014335ca5324de497cb5141ec7d.js?ver=5e56e" defer data-deferred="1"></script>
<script data-optimized="1" id="modernizr-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/3b045c0f957ec59627aa7d85ef01b2b3.js?ver=9171b" defer data-deferred="1"></script>
<script id="fusion-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkpTVmFycz17InZpc2liaWxpdHlfc21hbGwiOiI2NDAiLCJ2aXNpYmlsaXR5X21lZGl1bSI6IjEwMjQifQ==" defer></script>
<script data-optimized="1" id="fusion-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/1eed82425cbd4ccf118f66e1ce36750e.js?ver=86d3e" defer data-deferred="1"></script>
<script data-optimized="1" id="swiper-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/3ba1f9981e2239364bb394dfd7ba96cb.js?ver=50bb6" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-request-animation-frame-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/2329bdfa0b2709536e7fee09b0aae0a3.js?ver=69a97" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-easing-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/8f2687d7e18eb14d70271cadbad42166.js?ver=042c9" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-fitvids-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/16dacc24bf6d2661745b81e6fc260541.js?ver=15fc2" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-flexslider-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/364a2eb5d2c0c69c1698b6cf523065c2.js?ver=34ca4" defer data-deferred="1"></script>
<script id="jquery-lightbox-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkxpZ2h0Ym94VmlkZW9WYXJzPXsibGlnaHRib3hfdmlkZW9fd2lkdGgiOiIxMjgwIiwibGlnaHRib3hfdmlkZW9faGVpZ2h0IjoiNzIwIn0=" defer></script>
<script data-optimized="1" id="jquery-lightbox-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/12ed22fe016348b849b9978c5ff87793.js?ver=40104" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-mousewheel-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/6a1f843c9c785a2d996ae87226862921.js?ver=0850c" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-fade-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/da17fab4f6c9ef23e4430a9de3556a65.js?ver=33352" defer data-deferred="1"></script>
<script id="fusion-equal-heights-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkVxdWFsSGVpZ2h0VmFycz17ImNvbnRlbnRfYnJlYWtfcG9pbnQiOiI4MDAifQ==" defer></script>
<script data-optimized="1" id="fusion-equal-heights-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/03d955b96d3f3def89ce3c76d088727e.js?ver=7a5ce" defer data-deferred="1"></script>
<script data-optimized="1" id="fusion-parallax-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/e07bcd5d79541b80af6318dc68a3d6d8.js?ver=3fd9d" defer data-deferred="1"></script>
<script id="fusion-video-general-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvblZpZGVvR2VuZXJhbFZhcnM9eyJzdGF0dXNfdmltZW8iOiIxIiwic3RhdHVzX3l0IjoiMSJ9" defer></script>
<script data-optimized="1" id="fusion-video-general-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/61646f92dd9072f96d8be7b0509deb12.js?ver=3c4df" defer data-deferred="1"></script>
<script id="fusion-video-bg-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvblZpZGVvQmdWYXJzPXsic3RhdHVzX3ZpbWVvIjoiMSIsInN0YXR1c195dCI6IjEiLCJ0aXRsZSI6IkJhY2tncm91bmQgdmlkZW8ifQ==" defer></script>
<script data-optimized="1" id="fusion-video-bg-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/d7aba9106308a658d02b124c3e80c575.js?ver=b2d86" defer data-deferred="1"></script>
<script id="fusion-lightbox-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkxpZ2h0Ym94VmFycz17InN0YXR1c19saWdodGJveCI6IjEiLCJsaWdodGJveF9nYWxsZXJ5IjoiMSIsImxpZ2h0Ym94X3NraW4iOiJtZXRyby13aGl0ZSIsImxpZ2h0Ym94X3RpdGxlIjoiIiwibGlnaHRib3hfem9vbSI6IjEiLCJsaWdodGJveF9hcnJvd3MiOiIxIiwibGlnaHRib3hfc2xpZGVzaG93X3NwZWVkIjoiNTAwMCIsImxpZ2h0Ym94X2xvb3AiOiIwIiwibGlnaHRib3hfYXV0b3BsYXkiOiIiLCJsaWdodGJveF9vcGFjaXR5IjoiMC45NyIsImxpZ2h0Ym94X2Rlc2MiOiIiLCJsaWdodGJveF9zb2NpYWwiOiIxIiwibGlnaHRib3hfc29jaWFsX2xpbmtzIjp7ImZhY2Vib29rIjp7InNvdXJjZSI6Imh0dHBzOi8vd3d3LmZhY2Vib29rLmNvbS9zaGFyZXIucGhwP3U9e1VSTH0iLCJ0ZXh0IjoiU2hhcmUgb24gRmFjZWJvb2sifSwidHdpdHRlciI6eyJzb3VyY2UiOiJodHRwczovL3guY29tL2ludGVudC9wb3N0P3VybD17VVJMfSIsInRleHQiOiJTaGFyZSBvbiBYIn0sInJlZGRpdCI6eyJzb3VyY2UiOiJodHRwczovL3JlZGRpdC5jb20vc3VibWl0P3VybD17VVJMfSIsInRleHQiOiJTaGFyZSBvbiBSZWRkaXQifSwibGlua2VkaW4iOnsic291cmNlIjoiaHR0cHM6Ly93d3cubGlua2VkaW4uY29tL3NoYXJpbmcvc2hhcmUtb2Zmc2l0ZS8/dXJsPXtVUkx9IiwidGV4dCI6IlNoYXJlIG9uIExpbmtlZEluIn0sIndoYXRzYXBwIjp7InNvdXJjZSI6Imh0dHBzOi8vYXBpLndoYXRzYXBwLmNvbS9zZW5kP3RleHQ9e1VSTH0iLCJ0ZXh0IjoiU2hhcmUgb24gV2hhdHNBcHAifSwidHVtYmxyIjp7InNvdXJjZSI6Imh0dHBzOi8vd3d3LnR1bWJsci5jb20vc2hhcmUvbGluaz91cmw9e1VSTH0iLCJ0ZXh0IjoiU2hhcmUgb24gVHVtYmxyIn0sInBpbnRlcmVzdCI6eyJzb3VyY2UiOiJodHRwczovL3BpbnRlcmVzdC5jb20vcGluL2NyZWF0ZS9idXR0b24vP3VybD17VVJMfSIsInRleHQiOiJTaGFyZSBvbiBQaW50ZXJlc3QifSwidmsiOnsic291cmNlIjoiaHR0cHM6Ly92ay5jb20vc2hhcmUucGhwP3VybD17VVJMfSIsInRleHQiOiJTaGFyZSBvbiBWayJ9LCJ4aW5nIjp7InNvdXJjZSI6Imh0dHBzOi8vd3d3LnhpbmcuY29tL3NvY2lhbC9zaGFyZS9zcGk/dXJsPXtVUkx9IiwidGV4dCI6IlNoYXJlIG9uIFhpbmcifSwibWFpbCI6eyJzb3VyY2UiOiJtYWlsdG86P2JvZHk9e1VSTH0iLCJ0ZXh0IjoiU2hhcmUgYnkgRW1haWwifX0sImxpZ2h0Ym94X2RlZXBsaW5raW5nIjoiMSIsImxpZ2h0Ym94X3BhdGgiOiJob3Jpem9udGFsIiwibGlnaHRib3hfcG9zdF9pbWFnZXMiOiIiLCJsaWdodGJveF9hbmltYXRpb25fc3BlZWQiOiJmYXN0IiwibDEwbiI6eyJjbG9zZSI6IlByZXNzIEVzYyB0byBjbG9zZSIsImVudGVyRnVsbHNjcmVlbiI6IkVudGVyIEZ1bGxzY3JlZW4gKFNoaWZ0K0VudGVyKSIsImV4aXRGdWxsc2NyZWVuIjoiRXhpdCBGdWxsc2NyZWVuIChTaGlmdCtFbnRlcikiLCJzbGlkZVNob3ciOiJTbGlkZXNob3ciLCJuZXh0IjoiTmV4dCIsInByZXZpb3VzIjoiUHJldmlvdXMifX0=" defer></script>
<script data-optimized="1" id="fusion-lightbox-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/e05c6b1d06f825187c78b387915ad28d.js?ver=48219" defer data-deferred="1"></script>
<script data-optimized="1" id="jquery-sticky-kit-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/ab3b872e652a347008df3d19d35da2a5.js?ver=34afe" defer data-deferred="1"></script>
<script data-optimized="1" id="fusion-youtube-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/05af21fe143c935c86c4257c5176c758.js?ver=e4afe" defer data-deferred="1"></script>
<script data-optimized="1" id="vimeo-player-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/44101fb2ad5f195f5920bc615213d7c3.js?ver=55542" defer data-deferred="1"></script>
<script data-optimized="1" id="fusion-general-global-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/e2eb9de8358f959e1a2e711ba040ec86.js?ver=2ae7c" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-woo-product-variations-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/6adb6e52684749ed6821450688ce6bf9.js?ver=91729" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-general-footer-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/38b622b0a7c1cc843f3175256787cee9.js?ver=7f4d4" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-quantity-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/ba8256d54aa719dc57693c04a591fe35.js?ver=52d1a" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-crossfade-images-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/0333df7e7dcecf98df78d292e6a00dc6.js?ver=134a0" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-select-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/eae4a86f42b893c891c99f72671a0bf6.js?ver=18e3e" defer data-deferred="1"></script>
<script id="avada-wpml-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhTGFuZ3VhZ2VWYXJzPXsibGFuZ3VhZ2VfZmxhZyI6ImZyIn0=" defer></script>
<script data-optimized="1" id="avada-wpml-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/81d87e1916421000a4d0e256c77cd38e.js?ver=95348" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-contact-form-7-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/cba694cff2c7f4c72e7a2fdc693ca508.js?ver=8a835" defer data-deferred="1"></script>
<script id="avada-comments-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhQ29tbWVudFZhcnM9eyJ0aXRsZV9zdHlsZV90eXBlIjoic2luZ2xlIHNvbGlkIiwidGl0bGVfbWFyZ2luX3RvcCI6IjBweCIsInRpdGxlX21hcmdpbl9ib3R0b20iOiIzMHB4In0=" defer></script>
<script data-optimized="1" id="avada-comments-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/5f02be46bcc7d1ed62df84ed2e32fd5e.js?ver=73a10" defer data-deferred="1"></script>
<script data-optimized="1" id="fusion-alert-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/0bc6b9b681cfe56c98ac249b901f4430.js?ver=1206e" defer data-deferred="1"></script>
<script data-optimized="1" id="awb-background-slider-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/99a6608632ee6a03b2b2dde62f6c3dcf.js?ver=796b0" defer data-deferred="1"></script>
<script id="fusion-flexslider-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkZsZXhTbGlkZXJWYXJzPXsic3RhdHVzX3ZpbWVvIjoiMSIsInNsaWRlc2hvd19hdXRvcGxheSI6IjEiLCJzbGlkZXNob3dfc3BlZWQiOiI3MDAwIiwicGFnaW5hdGlvbl92aWRlb19zbGlkZSI6IiIsInN0YXR1c195dCI6IjEiLCJmbGV4X3Ntb290aEhlaWdodCI6ImZhbHNlIn0=" defer></script>
<script data-optimized="1" id="fusion-flexslider-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/3cb69f26d07794a81f20521aa1ebdb1e.js?ver=c5393" defer data-deferred="1"></script>
<script id="awb-carousel-js-extra" src="data:text/javascript;base64,dmFyIGF3YkNhcm91c2VsVmFycz17InJlbGF0ZWRfcG9zdHNfc3BlZWQiOiIyNTAwIiwiY2Fyb3VzZWxfc3BlZWQiOiIyMDAwIn0=" defer></script>
<script data-optimized="1" id="awb-carousel-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/676965e40d5fda12007e19f918aa9a4d.js?ver=f35dc" defer data-deferred="1"></script>
<script id="fusion-animations-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkFuaW1hdGlvbnNWYXJzPXsic3RhdHVzX2Nzc19hbmltYXRpb25zIjoiZGVza3RvcCJ9" defer></script>
<script data-optimized="1" id="fusion-animations-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/d11f745c9892989292540840a0d325d0.js?ver=65f91" defer data-deferred="1"></script>
<script id="fusion-container-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvbkNvbnRhaW5lclZhcnM9eyJjb250ZW50X2JyZWFrX3BvaW50IjoiODAwIiwiY29udGFpbmVyX2h1bmRyZWRfcGVyY2VudF9oZWlnaHRfbW9iaWxlIjoiMCIsImlzX3N0aWNreV9oZWFkZXJfdHJhbnNwYXJlbnQiOiIxIn0=" defer></script>
<script data-optimized="1" id="fusion-container-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/aabc9cbdb5c5b18874406f0c1b1d0e57.js?ver=03ca1" defer data-deferred="1"></script>
<script id="awb-widget-areas-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhU2lkZWJhcnNWYXJzPXsiaGVhZGVyX3Bvc2l0aW9uIjoidG9wIiwiaGVhZGVyX2xheW91dCI6InYyIiwiaGVhZGVyX3N0aWNreSI6IjEiLCJoZWFkZXJfc3RpY2t5X3R5cGUyX2xheW91dCI6Im1lbnVfb25seSIsInNpZGVfaGVhZGVyX2JyZWFrX3BvaW50IjoiMTA1MCIsImhlYWRlcl9zdGlja3lfdGFibGV0IjoiIiwic3RpY2t5X2hlYWRlcl9zaHJpbmthZ2UiOiIiLCJuYXZfaGVpZ2h0IjoiMTAzIiwic2lkZWJhcl9icmVha19wb2ludCI6IjgwMCJ9" defer></script>
<script data-optimized="1" id="awb-widget-areas-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/0411623fde2fddcf5c2c8f1937a4a36f.js?ver=35745" defer data-deferred="1"></script>
<script id="avada-fade-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhRmFkZVZhcnM9eyJwYWdlX3RpdGxlX2ZhZGluZyI6IjEiLCJoZWFkZXJfcG9zaXRpb24iOiJ0b3AifQ==" defer></script>
<script data-optimized="1" id="avada-fade-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/42e2c1fb2c6fc6ae36d97cfa800797e6.js?ver=5e953" defer data-deferred="1"></script>
<script id="avada-drop-down-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhU2VsZWN0VmFycz17ImF2YWRhX2Ryb3BfZG93biI6IjEifQ==" defer></script>
<script data-optimized="1" id="avada-drop-down-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/bbf28ff16d3c5aa1d1cb7a284de6a4d2.js?ver=7506f" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-sliding-bar-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/b5eba35aee2f252fb058874120fce0d7.js?ver=ade9d" defer data-deferred="1"></script>
<script id="avada-to-top-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhVG9Ub3BWYXJzPXsic3RhdHVzX3RvdG9wIjoiZGVza3RvcF9hbmRfbW9iaWxlIiwidG90b3BfcG9zaXRpb24iOiJyaWdodCIsInRvdG9wX3Njcm9sbF9kb3duX29ubHkiOiIxIn0=" defer></script>
<script data-optimized="1" id="avada-to-top-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/90be7be21880207d646a43c87dbe3d94.js?ver=2a31d" defer data-deferred="1"></script>
<script id="avada-header-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhSGVhZGVyVmFycz17ImhlYWRlcl9wb3NpdGlvbiI6InRvcCIsImhlYWRlcl9zdGlja3kiOiIxIiwiaGVhZGVyX3N0aWNreV90eXBlMl9sYXlvdXQiOiJtZW51X29ubHkiLCJoZWFkZXJfc3RpY2t5X3NoYWRvdyI6IjEiLCJzaWRlX2hlYWRlcl9icmVha19wb2ludCI6IjEwNTAiLCJoZWFkZXJfc3RpY2t5X21vYmlsZSI6IiIsImhlYWRlcl9zdGlja3lfdGFibGV0IjoiIiwibW9iaWxlX21lbnVfZGVzaWduIjoibW9kZXJuIiwic3RpY2t5X2hlYWRlcl9zaHJpbmthZ2UiOiIiLCJuYXZfaGVpZ2h0IjoiMTAzIiwibmF2X2hpZ2hsaWdodF9ib3JkZXIiOiIzIiwibmF2X2hpZ2hsaWdodF9zdHlsZSI6ImJhciIsImxvZ29fbWFyZ2luX3RvcCI6IjMxcHgiLCJsb2dvX21hcmdpbl9ib3R0b20iOiIzMXB4IiwibGF5b3V0X21vZGUiOiJ3aWRlIiwiaGVhZGVyX3BhZGRpbmdfdG9wIjoiMHB4IiwiaGVhZGVyX3BhZGRpbmdfYm90dG9tIjoiMHB4Iiwic2Nyb2xsX29mZnNldCI6ImZ1bGwifQ==" defer></script>
<script data-optimized="1" id="avada-header-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/c5451df4cc6dffacfdedfe1cf2b473c6.js?ver=4397a" defer data-deferred="1"></script>
<script id="avada-menu-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhTWVudVZhcnM9eyJzaXRlX2xheW91dCI6IndpZGUiLCJoZWFkZXJfcG9zaXRpb24iOiJ0b3AiLCJsb2dvX2FsaWdubWVudCI6ImxlZnQiLCJoZWFkZXJfc3RpY2t5IjoiMSIsImhlYWRlcl9zdGlja3lfbW9iaWxlIjoiIiwiaGVhZGVyX3N0aWNreV90YWJsZXQiOiIiLCJzaWRlX2hlYWRlcl9icmVha19wb2ludCI6IjEwNTAiLCJtZWdhbWVudV9iYXNlX3dpZHRoIjoiY3VzdG9tX3dpZHRoIiwibW9iaWxlX21lbnVfZGVzaWduIjoibW9kZXJuIiwiZHJvcGRvd25fZ290byI6IkdvIHRvLi4uIiwibW9iaWxlX25hdl9jYXJ0IjoiU2hvcHBpbmcgQ2FydCIsIm1vYmlsZV9zdWJtZW51X29wZW4iOiJPcGVuIHN1Ym1lbnUgb2YgJXMiLCJtb2JpbGVfc3VibWVudV9jbG9zZSI6IkNsb3NlIHN1Ym1lbnUgb2YgJXMiLCJzdWJtZW51X3NsaWRlb3V0IjoiMSJ9" defer></script>
<script data-optimized="1" id="avada-menu-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/fdfdd9f54eaace3448c35d60ad80612e.js?ver=0e41f" defer data-deferred="1"></script>
<script data-optimized="1" id="awb-scrollspy-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/09043d9a3a9126fb5372d29f6a1db65a.js?ver=6c4cc" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-scrollspy-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/aa9eca04f870fe01c6554bbf0749aacb.js?ver=151f2" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-woo-products-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/7bd4cd15d3071a8ad2bca6f0d998e487.js?ver=c2eee" defer data-deferred="1"></script>
<script id="avada-woocommerce-js-extra" src="data:text/javascript;base64,dmFyIGF2YWRhV29vQ29tbWVyY2VWYXJzPXsib3JkZXJfYWN0aW9ucyI6IkRcdTAwZTl0YWlscyIsInRpdGxlX3N0eWxlX3R5cGUiOiJzaW5nbGUgc29saWQiLCJ3b29jb21tZXJjZV9zaG9wX3BhZ2VfY29sdW1ucyI6IjQiLCJ3b29jb21tZXJjZV9jaGVja291dF9lcnJvciI6Ik5vdCBhbGwgZmllbGRzIGhhdmUgYmVlbiBmaWxsZWQgaW4gY29ycmVjdGx5LiIsInJlbGF0ZWRfcHJvZHVjdHNfaGVhZGluZ19zaXplIjoiMiIsImFqYXh1cmwiOiJodHRwczovL3d3dy5sb3djb3N0d2ViYWdlbmN5LmNvbS93cC1hZG1pbi9hZG1pbi1hamF4LnBocCIsImNhcnRfbm9uY2UiOiJlNzFiNDcyNDFiIiwicXVpY2tfdmlld19ub25jZSI6ImUwMzkyN2U3YzkiLCJxdWlja192aWV3X2Nsb3NlIjoiQ2xvc2UgcHJvZHVjdCBxdWljayB2aWV3IiwicXVpY2tfdmlld190aXRsZSI6IlRpdGxlIiwic2hvcF9wYWdlX2JnX2NvbG9yIjoiI2ZmZmZmZiIsInNob3BfcGFnZV9iZ19jb2xvcl9saWdodG5lc3MiOiIxMDAiLCJwb3N0X3RpdGxlX2ZvbnRfc2l6ZSI6IjI2IiwiYWpheF91cGRhdGVfY2FydF92YWx1ZXMiOiIxIiwid29vX2FqYXhfZmlsdGVycyI6Im5vIiwid29vX2FqYXhfc29ydGluZyI6IjAiLCJ3b29fYWpheF9jYXRlZ29yaWVzIjoib2ZmIn0=" defer></script>
<script data-optimized="1" id="avada-woocommerce-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/7c22006f21326b46baf8c96d4fe176c2.js?ver=48ba2" defer data-deferred="1"></script>
<script data-optimized="1" id="avada-woo-product-images-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/e5ff1bf4d86a6642def4423c37f399b7.js?ver=25363" defer data-deferred="1"></script>
<script id="fusion-responsive-typography-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvblR5cG9ncmFwaHlWYXJzPXsic2l0ZV93aWR0aCI6IjEzMDBweCIsInR5cG9ncmFwaHlfc2Vuc2l0aXZpdHkiOiIwLjU0IiwidHlwb2dyYXBoeV9mYWN0b3IiOiIxLjUwIiwiZWxlbWVudHMiOiJoMSwgaDIsIGgzLCBoNCwgaDUsIGg2In0=" defer></script>
<script data-optimized="1" id="fusion-responsive-typography-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/bc6178fd5c47ab54e0056a094ee994dc.js?ver=af0b6" defer data-deferred="1"></script>
<script id="fusion-scroll-to-anchor-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvblNjcm9sbFRvQW5jaG9yVmFycz17ImNvbnRlbnRfYnJlYWtfcG9pbnQiOiI4MDAiLCJjb250YWluZXJfaHVuZHJlZF9wZXJjZW50X2hlaWdodF9tb2JpbGUiOiIwIn0=" defer></script>
<script data-optimized="1" id="fusion-scroll-to-anchor-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/a48e74a65e9c7f6d4a28126b91cd4f8f.js?ver=cc70b" defer data-deferred="1"></script>
<script id="fusion-video-js-extra" src="data:text/javascript;base64,dmFyIGZ1c2lvblZpZGVvVmFycz17InN0YXR1c192aW1lbyI6IjEifQ==" defer></script>
<script data-optimized="1" id="fusion-video-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/b9908f7f9e91fd01104dc4e6e7af8efe.js?ver=69ca8" defer data-deferred="1"></script>
<script data-optimized="1" id="fusion-column-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/e1165df2c89a619f5f6aa3bd667bde43.js?ver=435be" defer data-deferred="1"></script>
<script id="wc-cart-fragments-js-extra" src="data:text/javascript;base64,dmFyIHdjX2NhcnRfZnJhZ21lbnRzX3BhcmFtcz17ImFqYXhfdXJsIjoiL3dwLWFkbWluL2FkbWluLWFqYXgucGhwP2xhbmc9ZnIiLCJ3Y19hamF4X3VybCI6Ii9mci8/d2MtYWpheD0lJWVuZHBvaW50JSUiLCJjYXJ0X2hhc2hfa2V5Ijoid2NfY2FydF9oYXNoX2ZhNmI2ZTJjZGFkNGZiYWI1ZTJjYTcxZTljOGIxOWVhLWZyLVVTRCIsImZyYWdtZW50X25hbWUiOiJ3Y19mcmFnbWVudHNfZmE2YjZlMmNkYWQ0ZmJhYjVlMmNhNzFlOWM4YjE5ZWEtZnItVVNEIiwicmVxdWVzdF90aW1lb3V0IjoiNTAwMCJ9" defer></script>
<script data-optimized="1" data-wp-strategy="defer" defer id="wc-cart-fragments-js" src="https://www.lowcostwebagency.com/wp-content/litespeed/js/7d81cfa231efbb9d8db5d9cc39ea7ef8.js?ver=592fb"></script>
<script type="text/javascript" src="data:text/javascript;base64,aWYodHlwZW9mIHdvb2NvbW1lcmNlX3ByaWNlX3NsaWRlcl9wYXJhbXMhPT0ndW5kZWZpbmVkJyl7d29vY29tbWVyY2VfcHJpY2Vfc2xpZGVyX3BhcmFtcy5jdXJyZW5jeV9mb3JtYXRfc3ltYm9sPXdjbWxfbWNfc2V0dGluZ3MuY3VycmVudF9jdXJyZW5jeS5zeW1ib2x9" defer></script>
</div>
<section class="to-top-container to-top-right awb-to-top-text-before" aria-labelledby="awb-to-top-label">
<a href="#" id="toTop" class="fusion-top-top-link">
<span id="awb-to-top-label" class="screen-reader-text">Go to Top</span>
</a>
</section>
<script data-no-optimize="1">window.lazyLoadOptions=Object.assign({},{threshold:300},window.lazyLoadOptions||{});!function(t,e){"object"==typeof exports&&"undefined"!=typeof module?module.exports=e():"function"==typeof define&&define.amd?define(e):(t="undefined"!=typeof globalThis?globalThis:t||self).LazyLoad=e()}(this,function(){"use strict";function e(){return(e=Object.assign||function(t){for(var e=1;e<arguments.length;e++){var n,a=arguments[e];for(n in a)Object.prototype.hasOwnProperty.call(a,n)&&(t[n]=a[n])}return t}).apply(this,arguments)}function o(t){return e({},at,t)}function l(t,e){return t.getAttribute(gt+e)}function c(t){return l(t,vt)}function s(t,e){return function(t,e,n){e=gt+e;null!==n?t.setAttribute(e,n):t.removeAttribute(e)}(t,vt,e)}function i(t){return s(t,null),0}function r(t){return null===c(t)}function u(t){return c(t)===_t}function d(t,e,n,a){t&&(void 0===a?void 0===n?t(e):t(e,n):t(e,n,a))}function f(t,e){et?t.classList.add(e):t.className+=(t.className?" ":"")+e}function _(t,e){et?t.classList.remove(e):t.className=t.className.replace(new RegExp("(^|\\s+)"+e+"(\\s+|$)")," ").replace(/^\s+/,"").replace(/\s+$/,"")}function g(t){return t.llTempImage}function v(t,e){!e||(e=e._observer)&&e.unobserve(t)}function b(t,e){t&&(t.loadingCount+=e)}function p(t,e){t&&(t.toLoadCount=e)}function n(t){for(var e,n=[],a=0;e=t.children[a];a+=1)"SOURCE"===e.tagName&&n.push(e);return n}function h(t,e){(t=t.parentNode)&&"PICTURE"===t.tagName&&n(t).forEach(e)}function a(t,e){n(t).forEach(e)}function m(t){return!!t[lt]}function E(t){return t[lt]}function I(t){return delete t[lt]}function y(e,t){var n;m(e)||(n={},t.forEach(function(t){n[t]=e.getAttribute(t)}),e[lt]=n)}function L(a,t){var o;m(a)&&(o=E(a),t.forEach(function(t){var e,n;e=a,(t=o[n=t])?e.setAttribute(n,t):e.removeAttribute(n)}))}function k(t,e,n){f(t,e.class_loading),s(t,st),n&&(b(n,1),d(e.callback_loading,t,n))}function A(t,e,n){n&&t.setAttribute(e,n)}function O(t,e){A(t,rt,l(t,e.data_sizes)),A(t,it,l(t,e.data_srcset)),A(t,ot,l(t,e.data_src))}function w(t,e,n){var a=l(t,e.data_bg_multi),o=l(t,e.data_bg_multi_hidpi);(a=nt&&o?o:a)&&(t.style.backgroundImage=a,n=n,f(t=t,(e=e).class_applied),s(t,dt),n&&(e.unobserve_completed&&v(t,e),d(e.callback_applied,t,n)))}function x(t,e){!e||0<e.loadingCount||0<e.toLoadCount||d(t.callback_finish,e)}function M(t,e,n){t.addEventListener(e,n),t.llEvLisnrs[e]=n}function N(t){return!!t.llEvLisnrs}function z(t){if(N(t)){var e,n,a=t.llEvLisnrs;for(e in a){var o=a[e];n=e,o=o,t.removeEventListener(n,o)}delete t.llEvLisnrs}}function C(t,e,n){var a;delete t.llTempImage,b(n,-1),(a=n)&&--a.toLoadCount,_(t,e.class_loading),e.unobserve_completed&&v(t,n)}function R(i,r,c){var l=g(i)||i;N(l)||function(t,e,n){N(t)||(t.llEvLisnrs={});var a="VIDEO"===t.tagName?"loadeddata":"load";M(t,a,e),M(t,"error",n)}(l,function(t){var e,n,a,o;n=r,a=c,o=u(e=i),C(e,n,a),f(e,n.class_loaded),s(e,ut),d(n.callback_loaded,e,a),o||x(n,a),z(l)},function(t){var e,n,a,o;n=r,a=c,o=u(e=i),C(e,n,a),f(e,n.class_error),s(e,ft),d(n.callback_error,e,a),o||x(n,a),z(l)})}function T(t,e,n){var a,o,i,r,c;t.llTempImage=document.createElement("IMG"),R(t,e,n),m(c=t)||(c[lt]={backgroundImage:c.style.backgroundImage}),i=n,r=l(a=t,(o=e).data_bg),c=l(a,o.data_bg_hidpi),(r=nt&&c?c:r)&&(a.style.backgroundImage='url("'.concat(r,'")'),g(a).setAttribute(ot,r),k(a,o,i)),w(t,e,n)}function G(t,e,n){var a;R(t,e,n),a=e,e=n,(t=Et[(n=t).tagName])&&(t(n,a),k(n,a,e))}function D(t,e,n){var a;a=t,(-1<It.indexOf(a.tagName)?G:T)(t,e,n)}function S(t,e,n){var a;t.setAttribute("loading","lazy"),R(t,e,n),a=e,(e=Et[(n=t).tagName])&&e(n,a),s(t,_t)}function V(t){t.removeAttribute(ot),t.removeAttribute(it),t.removeAttribute(rt)}function j(t){h(t,function(t){L(t,mt)}),L(t,mt)}function F(t){var e;(e=yt[t.tagName])?e(t):m(e=t)&&(t=E(e),e.style.backgroundImage=t.backgroundImage)}function P(t,e){var n;F(t),n=e,r(e=t)||u(e)||(_(e,n.class_entered),_(e,n.class_exited),_(e,n.class_applied),_(e,n.class_loading),_(e,n.class_loaded),_(e,n.class_error)),i(t),I(t)}function U(t,e,n,a){var o;n.cancel_on_exit&&(c(t)!==st||"IMG"===t.tagName&&(z(t),h(o=t,function(t){V(t)}),V(o),j(t),_(t,n.class_loading),b(a,-1),i(t),d(n.callback_cancel,t,e,a)))}function $(t,e,n,a){var o,i,r=(i=t,0<=bt.indexOf(c(i)));s(t,"entered"),f(t,n.class_entered),_(t,n.class_exited),o=t,i=a,n.unobserve_entered&&v(o,i),d(n.callback_enter,t,e,a),r||D(t,n,a)}function q(t){return t.use_native&&"loading"in HTMLImageElement.prototype}function H(t,o,i){t.forEach(function(t){return(a=t).isIntersecting||0<a.intersectionRatio?$(t.target,t,o,i):(e=t.target,n=t,a=o,t=i,void(r(e)||(f(e,a.class_exited),U(e,n,a,t),d(a.callback_exit,e,n,t))));var e,n,a})}function B(e,n){var t;tt&&!q(e)&&(n._observer=new IntersectionObserver(function(t){H(t,e,n)},{root:(t=e).container===document?null:t.container,rootMargin:t.thresholds||t.threshold+"px"}))}function J(t){return Array.prototype.slice.call(t)}function K(t){return t.container.querySelectorAll(t.elements_selector)}function Q(t){return c(t)===ft}function W(t,e){return e=t||K(e),J(e).filter(r)}function X(e,t){var n;(n=K(e),J(n).filter(Q)).forEach(function(t){_(t,e.class_error),i(t)}),t.update()}function t(t,e){var n,a,t=o(t);this._settings=t,this.loadingCount=0,B(t,this),n=t,a=this,Y&&window.addEventListener("online",function(){X(n,a)}),this.update(e)}var Y="undefined"!=typeof window,Z=Y&&!("onscroll"in window)||"undefined"!=typeof navigator&&/(gle|ing|ro)bot|crawl|spider/i.test(navigator.userAgent),tt=Y&&"IntersectionObserver"in window,et=Y&&"classList"in document.createElement("p"),nt=Y&&1<window.devicePixelRatio,at={elements_selector:".lazy",container:Z||Y?document:null,threshold:300,thresholds:null,data_src:"src",data_srcset:"srcset",data_sizes:"sizes",data_bg:"bg",data_bg_hidpi:"bg-hidpi",data_bg_multi:"bg-multi",data_bg_multi_hidpi:"bg-multi-hidpi",data_poster:"poster",class_applied:"applied",class_loading:"litespeed-loading",class_loaded:"litespeed-loaded",class_error:"error",class_entered:"entered",class_exited:"exited",unobserve_completed:!0,unobserve_entered:!1,cancel_on_exit:!0,callback_enter:null,callback_exit:null,callback_applied:null,callback_loading:null,callback_loaded:null,callback_error:null,callback_finish:null,callback_cancel:null,use_native:!1},ot="src",it="srcset",rt="sizes",ct="poster",lt="llOriginalAttrs",st="loading",ut="loaded",dt="applied",ft="error",_t="native",gt="data-",vt="ll-status",bt=[st,ut,dt,ft],pt=[ot],ht=[ot,ct],mt=[ot,it,rt],Et={IMG:function(t,e){h(t,function(t){y(t,mt),O(t,e)}),y(t,mt),O(t,e)},IFRAME:function(t,e){y(t,pt),A(t,ot,l(t,e.data_src))},VIDEO:function(t,e){a(t,function(t){y(t,pt),A(t,ot,l(t,e.data_src))}),y(t,ht),A(t,ct,l(t,e.data_poster)),A(t,ot,l(t,e.data_src)),t.load()}},It=["IMG","IFRAME","VIDEO"],yt={IMG:j,IFRAME:function(t){L(t,pt)},VIDEO:function(t){a(t,function(t){L(t,pt)}),L(t,ht),t.load()}},Lt=["IMG","IFRAME","VIDEO"];return t.prototype={update:function(t){var e,n,a,o=this._settings,i=W(t,o);{if(p(this,i.length),!Z&&tt)return q(o)?(e=o,n=this,i.forEach(function(t){-1!==Lt.indexOf(t.tagName)&&S(t,e,n)}),void p(n,0)):(t=this._observer,o=i,t.disconnect(),a=t,void o.forEach(function(t){a.observe(t)}));this.loadAll(i)}},destroy:function(){this._observer&&this._observer.disconnect(),K(this._settings).forEach(function(t){I(t)}),delete this._observer,delete this._settings,delete this.loadingCount,delete this.toLoadCount},loadAll:function(t){var e=this,n=this._settings;W(t,n).forEach(function(t){v(t,e),D(t,n,e)})},restoreAll:function(){var e=this._settings;K(e).forEach(function(t){P(t,e)})}},t.load=function(t,e){e=o(e);D(t,e)},t.resetStatus=function(t){i(t)},t}),function(t,e){"use strict";function n(){e.body.classList.add("litespeed_lazyloaded")}function a(){console.log("[LiteSpeed] Start Lazy Load"),o=new LazyLoad(Object.assign({},t.lazyLoadOptions||{},{elements_selector:"[data-lazyloaded]",callback_finish:n})),i=function(){o.update()},t.MutationObserver&&new MutationObserver(i).observe(e.documentElement,{childList:!0,subtree:!0,attributes:!0})}var o,i;t.addEventListener?t.addEventListener("load",a,!1):t.attachEvent("onload",a)}(window,document);</script><script>window.litespeed_ui_events=window.litespeed_ui_events||["mouseover","click","keydown","wheel","touchmove","touchstart","pointerup","pointerdown"];var urlCreator=window.URL||window.webkitURL;function litespeed_load_delayed_js_force(){console.log("[LiteSpeed] Start Load JS Delayed"),litespeed_ui_events.forEach(e=>{window.removeEventListener(e,litespeed_load_delayed_js_force,{passive:!0})}),document.querySelectorAll("iframe[data-litespeed-src]").forEach(e=>{e.setAttribute("src",e.getAttribute("data-litespeed-src"))}),"loading"==document.readyState?window.addEventListener("DOMContentLoaded",litespeed_load_delayed_js):litespeed_load_delayed_js()}litespeed_ui_events.forEach(e=>{window.addEventListener(e,litespeed_load_delayed_js_force,{passive:!0})});async function litespeed_load_delayed_js(){let t=[];for(var d in document.querySelectorAll('script[type="litespeed/javascript"]').forEach(e=>{t.push(e)}),t)await new Promise(e=>litespeed_load_one(t[d],e));document.dispatchEvent(new Event("DOMContentLiteSpeedLoaded")),window.dispatchEvent(new Event("DOMContentLiteSpeedLoaded"))}function litespeed_load_one(t,e){console.log("[LiteSpeed] Load ",t);function d(){o.src.startsWith("blob:")&&URL.revokeObjectURL(o.src),e()}var o=document.createElement("script");o.addEventListener("load",d),o.addEventListener("error",d),t.getAttributeNames().forEach(e=>{"type"!=e&&o.setAttribute("data-src"==e?"src":e,t.getAttribute(e))}),o.type="text/javascript",!o.src&&t.textContent&&(o.src=litespeed_inline2src(t.textContent)),t.after(o),t.remove()}function litespeed_inline2src(t){try{var d=urlCreator.createObjectURL(new Blob([t.replace(/^(?:<!--)?(.*?)(?:-->)?$/gm,"$1")],{type:"text/javascript"}))}catch(e){d="data:text/javascript;base64,"+btoa(t.replace(/^(?:<!--)?(.*?)(?:-->)?$/gm,"$1"))}return d}</script></body>
</html>
<!-- Page cached by LiteSpeed Cache 7.9.1 on 2026-10-12 18:40:58 -->