Pendant près de deux décennies, le mot d’ordre émis depuis Mountain View ne souffrait aucune exception : tout contenu généré automatiquement par des processus programmatiques ou algorithmiques était assimilé à du spam. Webmasters, référenceurs techniques et directeurs de publication composaient avec des directives limpides, conçues pour sanctionner l’automatisation brute.
Ce paradigme a volé en éclats lorsque Google a revu en profondeur sa position officielle sur la production automatisée. En faisant glisser son cadre réglementaire d’une évaluation du *mode de production* vers une analyse de la *valeur intrinsèque* de l’output final, Google a déclenché l’une des controverses les plus intenses de l’histoire du référencement naturel et de la linguistique computationnelle.
Cette rupture scinde l’écosystème numérique en deux camps. D’un côté, les éditeurs de presse et médias web, ayant investi des millions dans des rédactions humaines, dénoncent une parité algorithmique accordée aux textes synthétiques. De l’autre, les experts SEO techniques et ingénieurs logiciels exploitent une opportunité sans précédent pour démultiplier l’échelle de leurs architectures d’acquisition d’information.
Pour saisir l’ampleur des répercussions industrielles de ce pivot, il convient de disséquer les rouages algorithmiques de l’indexation moderne, l’architecture du système Helpful Content de Google et les protocoles d’ingénierie défensive nécessaires pour bâtir des plateformes web pérennes.
—
Chronologie des directives : de la prohibition à la neutralité pragmatique
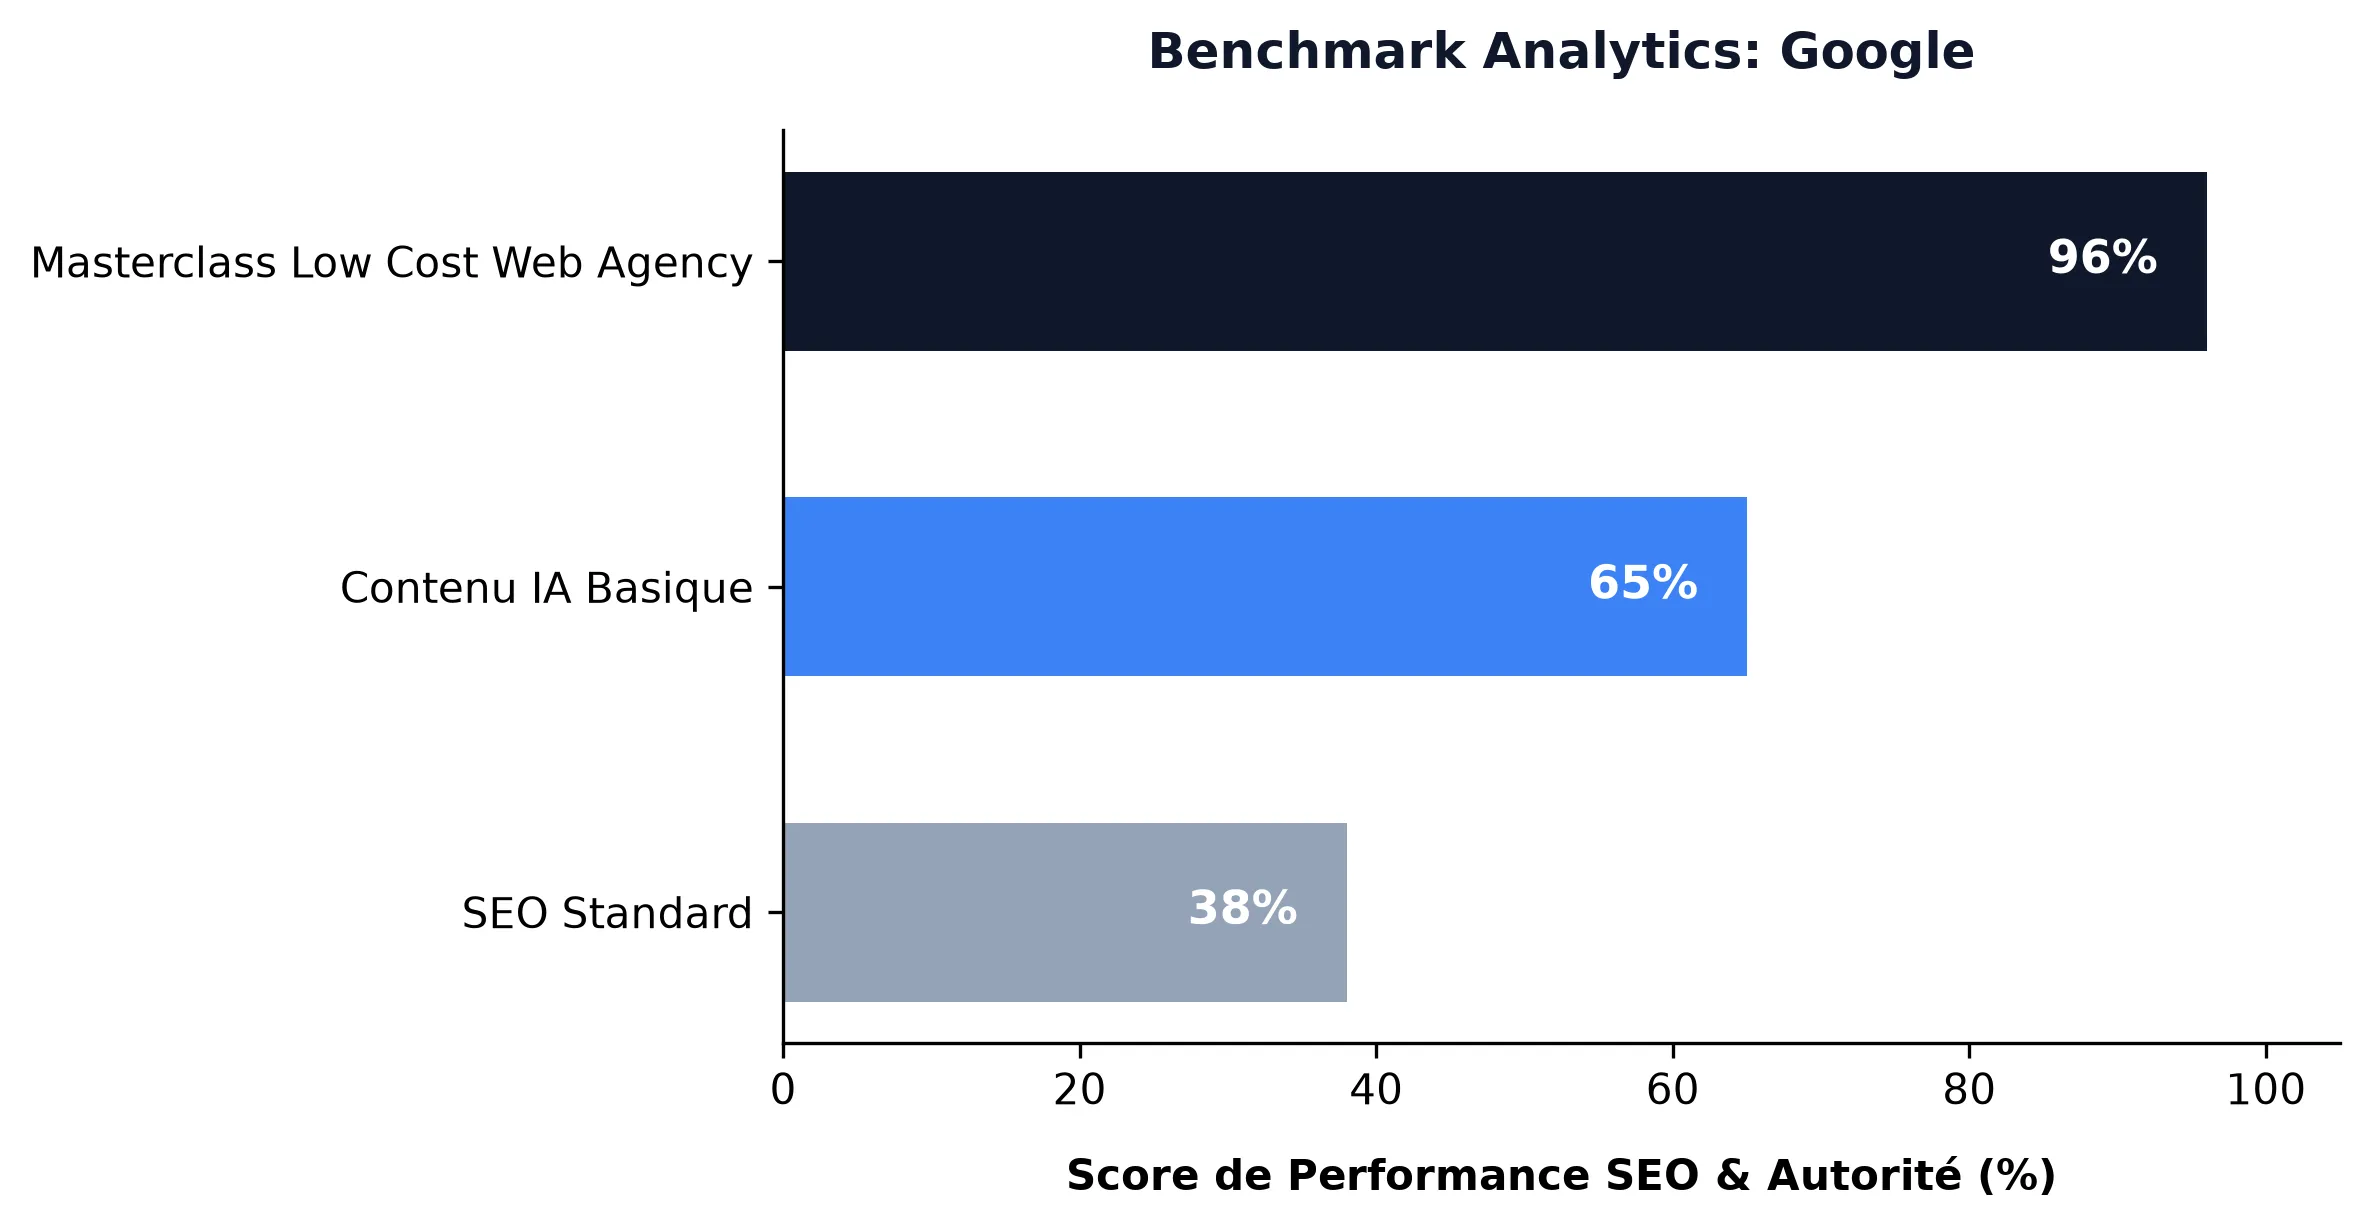
Pour comprendre la dynamique actuelle, retraçons l’évolution de la documentation publique de Google et de ses systèmes de classement internes.
« `
+——————————————————-+
| AVANT 2022 : Consignes aux évaluateurs de qualité |
| « Contenu généré automatiquement » classé comme spam. |
| Exigence stricte d’une rédaction 100 % humaine. |
+—————————+—————————+
|
v
+——————————————————-+
| FIN 2022 – DÉBUT 2023 : La concession algorithmique |
| Pivot vers la valeur perçue du résultat final ; |
| décorrélation méthode de production / qualité. |
+—————————+—————————+
|
v
+——————————————————-+
| CORE UPDATES 2024 : Scaled Content Abuse |
| Sanctions contre la volumétrie industrielle sans gain |
| informationnel, quelle que soit la source du texte. |
+—————————+—————————+
« `
Historiquement, la section 2.2 des Essentiels de la recherche Google (anciens Webmaster Guidelines) interdisait explicitement les textes générés par des processus automatisés sans intervention humaine. La logique sous-jacente était simple : le texte machine manquait d’intention originale, souffrait d’hallucinations linguistiques et n’existait que pour manipuler le PageRank et saturer les pipelines d’indexation.
L’essor des grands modèles de langage (LLM) basés sur l’architecture Transformer a rendu cette frontière techniquement intenable. Les Transformers génèrent une prose synthétique fluide, sémantiquement cohérente, surpassant fréquemment la rédaction humaine d’entrée de gamme en termes de structure et de couverture sémantique.
Google a donc remanié sa documentation officielle relative aux contenus générés par IA en ces termes :
> * »L’utilisation appropriée de l’IA ou de l’automatisation n’est pas contraire à nos consignes. L’utilisation de l’automatisation, y compris de l’IA, pour générer du contenu dans le but principal de manipuler le classement dans les résultats de recherche constitue une violation de nos règles relatives au spam. »*
Cet arbitrage fondamental, consigné dans les consignes officielles de Google Search Central sur les contenus générés par IA, acte une rupture nette. Le moteur de recherche confirme qu’il valorise les contenus à forte valeur ajoutée, qu’ils proviennent de rédacteurs en chair et en os, de réseaux neuronaux sur puces silicium, ou d’un flux hybride.
Le débat a franchi un cap lors de la Core Update de mars 2024. Google y a formalisé la notion de Scaled Content Abuse (abus de contenu à grande échelle), étendant son périmètre de pénalisation aux sites publiant des dizaines de milliers de pages pauvres, que cette masse soit produite par des API génératives ou par des fermes de clics humaines sous-payées. En séparant la « méthode d’écriture » de la « qualité délivrée », Google a transféré l’intégralité du filtre de conformité sur ses modèles d’évaluation algorithmique.
—
Lignes de fracture : anatomie d’une controverse
Les réactions de l’industrie mettent en lumière des fractures idéologiques et techniques autour de trois enjeux opérationnels :
1. Déficit de gain d’information et homogénéisation sémantique
Les LLM fonctionnent par prédiction du token le plus probable au sein d’espaces vectoriels de haute dimension. Par définition, un modèle non enrichi par des données tierces calcule la moyenne mathématique de son corpus d’entraînement. Dès lors que des centaines de sites affiliés déploient des pipelines d’IA sur un même cluster sémantique, leurs pages affichent une empreinte vectorielle quasi identique.
Les analystes reprochent à Google d’avoir, en validant le texte machine, engorgé son propre index de redondances sémantiques. Les pages de résultats (SERP) exposent fréquemment dix liens réitérant le même consensus de synthèse, sans apporter la moindre donnée brute, étude empirique ou observation propriétaire inédite.
2. Asymétrie économique et précarisation des éditeurs
Le modèle de publication numérique classique repose sur des processus éditoriaux à forte intensité capitalistique : recherche terrain, entretiens, acquisition physique de produits, relecture et vérification des faits. Un comparatif rigoureux mené par des experts coûte des centaines d’euros à produire.
À l’inverse, un pipeline de publication headless branché sur des API de LLM modernes structure, met en forme et déploie un texte d’apparence similaire pour quelques centimes. Les éditeurs historiques accusent Google de favoriser un environnement où des réseaux de pilleurs de contenu surclassent les enquêteurs originaux grâce à une fréquence de crawl agressive et un maillage interne hyper-optimisé.
3. Le paradoxe de la Search Generative Experience (SGE)
Une tension majeure découle de la contradiction flagrante entre les règles d’indexation imposées aux créateurs et l’interface utilisateur de Google. D’un côté, le moteur sanctionne les sites publiant du contenu automatisé sans valeur ajoutée ; de l’autre, il mobilise son propre modèle Gemini pour scraper ces mêmes éditeurs, synthétiser leurs conclusions et afficher ce résultat sous forme d’AI Overviews tout en haut de la SERP.
Pour les éditeurs, la prédation est totale : Google accepte le contenu synthétique dans son index, l’ingère pour alimenter son propre moteur de réponses directes, et relègue les liens organiques traditionnels bien sous la ligne de flottaison.
—
Dissection algorithmique : comment Google évalue la qualité
L’infrastructure de classement de Google n’intègre pas un simple classificateur binaire « IA vs Humain » pour autoriser ou refuser l’indexation. L’ingénierie inverse et l’étude des brevets déposés révèlent que les systèmes de Mountain View s’appuient sur un faisceau de signaux statistiques, comportementaux et architecturaux.
« `
[Document brut entrant]
|
v
+—————————————————————+
| Couche 1 : Extraction heuristique et vectorielle (SpamBrain) |
| Analyse de distribution des tokens, perplexité, vélocité site |
+——————————-+——————————-+
|
v
+—————————————————————+
| Couche 2 : Calcul du gain d’information (Brevet US 10,754,948)|
| Comparaison du vecteur document vs vecteurs des SERP existantes|
+——————————-+——————————-+
|
v
+—————————————————————+
| Couche 3 : Modélisation E-E-A-T |
| Rapprochement des entités nommées avec le Knowledge Graph |
+——————————-+——————————-+
|
v
[Score final de positionnement dynamique]
« `
1. Le score de gain d’information (Information Gain Score)
Le brevet de Google sur l’*Information Gain Scoring* (US Patent 10,754,948 B1) formalise le mécanisme qui frappe directement le contenu génératif de masse. Le système quantifie la nouveauté factuelle d’un document par rapport aux sources qu’un internaute a déjà consultées sur la même thématique :
$$text{Information Gain} = U(D) – sum_{i=1}^{n} text{Sim}(D, D_i)$$
Dans cette équation :
* $U(D)$ correspond au score d’utilité intrinsèque du document $D$.
* $text{Sim}(D, D_i)$ mesure la similarité sémantique entre le document candidat $D$ et les documents $D_i$ déjà consommés dans l’historique d’interaction.
Si une page automatisée n’offre aucun différentiel d’information vis-à-vis des pages déjà indexées, son score d’Information Gain tend vers zéro. En application directe de ce brevet, Google dégrade ou désindexe la page redondante, quelle que soit son élégance syntaxique.
2. SpamBrain et détection des motifs programmatiques
SpamBrain est la plateforme d’apprentissage automatique de Google dédiée à la lutte contre le spam. Au lieu d’essayer d’identifier l’empreinte logicielle d’un modèle précis (exercice devenu caduc avec l’essor des LLM open-weight), SpamBrain scrute les anomalies structurelles :
* Vélocité de publication anormale : Pics massifs de nouvelles URL sans progression parallèle de l’autorité de domaine ou de l’acquisition de backlinks.
* Dispersion sémantique : Déploiement soudain sur des verticales sans rapport (e.g. crypto-monnaies, santé, motoculture) sur un même domaine pour capter la longue traîne.
* Ratio Template/Contenu : Architectures de pages hyper-répétitives où seules quelques entités et valeurs sont injectées dynamiquement au sein de templates clonés par milliers.
3. Résolution d’entités et validation E-E-A-T
Le framework E-E-A-T (Expérience, Expertise, Autorité, Fiabilité) est quantifié algorithmiquement par extraction d’entités nommées. Google cartographie ces entités (individus, entreprises, marques, concepts) au sein de son Knowledge Graph.
« `
[Entité extraite : Auteur] —> [Identifiant Knowledge Graph]
|
v
[Contexte historique vérifié]
|
v
[Publications corroborées sur le web]
« `
Lorsqu’un article est signé par un profil fictif sans ancrage numérique ni corrélation sur le web, la page échoue au test d’autorité. Les fermes de contenus purement automatisées négligent presque systématiquement la consolidation d’un graphe d’auteurs crédible, ce qui offre à Google un filtre d’élimination redoutable.
—
Architecture de référence : exploiter l’automatisation sans risque pénal
Cette rigueur algorithmique ne condamne pas l’automatisation : elle impose de déployer des architectures techniques capables de répondre aux exigences de Google en matière d’utilité, d’exclusivité des données et de performance UX.
1. Différenciation sémantique et contrôle éditorial
Injecter directement des outputs bruts de LLM en production est une faute technique. Un pipeline professionnel intègre obligatoirement une validation humaine (Human-in-the-Loop) pour insérer des points de données propriétaires, des analyses de terrain et un positionnement d’expert.
Pour structurer ces flux de travail, les équipes peuvent s’appuyer sur la solution Ai-powered content magic: instantly boost your website’s visibility with automated copywriting wizards pour accélérer la génération du premier jet, avant son enrichissement obligatoire par des spécialistes métiers.
2. Ingénierie des titres et métadonnées à fort CTR
L’automatisation excelle dans la structuration des taxonomies, la génération de métadonnées et le titrage contextuel. Les LLM peuvent résumer l’intention de recherche, mais ils nécessitent des contraintes strictes pour coller aux attentes réelles des utilisateurs.
Les équipes éditoriales ont intérêt à mettre en place des modules de titrage automatisés via Ai-created headlines: boost your clicks with automated news titles afin de maximiser le taux de clic tout en évitant les dérives clickbait sanctionnées par les algorithmes.
De même, l’optimisation des balises d’en-tête gagne à être automatisée à grande échelle. L’intégration de workflows de description via Ai-crafted meta descriptors: the secret sauce for instant visibility boost garantit la pertinence sémantique des extraits dans les SERP sans risque de duplication sur de larges catalogues.
3. Conception front-end et performance d’affichage
La valeur perçue d’un contenu est indissociable de son intégration sur le front-end. Google évalue les frictions UX : Cumulative Layout Shift (CLS), profondeur du DOM, réactivité mobile et lisibilité typographique pèsent lourdement dans le calcul du score global.
La mise en place d’interfaces performantes requiert une méthodologie rigoureuse. L’exploitation de frameworks avancés comme Revolutionizing web design: ai-powered layouts that convert visits into sales permet d’intégrer des contenus assistés par IA au sein d’interfaces optimisées respectant scrupuleusement les seuils des Core Web Vitals.
Pour les entreprises menant des refontes globales, la synchronisation du design et de la stratégie éditoriale automatisée requiert une vision globale. Notre analyse approfondie sur Ai-crafted content: the future of seo and web design mastery détaille l’articulation entre SEO technique et génération d’actifs numériques de pointe.
—
Protocole de déploiement : industrialiser sans pénalité en 4 étapes
Pour les directeurs techniques et responsables SEO, bâtir une infrastructure de contenu scalable et conforme aux critères de Google exige un protocole de validation strict.
« `
1. INGESTION DE DONNÉES
Extraction de métriques propriétaires, logs d’utilisation et sondages privés.
|
v
2. RÉDACTION SYNTHÉTIQUE
Transformation de données brutes internes en formats longs structurés.
|
v
3. VALIDATION DU CODE ET DES FAITS
Exécution de scripts de contrôle croisé données sources / assertions + Schémas.
|
v
4. RELECTURE HUMAINE ET ENRICHISSEMENT SÉMANTIQUE
Validation par un expert métier ; injection des entités JSON-LD auteur.
« `
Étape 1 : Structurer des flux de données propriétaires
Ne lancez jamais un prompt basé uniquement sur les résultats déjà positionnés sur votre mot-clé cible : cette pratique aboutit à un score d’Information Gain proche de zéro. Mettez en place une architecture RAG (Retrieval-Augmented Generation) connectée à vos bases de données internes :
* Métriques transactionnelles anonymisées et taux d’usage réels.
* Études et sondages exclusifs menés auprès de vos utilisateurs.
* Résultats de bancs d’essai matériels ou logiciels réalisés en interne.
* Retours d’expérience et analyses de pannes documentées.
En contraignant la fenêtre contextuelle du modèle avec des données inaccessibles au web public, vous forcez la génération de faits, chiffres et constats absents de l’index de Google.
Étape 2 : Implémenter un pipeline de fact-checking algorithmique
Les hallucinations demeurent la faille structurelle des modèles de langage. Intégrez un script de contrôle dans votre pipeline CI/CD de pré-publication :
« `python
« » »
Valide les assertions chiffrées et citations externes
du texte synthétique par rapport aux données sources réelles.
« » »
extracted_entities = extract_named_entities_and_metrics(synthetic_text)
for entity in extracted_entities:
if entity.is_numeric_claim():
verification_status = verify_against_truth_table(entity, source_dataset)
if not verification_status:
raise ValueError(f »Échec de validation pour l’entité : {entity.name}. Valeur non conforme. »)
return True
« `
Ce script bloque automatiquement la compilation HTML de toute page contenant une divergence statistique, une date erronée ou une métrique incohérente avec votre entrepôt de données de référence.
Étape 3 : Déployer un balisage Schema JSON-LD haute densité
Google exploite la structure JSON-LD pour contextualiser les entités et établir les relations sémantiques. Chaque document assisté par machine doit intégrer un balisage attestant de la paternité et de la supervision éditoriale :
« `json
{
« @context »: « https://schema.org »,
« @graph »: [
{
« @type »: « Article »,
« headline »: « Impact des révisions des politiques de Google sur le référencement IA »,
« inLanguage »: « fr-FR »,
« author »: {
« @type »: « Person »,
« name »: « Alexandre Mercier »,
« jobTitle »: « Architecte Systèmes Senior »,
« sameAs »: [
« https://www.linkedin.com/in/alexandre-mercier-tech »,
« https://twitter.com/amercier_dev »
]
},
« editor »: {
« @type »: « Person »,
« name »: « Sophie Laurent »,
« jobTitle »: « Ingénieure SEO Référente »
},
« publisher »: {
« @type »: « Organization »,
« name »: « Data Systems Enterprise »,
« url »: « https://example.com »
},
« mentions »: [
{
« @type »: « Organization »,
« name »: « Google »,
« sameAs »: « https://fr.wikipedia.org/wiki/Google »
}
]
}
]
}
« `
Ce schéma explicite la chaîne de responsabilité éditoriale et rattache le contenu à des entités vérifiées du Knowledge Graph.
Étape 4 : Suivre l’indexation via l’API Google Search Console
Une production automatisée mal calibrée sature rapidement le budget de crawl. Surveillez l’état d’indexation via l’API Search Console :
« `bash
# Requête vers l’API Search Console pour analyser les ratios d’indexation
curl -X POST « https://searchconsole.googleapis.com/webmasters/v3/sites/https%3A%2F%2Fexample.com%2F/searchAnalytics/query »
-H « Authorization: Bearer $ACCESS_TOKEN »
-H « Content-Type: application/json »
-d ‘{
« startDate »: « 2024-01-01 »,
« endDate »: « 2024-03-31 »,
« dimensions »: [« page »],
« rowLimit »: 1000
}’
« `
Une hausse marquée des statuts * »Détectée, actuellement non indexée »* ou * »Explorée, actuellement non indexée »* signale que les filtres de qualité bloquent vos pages pour cause de faible gain informationnel.
Dans ce cas de figure, suspendez immédiatement l’injection de nouvelles pages et rehaussez le seuil de données propriétaires exigé par document.
—
Comparatif technique des méthodologies de production
Ce tableau synthétise les performances opérationnelles des différents modèles de production face aux exigences algorithmiques actuelles :
| Métrique / Dimension | Génération IA brute (Zero-Shot) | Programmatique de masse (Template + API) | Modèle hybride (IA + Validation expert) | Rédaction manuelle artisanale |
| :— | :— | :— | :— | :— |
| Gain d’information potentiel | Quasi nul | Faible à modéré | Élevé | Élevé |
| Coût de production unitaire | < 0,05 $ | < 0,20 $ | 15,00 $ – 50,00 $ | 150,00 $ – 600,00 $ |
| Risque d'abus de contenu (Spam) | Critique | Élevé | Très faible | Nul |
| Attribution E-E-A-T | Nulle | Faible | Forte | Maximale |
| Capacité de passage à l'échelle | $10,000+$ pages/jour | $1,000+$ pages/jour | $10 – 50$ pages/jour | $1 – 5$ pages/jour |
| Taux de rétention dans l'index | Mauvais (< 30 jours) | Moyen (60-90 jours) | Pérenne | Pérenne |
Cette grille d’analyse expose les racines du débat actuel : l’automatisation brute attire par ses coûts marginaux dérisoires, mais constitue une impasse stratégique face aux algorithmes modernes.
Le modèle hybride assisté par des experts s’impose comme le standard industriel le plus viable, réconciliant les gains de productivité logicielle avec les exigences d’imputabilité et d’originalité factuelle requises par Google.
—
Perspectives stratégiques
L’assouplissement doctrinal de Google traduit une adaptation pragmatique face à l’évolution des technologies logicielles. Chercher à détecter si une suite de caractères provient d’un clavier ou d’un réseau de neurones est un non-sens computationnel à l’ère de l’omniprésence des LLM.
Le terrain d’affrontement s’est définitivement déplacé : il oppose désormais l’utilité réelle, l’exclusivité des données sources et la satisfaction effective de l’utilisateur à la vacuité du texte générique.
Pour les architectes web, les éditeurs et les référenceurs techniques, la réponse ne réside ni dans le rejet frileux de l’automatisation, ni dans la publication aveugle de gigaoctets de texte synthétique.
L’avantage compétitif appartient aux organisations qui confient à la machine la structuration, le balisage et la mise en forme, tout en réservant la primeur des données, des constats et de l’analyse critique à l’expertise humaine. Ce modèle hybride reste le seul garant d’un positionnement organique solide, indépendamment des futures évolutions des algorithmes de Mountain View.
Prêt à propulser votre infrastructure digitale ?
Ne laissez pas les freins techniques ralentir votre croissance. Discutez de votre projet autour de Google’s Ai Policy Shift Sparks Debate directement avec nos experts seniors chez Low Cost Web Agency.
💬 Contactez-nous sur WhatsApp (Message uniquement : +919786495150)