Automatiser un blog avec une IA, c’est facile à imaginer et plus délicat à réussir. J’ai voulu publier un article par jour en quatre langues, sans y toucher ; deux semaines plus tard, 91 pages étaient abîmées. Voici ce qui a cassé, la réparation menée avec Claude, et ce qui tourne aujourd’hui.
L’essentiel en quelques lignes
- Un script et l’IA Gemini publiaient un article par jour, en quatre langues, sans que personne ne relise. Au bout de deux semaines, 91 pages étaient abîmées.
- Une autre IA, Claude, a trouvé la cause (l’architecture bien plus que le modèle), puis audité et réparé ces 91 pages en direct sur le site, avec sauvegarde et retour arrière automatiques à chaque étape.
- Un nouveau générateur a été construit : une structure imposée, une mise en page faite par un programme, des contrôles qui bloquent, des brouillons plutôt que des publications.
- Reste à ma charge ce qu’une machine ne peut pas décider : la ligne éditoriale, les faits à vérifier, le renouvellement de quelques accès.
Le pari de départ
Je dirige depuis 2013 une agence web installée à Pondichéry, en Inde. Nous créons des sites, des boutiques en ligne et des applications mobiles, nous gérons les réseaux sociaux de nos clients, et nous sommes une cinquantaine à y travailler. Autant dire que le blog de notre propre site devrait être la vitrine la plus soignée de la maison. C’est souvent le contraire : le cordonnier est toujours le plus mal chaussé.
Au début du mois d’octobre, j’ai voulu corriger cela d’un seul coup. L’idée tenait en une phrase : un article par jour, rédigé en anglais, puis adapté en français, en espagnol et en italien, et publié sans que j’aie à y toucher. Je lis ces quatre langues. Je sais ce qu’un site multilingue bien fait peut ouvrir comme portes, et je sais aussi ce que coûte, en heures, de l’alimenter à la main.
La mécanique semblait simple, presque trop belle. Un script écrit en Python. L’intelligence artificielle de Google, Gemini, pour rédiger. Une tâche planifiée sous Windows qui se déclenche chaque matin à 10 h 14. Et mon site WordPress, avec son thème Avada, ses traductions gérées par WPML et son plugin de référencement, pour accueillir le tout.
Elle était trop belle, en effet. Pendant quelques jours, tout a donné l’impression de fonctionner. Les articles arrivaient, les traductions se rangeaient à côté de l’original, le blog se remplissait à une vitesse que jamais une équipe humaine n’aurait tenue. Au bout de deux semaines, vingt-deux sujets étaient en ligne, soit quatre-vingt-onze pages une fois comptées toutes les traductions.
Sur le papier, c’était un succès. Dans les faits, personne n’avait lu ces pages ligne après ligne. Ni moi, pris par tout le reste. Ni le script, qui ne sait que suivre ses instructions. Ni la machine qui les avait écrites, qui n’a aucune raison de douter de ce qu’elle produit.
Ce texte raconte la suite. Comment je me suis aperçu que quelque chose clochait, pourquoi la situation est devenue critique, comment une autre intelligence artificielle, Claude, a audité puis réparé chacune de ces pages directement sur mon site en ligne, et comment nous avons reconstruit le générateur pour que cela n’arrive plus. J’ai essayé de l’écrire pour qu’il se comprenne sans connaître une ligne de code. Je vous raconte aussi les faux départs, parce que ce sont eux qui m’ont le plus appris.
Ce qui se passe vraiment chaque matin à 10 h 14
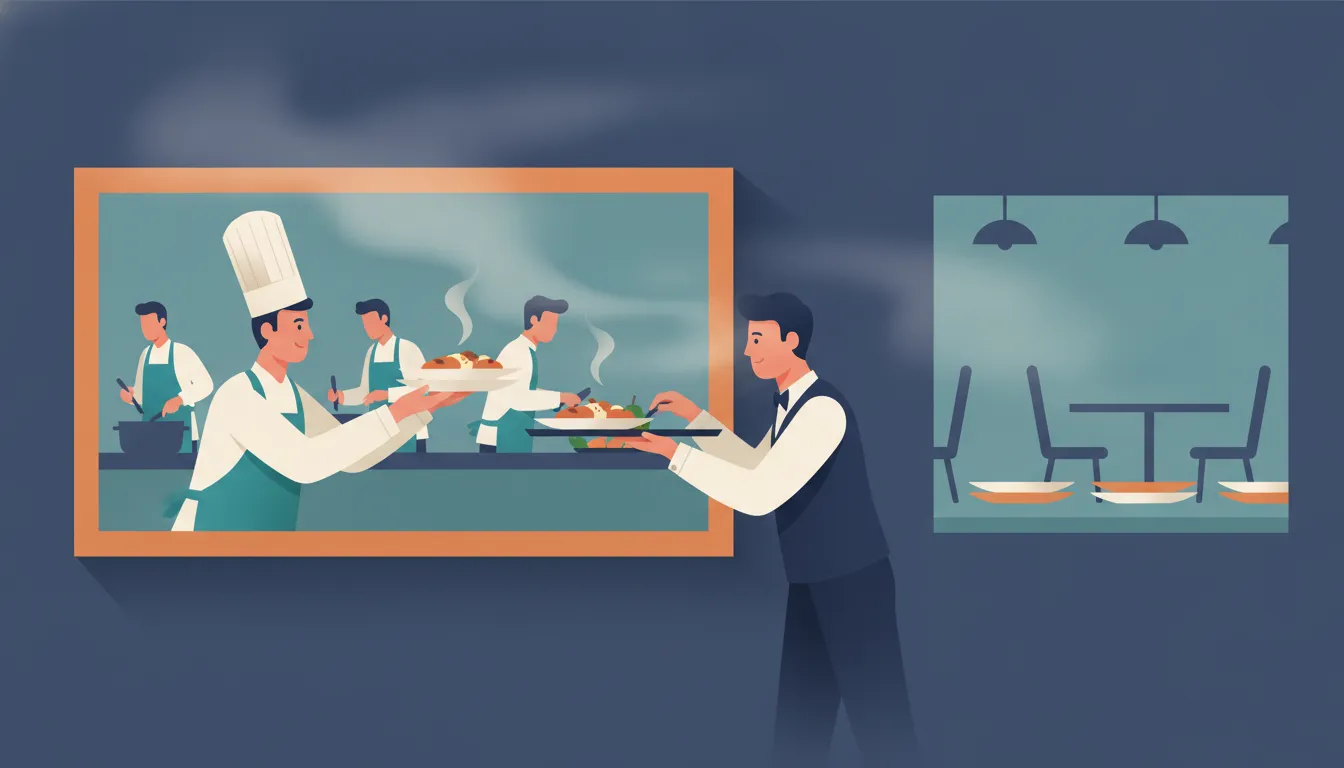
Pour comprendre ce qui a mal tourné, il faut regarder la cuisine. Imaginez un restaurant où un cuisinier très talentueux prépare les plats, où un serveur les découpe, les redresse et les dispose sur les assiettes, et où personne ne goûte rien avant que l’assiette n’arrive chez le client. Tant que tout se passe bien, le système est d’une efficacité redoutable. Dès qu’un maillon se trompe, l’erreur voyage jusqu’à la table sans que personne l’ait vue.
Voici, dans les grandes lignes, ce que faisait mon script chaque jour :
- Il parcourait les titres de quelques sites d’actualité sur le référencement et l’intelligence artificielle, puis demandait à Gemini de choisir un sujet nouveau.
- Il lui demandait un article de deux mille à deux mille cinq cents mots, en anglais, écrit dans un langage de balisage simple.
- Il faisait fabriquer trois images, une pour l’en-tête et deux pour le corps du texte.
- Il réclamait un titre et une description pour les moteurs de recherche.
- Il passait le texte dans une fonction de nettoyage, chargée de le transformer en page web propre.
- Il demandait ensuite trois traductions, en français, en espagnol et en italien, en consignant de ne rien changer à la mise en forme.
- Il déposait le tout sur le site, relayait les liens entre les langues grâce à un petit pont spécialement installé sur mon WordPress, et attendait le lendemain.
On remarque tout de suite ce qui manque : une étape pour regarder le résultat. Aucune relecture, aucun contrôle, aucune alerte si quelque chose ne ressemblait pas à un article fini.
Les premiers signes
Je lis les quatre langues, ce qui est à la fois un atout et une malédiction : je vois tout. Voici ce que j’ai remarqué d’abord, puis ce que l’audit allait confirmer :
- Les extraits de code avaient disparu ou arrivaient en lambeaux, y compris dans des articles techniques dont ils étaient le cœur.
- Des signes parasites traînaient dans le texte : des astérisques, des dièses, des émojis, des flèches dessinées avec des tirets.
- Certaines traductions s’arrêtaient au milieu d’une idée, parfois au milieu d’une phrase.
- En italien, la petite préposition « ai », qui signifie « aux », s’écrivait « AI », comme l’intelligence artificielle, des dizaines de fois.
- Des unités et des sigles perdaient leurs majuscules, des prix ne coïncidaient plus d’une langue à l’autre.
- Tous les articles visaient le même mot-clé principal, « Digital Strategy », ce qui est exactement ce qu’il ne faut pas faire en référencement.
Pris isolément, chacun de ces défauts se corrige en cinq minutes. Multipliés par vingt-deux sujets et quatre langues, ils formaient un chantier que je ne pouvais plus méconnaître. La situation était devenue critique : le blog d’une agence web, censé prouver notre sérieux, affichait ses propres défauts à chaque visiteur, dans quatre langues.
J’ai d’abord tenté de régler cela avec Gemini lui-même, en lui montrant le problème et en lui demandant de corriger son propre script. J’y ai passé beaucoup de temps, et j’en suis ressorti avec la sensation que chaque correction en créait une autre. C’est là que j’ai compris que je regardais peut-être dans la mauvaise direction.
Gemini n’était qu’à moitié coupable
Quand un plat arrive froid, on accuse le cuisinier. Parfois, c’est le serveur qui l’a oublié sur le passe. En lisant le script de bout en bout, Claude a déroulé la chaîne maillon par maillon, et le verdict m’a surpris : l’essentiel des dégâts ne venait pas de ce que Gemini avait écrit, mais de ce qui lui arrivait ensuite.
Le nettoyeur trop zélé
La fonction chargée de transformer le texte en page web avait une mission raisonnable : éviter que des morceaux de code ou des schémas mal formés ne polluent les articles. Pour cela, elle supprimait tout ce qui ressemblait à du code. Concrètement, elle effaçait chaque ligne contenant certains mots, comme « import » ou « class », et tout ce qui se trouvait entre trois guillemets inverses. Dans un article destiné à des débutants, le vrai code est l’exception. Dans un article technique, c’est la raison d’être du texte, et il disparaissait sans un message d’erreur.
La limite invisible
On demandait à Gemini de rédiger deux mille à deux mille cinq cents mots, mais le script lui accordait une enveloppe de réponse plafonnée à 8 192 « jetons », l’unité de mesure du texte pour une IA. C’est limite. Surtout, le script ne vérifiait jamais si la réponse avait été menée jusqu’au bout. Un texte coupé net était publié comme un texte fini.
La traduction en un seul coup
Les traductions étaient demandées d’un bloc, avec la consigne de conserver la mise en forme « exactement ». Aucune règle propre à chaque langue, aucun lexique des noms de marques à ne pas toucher, aucune convention de majuscules. Le résultat était fluide en surface, et plein de petites erreurs en profondeur, comme le fameux « AI » italien.
Des titres et des descriptions approximatifs
Le titre et la description pour les moteurs de recherche étaient extraits en cherchant le mot « title : » dans la réponse. S’il manquait, le script se rabattait sur un texte générique, le même pour tous. Le code coupait ensuite le titre destiné au référencement à cinquante caractères, quelle que soit la phrase.
Et ce que Gemini avait vraiment sur la conscience
Sa part n’est pas nulle. Quand on lui demande un article d’actualité, il lui arrive d’inventer un chiffre ou une caractéristique pour avoir l’air précis. Il aime les émojis, les listes à coches et les tableaux décoratifs. Mais ce sont des penchants, pas des pannes, et un bon système est conçu pour les encadrer.
La leçon
Un modèle de langage est un excellent rédacteur et un très mauvais contrôleur de lui-même. Ce que j’avais bâti ressemblait à une usine sans service qualité. Le problème n’était pas de trouver une meilleure IA. Il fallait changer l’architecture autour d’elle.
J’ai changé d’interlocuteur
Le jour où j’ai ouvert une conversation avec Claude, j’avais une demande en deux temps, et je l’ai formulée avec la franchise de quelqu’un qui n’en peut plus : Gemini ne me créait que des problèmes, j’avais trop galéré, et je voulais savoir deux choses. D’abord, ce qui n’allait pas dans mon script. Ensuite, et surtout, comment réparer tous les articles publiés depuis le 1er octobre, traductions comprises, avec la liste des identifiants à l’appui.
Je n’avais aucune garantie que cela marcherait. J’ai vite compris que la route serait longue, et pas seulement à cause du travail lui-même.
Premier obstacle : le site fermait la porte
Claude travaille dans un environnement informatique isolé, quelque part dans le cloud. Quand il a essayé d’interroger mon site, celui-ci a répondu par un refus. Rien de grave : c’est le comportement normal d’un site protégé. Mais l’autorisation d’accès se règle dans les paramètres de mon compte Claude, où il faut ajouter le nom de domaine de mon site à une liste de sites autorisés. J’ai répondu que je ne voyais pas l’option, parce que j’étais en formule gratuite. Dans la foulée, je suis passé à la formule Pro, et l’option est apparue.
Deuxième obstacle : les identifiants
Pour modifier des articles, il faut des droits d’écriture. Plutôt que de coller des mots de passe dans une conversation, je les ai regroupés dans un fichier de configuration sur mon ordinateur, que Claude a ensuite utilisé pour travailler, avec un accès spécifique que je peux révoquer à tout moment. Cette habitude est l’une des règles que je recommande à la fin de ce texte.
Troisième obstacle : le site ne répondait qu’à mon ordinateur
Même une fois le domaine autorisé, mon site continuait de se montrer méfiant envers l’environnement de Claude. La solution est venue d’un angle inattendu : mon propre ordinateur portable, que le site connaît et accepte. J’ai ouvert l’application de bureau de Claude, qui peut se relier à mon poste. Puis Claude a préparé pour mon PC un petit programme, une sorte de guichet, que je lance et qui exécute un par un les travaux qu’il lui dépose dans un dossier et lui renvoie les résultats. Claude écrit les instructions et les vérifie, mon ordinateur parle au site, et le résultat remonte.
Restait la seule question qui comptait vraiment : jusqu’où le laisser aller ? J’ai tranché sans nuance. Je voulais qu’il intervienne directement sur le site en ligne, qu’il publie ses corrections lui-même, et qu’il me démontre, plutôt que de me le promettre, qu’il était à la hauteur. J’ai ajouté que s’il lui fallait plus de puissance, il devait me le dire. Il n’en a pas eu besoin.
J’ai aussi posé une condition, que je repète volontiers à quiconque confie du travail à une IA : « à toi de vérifier ce que tu fais ». Elle a guidé chacune des étapes qui ont suivi.
L’audit : quatre-vingt-onze pages au peigne fin
Première décision, et elle m’a été imposée par le bon sens plus que par l’envie : ne réparer qu’après avoir mesuré. Je n’avais pas de liste fiable des défauts, seulement des impressions. J’ai donc demandé à Claude de lancer son propre audit, avec des données fraîches lues directement sur le site, sans se fier à celles que j’avais en main.
Un audit, c’est tout simplement une relecture méthodique, mais menée par une machine qui ne se fatigue pas. Pour chacune des pages, le programme comparait le titre, la structure des intertitres, les paragraphes, les listes, les tableaux, les blocs de code, les images, les liens, les informations destinées aux moteurs de recherche, la langue employée et la présence du bouton de contact. Quatre-vingt-huit pages se répartissaient en vingt-deux groupes de quatre langues. Trois autres traductions flottaient à part, sans parent officiel : des doublons d’un même article, que nous avons classifiés « orphelins ».
Quand ça ne répond pas
J’ai eu un moment de doute. Au bout d’un moment, j’ai écrit que le script que j’avais lancé me donnait l’impression de tourner dans le vide. Quelques minutes plus tard, j’ai corrigé : il tournait bel et bien, mais très lentement. La raison est simple et un peu humiliante pour l’impatience humaine : interroger quatre-vingt-onze pages, en plusieurs langues, plusieurs fois chacune, prend du temps, surtout quand le site prend soin de ne pas se laisser submerger.
J’ai alors posé la seule consigne qui vaille dans ce genre de situation. Je n’avais pas besoin que ce soit rapide. J’avais besoin que le résultat final soit parfait, et peu importait le temps que cela prendrait. Cette phrase a changé la manière de travailler : Claude a cessé d’optimiser la vitesse pour optimiser la fiabilité.
Ce que l’audit a révélé
Le constat n’avait rien de dramatique pris isolément, mais il était massif. Et il définissait le chantier : non pas retoucher trois phrases, mais reprendre chaque page selon des règles identiques, vérifier le résultat page par page, et ne jamais supposer que « ça doit être bon ».
Le chantier : travailler en direct sans casser le site
Il y a un moment, dans toute réparation, où l’on doit choisir entre prudence et efficacité. J’ai écrit à Claude que j’avais besoin d’aller me coucher et que je voulais qu’il travaille de manière autonome. Puis, quelques messages plus tard : « go ». Auditer, corriger et republier tous les articles créés depuis le 1er octobre, directement sur le site en ligne.
La phrase peut sembler téméraire. Confier à une IA l’écriture sur un site qui reçoit des visiteurs, sans relire chaque modification soi-même, est le genre de décision qui fait froid dans le dos. Ce qui l’a rendue raisonnable, ce n’est pas ma confiance. C’est le filet de sécurité que Claude a installé avant d’écrire la moindre ligne.
Le filet de sécurité
Pour chaque article, la procédure était toujours la même, dans cet ordre :
- Sauvegarder l’état actuel de la page, dans un fichier conservé sur mon ordinateur.
- Écrire la version corrigée sur le site.
- Relire ce que le site a réellement enregistré, et le comparer à ce qui était censé l’être.
- Ouvrir la page publique comme le ferait un visiteur : elle doit répondre, ne montrer aucun code technique par erreur, contenir les phrases attendues et afficher le bouton de contact.
- Revenir en arrière automatiquement, sans attendre mon avis, si l’une de ces vérifications échouait.
Avec ce dispositif, le pire scénario n’était plus une page cassée en ligne, mais une page refusée puis restaurée telle qu’elle était, avec un message d’erreur pour m’expliquer pourquoi.
Comment les pages étaient réparées
Claude ne retouchait pas les articles au hasard. Il reconstruisait chaque page à partir de son contenu, selon les mêmes règles pour toutes les langues : mise en forme nettoyée, code rétabli, casse corrigée, titres et descriptions réécrits, bouton de contact conservé, liens contrôlés. Puis un second jeu de contrôles, indépendant de la réparation, relisait le résultat. L’idée est la même que dans une équipe humaine : celui qui corrige n’est pas celui qui valide.
Les vagues
Le travail a avancé par vagues successives, de plus en plus fines. La première a traité quatre-vingt-sept pages : quatre-vingts ont franchi tous les contrôles du premier coup, sept ont été refusées puis corrigées. La deuxième a republié les quatre-vingt-onze pages avec des textes affinés, et toutes ont passé les contrôles. Une troisième a repris onze pages sur des détails restants. Mais le plus difficile restait à venir.
Pendant ce temps, les trois brouillons que je ne voulais surtout pas voir modifiés sont restés strictement intacts, comme convenu : le périmètre du chantier était fixé, et il a été respecté.
Le mystère des accolades
C’est la partie du récit que je préfère, parce qu’elle ressemble à une enquête policière, et parce qu’elle montre pourquoi on ne peut pas se contenter de « ça a l’air bon ».
Une fois les premières vagues passées, Claude a continué de regarder les pages publiques comme un visiteur, en particulier celles qui contenaient du code. Quelque chose clochait, de façon subtile. Certains extraits réussissaient tous les contrôles internes, mais s’affichaient de travers sur le site : des morceaux avaient disparu, d’autres s’étaient transformés.
Un détail technique, expliqué simplement
Sur une page web, certains caractères sont réservés : le signe « inférieur à » sert à ouvrir une balise. Pour l’afficher comme un simple symbole, on l’écrit sous une forme codifiée, une « entité », par exemple <. Le navigateur la lit, et affiche le signe. C’est un mécanisme très courant, et nous l’utilisions dans tous les blocs de code.
Première hypothèse : l’erreur venait de notre côté. Claude a donc écrit l’entité sous une forme renforcée, pour qu’elle survive à un décodage supplémentaire. Une vague entière a été republiée sur cette base. Les contrôles de l’époque ont été passés, ce qui prouve une chose : parfois, un contrôle ne mesure que ce qu’il a été conçu pour mesurer.
Car le symptôme persistait, et il avait une particularité troublante. Il n’apparaissait que dans les articles dont le code contenait des accolades, ces signes { et } qu’on trouve dans presque tous les fichiers de configuration. Les articles sans accolades se comportaient parfaitement bien.
Des expériences qui ne laissent aucune trace
Pour comprendre, Claude a fait ce que ferait un bon enquêteur : reproduire le phénomène dans des conditions contrôlées. Sur un seul article, il a posé une version d’essai, observé la page publique, puis restauré la version d’origine. Il a recommencé avec des variantes. Chaque test était réversible, chaque résultat a été noté.
Les conclusions tiennent en trois lignes :
- Quand un article contient une accolade, un filtre du site efface tout ce qui se trouve entre une accolade ouvrante et sa fermante, texte, configuration, exemples compris.
- Dans les mêmes articles, ce filtre décode une fois les entités, de sorte que
<title>devenait une vraie balise, invisible à l’écran. - Les articles sans accolades échappaient à tout cela.
Je n’ai pas pu identifier le coupable. Mon site fait tourner de nombreux plugins et extraits de code, et celui qui applique cette règle ne s’est pas dénoncé. Claude a passé en revue ce qui était lisible, sans rien modifier, sans trouver de piste claire. Il faudra y revenir, et je le note dans mes chantiers.
La solution : contourner plutôt que combattre
Plutôt que d’attendre de débusquer le filtre, Claude a cherché une écriture que le filtre ne reconnaît pas. Il a essayé plusieurs encodages d’accolades. Certains échouaient, d’autres fonctionnaient mais donnaient un résultat inutilisable. Un seul passait tous les tests : une entité nommée du langage de la page web, { pour l’accolade ouvrante et } pour la fermante. Le filtre ne les voit pas comme des accolades, et le navigateur les affiche exactement comme telles.
Il restait à l’appliquer. La sixième vague a réécrit les soixante-dix pages concernées, trois traductions orphelines comprises, avec cette convention, et chaque bloc de code a été comparé à sa source, signe pour signe, sur la page publique, avec retour arrière automatique au moindre écart. Résultat : soixante-dix réussites sur soixante-dix, aucun retour arrière.
Il y a eu un dernier détail curieux. Un plugin de maillage interne insère automatiquement des liens dans mes articles, y compris, par zèle, à l’intérieur des blocs de code. C’est inoffensif pour l’instant, mais ce n’est pas propre, et c’est maintenant dans la liste de ce que je vais faire exclure.
Vérifier pour de vrai
Une fois la dernière vague passée, la tentation était grande de proclamer la victoire. Claude a fait l’inverse : il a lancé un audit final sur les quatre-vingt-onze pages, avec une logique mise à jour pour tenir compte de la découverte des accolades. Le programme a examiné chaque page sous trois angles : ce que le site a enregistré, ce que le site transmet aux programmes qui l’interrogent, et ce qu’un visiteur voit réellement.
Le verdict est tombé : quatre-vingt-onze pages sur quatre-vingt-onze conformes. Chaque page répond, ne comporte qu’un seul titre principal, affiche le bon titre, la bonne description, le bouton de contact, aucun code technique visible par erreur, des intertitres et des paragraphes identiques à la source. Mille soixante-deux blocs de code, répartis sur soixante-quatorze articles, ressortent à l’identique sur les pages publiques. Quatre-vingt-deux liens différents ont été testés, un seul était vraiment mort et a été remplacé.
La fausse alerte qui en dit long
Le premier audit complet s’est pourtant soldé par un échec apparent : un des contrôles signalait quatre-vingt-quatre articles. Il comparait le contenu brut enregistré sur le site avec celui qui avait été envoyé, et trouvait des différences.
Plutôt que de déclarer l’alerte sans importance, Claude a cherché à comprendre. La cause était bénigne : le site réécrit lui-même les adresses des liens internes sous une forme plus courte, ce qui modifie le texte brut sans changer la page. Après avoir tenu compte de cette réécriture, les quatre-vingt-onze pages étaient bel et bien identiques à leur source.
L’important n’est pas le résultat final, mais la méthode : une alerte qu’on ne comprend pas ne se supprime pas, elle s’explique. C’est ce qui sépare un « terminé » vérifié d’un « terminé » déclaré.
Le chantier en chiffres
Pour les amateurs de chiffres, voici le bilan de cette réparation :
- 91 pages réparées : 22 sujets en quatre langues, plus 3 traductions orphelines.
- 1 062 blocs de code vérifiés un par un, répartis sur 74 articles.
- 82 liens différents testés, dont un seul était mort.
- 70 pages réécrites pour contourner le problème des accolades, sans un seul retour arrière.
- Plus de 30 règles de contrôle dans le nouveau générateur, et 10 tests automatiques qui ne touchent pas au site.
- 6 minutes environ pour produire, relier et vérifier quatre brouillons lors du test réel.
Reconstruire plutôt que rafistoler
Réparer quatre-vingt-onze pages ne résolvait rien si le lendemain à 10 h 14 le générateur en produisait une nouvelle fournée de défauts. Il fallait traiter la cause. Et la cause, nous l’avions vu, n’était pas un bogue à corriger mais une façon de concevoir : un système où un modèle écrit du texte libre, qu’un script nettoie à coups d’expressions régulières, sans que personne ne regarde le résultat.
Claude a proposé de ne pas rafistoler ce script, mais d’en écrire un nouveau, construit sur trois principes simples.
Trois principes
Demander une structure, pas un texte mis en page. Au lieu de réclamer un article en langage de balisage, que le script devrait ensuite nettoyer, on demande à l’IA de rendre l’article découpé en blocs identifiés : un paragraphe, un intertitre, une liste, un tableau, un bloc de code. Chaque bloc est vérifié un par un. Il n’y a plus rien à « nettoyer », donc plus rien à effacer par erreur.
Séparer l’écriture de la mise en page. L’IA n’écrit jamais une ligne de page web. Un programme classique, qui fait toujours la même chose de la même façon, transforme les blocs en pages au format de mon thème. Pour une bonne raison : une machine qui rédige est créative, donc variable. Une machine qui met en page doit être ennuyeuse, donc fiable.
Ne jamais publier sans contrôle. Entre la rédaction et le site s’intercale une inspection qualité indépendante, qui peut bloquer l’opération.
Le parcours d’un article aujourd’hui
- Choix du sujet. Le programme consulte les articles déjà publiés, ainsi que les brouillons, et leurs mots-clés, afin de ne jamais se concurrencer lui-même. Par défaut, il choisit un sujet durable plutôt qu’un sujet d’actualité, parce que les faits d’actualité sont ceux qu’une IA invente le plus volontiers.
- Rédaction en anglais, sous forme de blocs, avec un mot-clé principal précis.
- Contrôle qualité. Une trentaine de règles, dont chacune correspond à un défaut réellement rencontré dans les pages réparées : texte coupé en fin d’article, émojis, restes de mise en forme, unités sans majuscule, « AI » dans un texte non anglais, langue douteuse, mot-clé absent du premier paragraphe, code invalide, lien vers un article inexistant. S’il y a une erreur, une correction ciblée est demandée, deux fois au plus.
- Adaptation en français, espagnol et italien. Pas une traduction mot à mot : une adaptation, avec un guide de style par langue, une liste de noms de marques qui ne se traduisent pas, et l’obligation de conserver exactement la même structure. Les blocs de code ne sont jamais retraduits : ils sont simplement recopiés depuis l’original.
- Deuxième contrôle, langue par langue, avec en plus une comparaison avec la version anglaise.
- Mise en page, par le programme, et fabrication des images.
- Dépôt en brouillons sur le site, liaison des quatre langues, relecture de chaque brouillon pour s’assurer que le site a bien enregistré ce qui devait l’être.
- Rapport, dans un fichier, avec tout ce qui s’est passé et tout avertissement.
Si une étape bloque, rien n’est créé. Mieux vaut pas d’article du tout qu’un article abîmé.
Quatre langues, quatre façons de se tromper
Dire « on traduit en trois langues » donne l’impression d’un travail mécanique. C’est faux, et c’est l’une des raisons pour lesquelles l’ancien script se trompait si discrètement : chaque langue a ses pièges, et ils se cumulent.
En français, l’intelligence artificielle s’écrit « IA » et non « AI », les deux-points, les points d’interrogation et les guillemets français se détachent du mot par une espace, et un titre ne prend de majuscule qu’à son premier mot et aux noms propres. L’espagnol et l’italien emploient eux aussi le sigle « IA ». En italien, « ai » est de surcroît un mot du quotidien, une préposition : c’est précisément celui que l’ancien script transformait en « AI », trente-cinq fois. En espagnol, le bouton de contact a dû passer au tutoiement pour s’aligner sur le ton du reste du site.
Partout, d’autres règles s’appliquent : les noms de marques et de produits ne se traduisent jamais, les unités de mesure ont une casse qui compte (un kW n’est pas un kw), et le mot-clé principal doit sonner naturellement dans chaque langue au lieu d’être traduit à la lettre. Aucune de ces règles n’existait dans l’ancien script. Le nouveau donne à chaque langue son guide de style, son lexique de marques et ses propres contrôles. Ce travail est invisible quand il réussit, et c’est précisément le but.
Les garde-fous
Le nouveau programme s’arrête seul au bout de quatre-vingt-dix minutes. Il refuse de se lancer deux fois en même temps. Il ne crée qu’un article par jour. Il tient un journal. Il s’appuie sur dix tests automatiques qui vérifient son comportement sans toucher au site, y compris un faux site qui simule les pannes. Enfin, les mots de passe ne sont plus écrits dans le code mais rangés dans un fichier à part.
Le piège caché de 10 h 14
Le nouveau générateur existait, il passait ses tests, il avait même réussi un essai à blanc avec le vrai Gemini. Restait à le brancher sur ma tâche planifiée, et c’est là que j’ai demandé à Claude de s’assurer que le fichier principal de mon script, celui que Windows lance chaque jour, était parfait pour générer les prochains articles. Le geste méritait mieux qu’un simple copier-coller, et Claude a découvert deux choses.
Une pause qui ne finissait jamais
La première : ma tâche, nommée « Rédaction post lcwa », lançait un petit fichier de démarrage dont la dernière ligne contenait une commande « pause ». Elle attend qu’on appuie sur une touche, ce qui est pratique quand on lance le script à la main et qu’on veut lire le résultat. Mais dans une tâche automatique, plus personne n’est là pour appuyer.
Résultat : le script avait fini son travail en quelques minutes, mais la tâche restait affichée comme « en cours ». Or Windows, par défaut, refuse de lancer une nouvelle exécution tant que la précédente n’est pas terminée. Le déclenchement du lendemain aurait donc été ignoré sans bruit. Pas d’erreur, pas d’alerte, simplement un article qui ne serait jamais venu.
Claude a supprimé la commande, mis un fichier de lancement séparé pour mes essais manuels, et terminé l’exécution restée bloquée depuis le matin. La tâche est repassée à l’état « prête », avec sa prochaine exécution programmée le lendemain à 10 h 14.
Un brouillon encore à l’ancienne
La seconde découverte m’a fait sourire jaune. L’exécution du matin avait eu lieu avec l’ancien script, et elle avait donc créé quatre brouillons dans les quatre langues, avec tous les anciens défauts. Ils n’étaient pas publiés, ce qui les rendait inoffensifs, mais ils m’ont rappelé à quel point le calendrier d’un processus automatique ne s’arrête pas parce qu’on répare quelque chose.
Le test réel
Pour vérifier, il n’y a pas de substitut à un vrai essai. Avant d’y arriver, un premier contrôle de connexion avait d’ailleurs échoué, de façon instructive : Claude avait demandé à Gemini une réponse minuscule pour tester le lien, et le modèle avait épuisé son budget de réponse à réfléchir sans rien écrire. Le nouveau programme a détecté cette sortie interrompue au lieu de la laisser passer. C’est exactement ce que l’ancien script n’aurait jamais fait.
Le test réel a ensuite eu lieu sur le site, en brouillon. Le programme a choisi un sujet, « The Essential Website Maintenance Checklist for Small Businesses », a rédigé l’article, l’a adapté dans les trois autres langues sans erreur bloquante, a fabriqué les images et a déposé les quatre brouillons, reliés entre eux. L’ensemble a duré environ six minutes.
Puis un audit indépendant a relu les quatre brouillons sur le site : titres, descriptions, image à la une, deux images dans le texte avec leurs textes alternatifs, quatre liens internes pointant vers des articles publiés de la bonne langue, bouton de contact, structure identique à ce qui avait été envoyé. Aucun problème. Une relance immédiate du programme a, elle, été refusée aussitôt : un article avait déjà été créé ce jour-là, et la protection anti-doublon a fait son travail.
Ce que l’IA ne fait pas à ma place
Le rapport que Claude m’a remis à la fin de la réparation contient une rubrique entière intitulée « Décisions qui vous reviennent ». Elle dit beaucoup du partage des rôles. Une machine peut vérifier qu’un lien fonctionne, qu’un morceau de code est intact, qu’un titre est identique à sa source. Elle ne peut pas décider de ce que mon agence veut raconter, ni des risques qu’elle accepte de courir. Voici ce qui est resté sur ma table.
Les décisions éditoriales
Les doublons. Trois traductions « orphelines » (en français, en espagnol et en italien) sont des doublons de faible qualité d’un article sur les méta-descriptions, déjà présent sur le site. Claude les a nettoyées et republiées, mais il m’a prévenu que le plus propre serait de les rediriger vers l’article principal ou de les retirer. Garder, rediriger ou dépublier : c’est une décision de référencement, donc une décision de patron.
L’actualité. Parmi les articles de Gemini, certains commentaient l’actualité de grandes marques : un constructeur automobile, des plateformes de streaming, des géants du numérique. Ils contiennent des chiffres et des affirmations que personne n’a vérifiés à la source, et Claude m’a recommandé une relecture humaine des faits. Ces sujets sont aussi très éloignés de mon métier, ce qui ramène à une question plus simple : ai-je vraiment besoin d’en parler ?
La concurrence entre mes propres articles. Plusieurs articles visent des mots-clés très proches (les méta-descriptions, les titres générés par IA, le contenu écrit par IA). Quand deux pages d’un même site répondent à la même recherche, Google doit choisir, et il ne choisit pas toujours celle que l’on aurait préférée. Fusionner, différencier ou pousser l’un des deux : à moi d’arbitrer.
Les titres et les images. Une fois le nom de l’agence ajouté, 90 titres sur 91 dépassent soixante caractères, et Google risque de les couper dans ses résultats. Dans une image fabriquée par l’IA, un mot est mal orthographié ; dans un autre article, une image manque. Ce sont des défauts mineurs, mais ils engagent l’image de l’agence : je choisis comment les traiter.
Publier ou ne pas publier
Le nouveau générateur dépose ses articles en brouillon, comme l’ancien. Une option permettrait de les publier tout seuls quand tous les contrôles sont au vert ; je ne l’ai pas activée, et les sujets d’actualité, eux, resteraient de toute façon en brouillon. Un seul essai complet avec de vrais articles ne suffit pas pour confier la vitrine de l’agence à un automatisme. Je déciderai après avoir observé plusieurs jours de production.
Ce qui reste imparfait
Je préfère être honnête sur ce qui n’est pas réglé. Le filtre du site qui supprimait tout ce qui se trouvait entre accolades est contourné, mais pas expliqué : nous savons à quoi il ressemble et comment l’éviter, pas quel élément du site l’applique. C’est comme éponger une fuite sans avoir trouvé le tuyau. Un module de maillage interne insère par ailleurs des liens dans des blocs de code, où ils n’ont rien à faire ; c’est sans gravité, mais cela reste à régler. Enfin, par hygiène, quelques accès au site doivent être renouvelés. C’est un travail de sécurité, il m’incombe, et Claude s’est d’ailleurs abstenu d’y toucher : je n’en dirai pas davantage ici.
Rien de tout cela n’est un échec de l’IA. Le jour où un assistant vous annonce que tout est parfait, il est temps de se méfier. Celui-ci m’a remis la liste de ce qui ne l’est pas.
Mode d’emploi : dix règles pour automatiser un blog avec une IA sans se faire piéger
Si vous gérez un blog, même modeste, et que vous envisagez de confier une partie du travail à une IA, voici ce que cette aventure m’a appris. Ce ne sont pas des principes théoriques : chacune de ces règles correspond à un incident réel de ce récit.
- Ne publiez jamais sans que personne n’ait regardé. Mon générateur publiait chaque matin sans aucun contrôle humain. Il a fallu un audit complet pour mesurer l’ampleur des dégâts. Un brouillon coûte une minute de relecture ; un article cassé en ligne coûte la confiance des lecteurs.
- Séparez l’écriture, la mise en forme et le contrôle. L’IA rédige, un programme prévisible fabrique la page, un troisième étage vérifie. Quand un seul outil fait tout, il se contrôle lui-même, et ce n’est pas un contrôle.
- Demandez une structure, pas un texte déjà mis en forme. Au lieu de réclamer un article à convertir après coup, on demande des blocs identifiés (titres, paragraphes, listes, tableaux, code) que le programme assemble lui-même.
- Transformez chaque défaut en règle. Le petit mot italien « ai » devenu le sigle « AI » à trente-cinq endroits n’a pas seulement été corrigé : il a donné naissance à un contrôle automatique. Le générateur en applique aujourd’hui plus de trente.
- Testez en vrai, mais de façon réversible. Avant chaque modification du site en ligne, une sauvegarde ; après, une relecture et un retour automatique en arrière si quoi que ce soit cloche.
- Vérifiez comme un visiteur, pas comme un développeur. Regarder ce que contient la base de données ne suffit pas : il faut ouvrir la page publique. C’est en comparant ce que le site affichait réellement à ce que nous lui avions envoyé que le mystère des accolades est apparu.
- Commencez par des brouillons. Ils laissent le droit de se tromper, et la dernière minute pour rattraper une erreur.
- Surveillez les textes coupés. Une IA peut s’arrêter au milieu d’une phrase sans prévenir. Le générateur vérifie maintenant que chaque réponse s’est terminée normalement, et refuse un article qui ne se termine pas proprement.
- Préférez les sujets durables, et vérifiez les faits. Un guide pratique vieillit bien. Un article d’actualité exige des chiffres exacts, qu’une IA invente parfois avec un aplomb parfait.
- Gardez vos mots de passe hors du code, et exigez des traces de ce que font vos tâches automatiques. Les accès sont désormais dans un fichier à part. Et chaque passage laisse un journal et un code de sortie lisibles, car c’est une simple pause oubliée au bout d’un fichier de lancement qui avait bloqué la tâche du matin.
Aucune de ces règles n’est réservée aux développeurs. Elles reviennent toutes à la même idée : faire en sorte que l’erreur soit visible avant qu’elle n’atteigne le lecteur.
Une mémoire pour la suite
Dernière demande de cette série, et pas la moindre : j’ai demandé à Claude de conserver une mémoire de tout ce que nous avons fait, afin d’y puiser chaque fois que nous créerons de nouveaux articles. Un article de plus ne repart ainsi pas de zéro : il hérite de ce que les précédents ont appris à ce site.
Concrètement, cette mémoire retient cinq choses :
- les règles éditoriales apprises à la dure (les majuscules italiennes, le tutoiement espagnol, les marques qu’on ne traduit pas) ;
- l’organisation du générateur et de ses fichiers ;
- le fonctionnement de la tâche de 10 h 14, et ses pièges ;
- l’historique des incidents, avec leur cause ;
- la liste de ce qui reste à décider.
Elle ne contient en revanche ni mot de passe ni clé : ces secrets n’ont rien à faire dans une mémoire. L’habitude vaut pour n’importe quel projet. Après un chantier, demandez à votre assistant de consigner ce qu’il faut retenir : quinze jours de tâtonnements deviennent alors un savoir-faire, au lieu de rester un souvenir.
Ce qui a changé depuis le 1er octobre
Le 1er octobre, j’avais un blog qui publiait chaque jour grâce à un script que je croyais sous contrôle. Le 15, j’ai quatre-vingt-onze pages auditées et réparées une à une, vérifiées sur le site en ligne comme le ferait un visiteur ; un générateur entièrement reconstruit ; une tâche planifiée qui ne reste plus bloquée ; et un premier essai réel qui a produit quatre brouillons liés en quatre langues, contrôlés avant même que je les ouvre.
Le point à retenir : Gemini écrit toujours les articles du matin. Ce qui a changé, ce n’est pas le nom du modèle : c’est tout ce qu’il y a autour. Une structure imposée, un assemblage prévisible, des contrôles qui bloquent, des brouillons, un journal, des sauvegardes. Je n’ai pas appris que telle IA est meilleure que telle autre. J’ai appris qu’une IA se pilote comme n’importe quel collaborateur : on lui explique ce qu’on attend, on vérifie ce qu’elle rend, et on met en place le système qui permet de rattraper l’erreur.
J’ai aussi appris à demander. Ce qui m’a vraiment servi, c’est d’exiger une analyse détaillée avant d’agir, une vérification réelle ensuite, et un rapport qui dit ce qui reste à faire. Le résultat est meilleur, mais surtout, je sais maintenant pourquoi il l’est.
C’est le genre de rigueur que j’essaie d’apporter aux projets de mes clients : sites web, automatisations, contenus. Si vous avez un blog qui publie tout seul et que personne n’a jamais relu en entier, ou si vous voulez automatiser sans perdre la main, parlons-en. Nous regarderons ensemble ce qui est solide, ce qui l’est moins, et ce qu’il convient de faire en premier.
Demain à 10 h 14, un nouvel article sera généré. Il m’attendra en brouillon, et c’est très bien ainsi.
Annexe : petit lexique pour ne pas se perdre
Quelques mots reviennent dans ce récit. Les voici, sans jargon.
- Script : un petit programme, ici écrit en Python, qui exécute une suite d’instructions sans intervention humaine.
- Tâche planifiée : un réveil pour ordinateur. Windows lance le programme à l’heure dite, que quelqu’un soit devant l’écran ou non.
- Gemini, Claude : deux assistants d’intelligence artificielle, le premier créé par Google, le second par Anthropic.
- Jeton (token) : l’unité de mesure du texte pour une IA, à peu près un morceau de mot. La longueur d’une réponse se plafonne en jetons.
- WordPress, Avada, WPML : WordPress est le logiciel qui fait tourner mon site ; Avada, son thème, c’est-à-dire son apparence ; WPML, le module qui gère les versions en plusieurs langues et relie chaque page à ses traductions.
- Plugin : un module qu’on ajoute à WordPress pour lui donner une fonction supplémentaire (référencement, traduction, liens internes…).
- Brouillon : un article enregistré sur le site mais invisible du public, en attente de relecture.
- Balisage (HTML, Markdown) : le HTML est le langage des pages web. Le Markdown est une écriture simplifiée, avec des astérisques et des dièses, qu’on convertit ensuite en HTML ; quand la conversion échoue, ces signes restent visibles dans le texte.
- Entité : une manière d’écrire un caractère réservé dans une page web. Le signe « inférieur à » s’écrit
<. - Expression régulière : une formule de recherche et de remplacement, très puissante et très fragile, que l’ancien script utilisait pour « nettoyer » le texte.
- Référencement (SEO) : l’ensemble des pratiques qui aident une page à apparaître dans les résultats de Google.
- Mot-clé principal : l’expression qu’une page cherche à positionner dans les résultats. Quand deux pages visent la même, elles se font concurrence : c’est la cannibalisation.
- Audit : une relecture méthodique et chiffrée, ici menée par un programme.
- Code de sortie : le petit nombre qu’un programme renvoie en se terminant, zéro si tout s’est bien passé, autre chose sinon. C’est ce qui permet à une tâche automatique de signaler un échec.
- Retour arrière : le retour automatique à la version précédente d’une page quand une vérification échoue.
Un mot vous manque ? Dites-le-moi, et je l’ajouterai à ce lexique.
Prêt à propulser votre infrastructure digitale ?
Ne laissez pas les freins techniques ralentir votre croissance. Discutez de votre projet autour de Quand mon générateur a cassé 91 pages : le récit d’une réparation directement avec nos experts seniors chez Low Cost Web Agency.